


Python标准库包含哪些模块?核心功能全景解析
全面解析Python标准库的核心模块划分与典型应用场景,涵盖系统交互、数据结构、持久化存储、网络通信与并发编程,结合架构图与决策流程帮助开发者高效选用原生工具。
Python之所以被称为“开箱即用(Batteries Included)”的编程语言,核心就在于其随解释器一同打包分发的庞大标准库。无需执行 pip install,开发者就可以直接通过 import 获得文件系统控制、网络交互、数据持久化、复杂数学运算与并发调度等完整能力。本文将全面梳理Python标准库的顶层分类,剖析关键高频模块的用法与设计逻辑,并通过场景选型指南帮助你在开发中优先发挥原生库的最大价值。
一、Python标准库的顶层架构分类
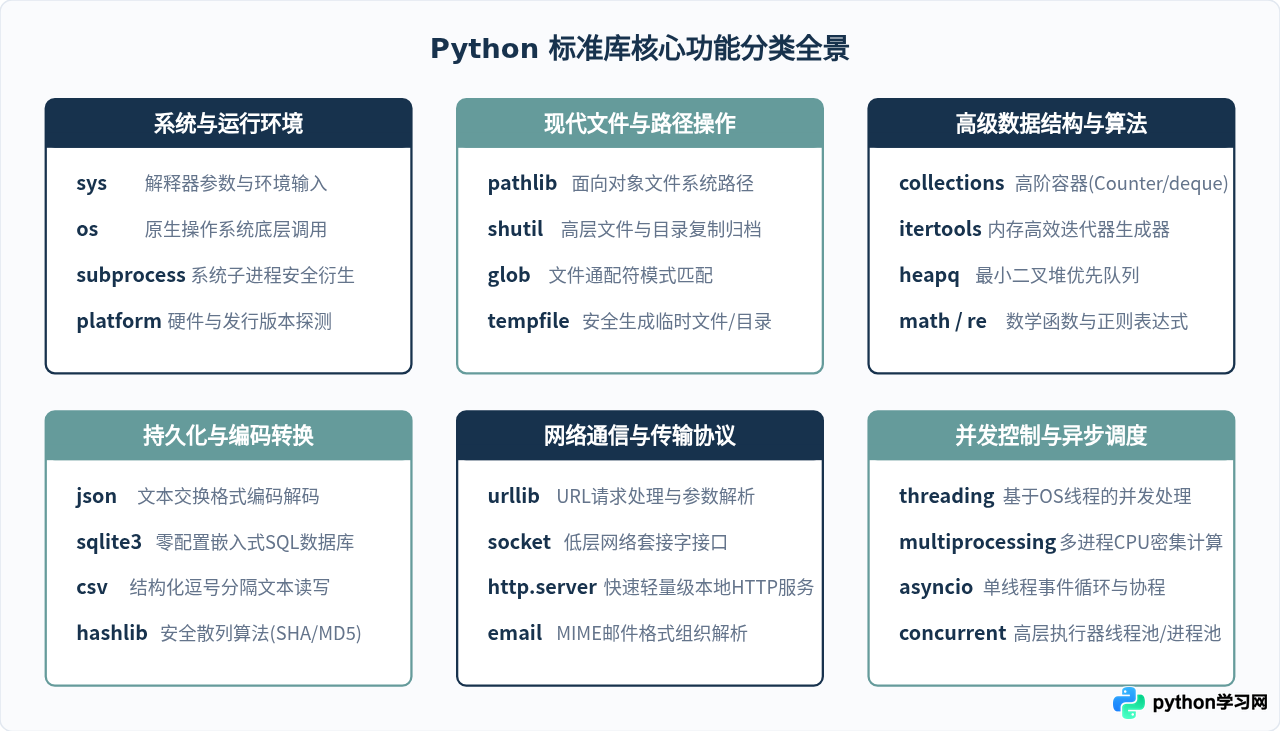
Python标准库包含数百个模块,覆盖了从底层硬件系统交互到高级文本处理的各类任务。为了在工程设计中形成系统化的认识,我们可以将核心库划分为六大核心功能领域:
- 系统交互与执行环境:管理操作系统接口、命令行参数、环境变量与外部子进程。代表模块包括
os、sys、subprocess、platform。 - 现代文件与路径操作:负责磁盘路径抽象、临时文件生成与文件批量归档。代表模块包括
pathlib、shutil、tempfile、glob。 - 数据结构与算法工具:扩展内置序列与映射类型,提供高性能迭代与数学逻辑。代表模块包括
collections、itertools、heapq、bisect、math。 - 持久化与序列化存储:解决数据结构在内存与存储介质之间的转换。代表模块包括
json、csv、sqlite3、pickle。 - 网络通信与协议解析:提供底层网络套接字以及HTTP、URL、邮件格式的编码解析。代表模块包括
urllib、http.server、socket、email。 - 并发控制与异步调度:在多线程、多进程与协程环境下实现高效调度与资源同步。代表模块包括
threading、multiprocessing、asyncio、concurrent.futures。
二、常用模块的使用逻辑与典型场景
1. 系统交互与执行环境(sys 与 subprocess)
编写工具脚本或后端服务时,与外部宿主环境的交互是第一道关卡。sys 模块提供了对Python解释器内部状态的访问,最常用的属性是命令行参数列表 sys.argv、当前Python模块查找路径 sys.path 以及终止程序运行的 sys.exit()。
当需要调用外部操作系统命令时,现代Python规范推荐使用 subprocess.run() 代替陈旧的 os.system()。subprocess 能够捕获标准输入输出,并提供严格的参数切分,有效防止Shell命令注入:
import subprocess

# 推荐:以列表形式传递命令与参数,明确捕获输出并检查退出码
result = subprocess.run(
    ["git", "status", "--short"],
    capture_output=True,
    text=True,
    check=True
)
print("Git工作区状态:", result.stdout)
2. 文件系统抽象:从 os.path 演进到 pathlib
在早期Python版本中,路径拼接依赖 os.path.join(),判断文件存在依赖 os.path.exists()。这种基于字符串拼接的方式不仅繁琐,且在跨平台时容易因斜杠方向出现逻辑疏漏。
Python 3.4引入的 pathlib 模块采用面向对象的方式封装了路径实体。一个 Path 对象既包含了路径的各级组成部分,也集成了读写文件、创建目录和模式查找的方法:
from pathlib import Path

# 获取当前脚本所在目录并构建子路径
base_dir = Path(__file__).resolve().parent
config_file = base_dir / "config" / "settings.json"

# 检查存在性并直接读取文本内容
if config_file.exists():
    raw_content = config_file.read_text(encoding="utf-8")
    print("读取配置文件成功,字符数:", len(raw_content))

# 遍历目录中所有扩展名为 .log 的文件
log_dir = base_dir / "logs"
log_dir.mkdir(parents=True, exist_ok=True)
for log_path in log_dir.glob("*.log"):
    print("日志文件:", log_path.name)
3. 高阶容器与高效迭代(collections 与 itertools)
标准库中的 collections 提供了对内置 dict、list、set 和 tuple 的有力补充:
Counter:用于快速对可哈希元素进行频率统计,无需手动编写字典累加判断。defaultdict:为缺失的键自动提供默认初始值,避免在嵌套字典构造时频繁调用setdefault()。deque:双端队列,支持两端以 O(1) 的时间复杂度进行插入和弹出,非常适合实现滑动窗口与任务缓冲队列。
与之配合的 itertools 则提供了一组在内存中按需生成元素的迭代原语,例如 chain() 串联多个序列、islice() 对迭代器进行切片、以及 groupby() 按条件对有序数据进行分组。这在处理超大规模日志流时能够大幅度削减内存开销。
三、数据持久化与格式解析:边界与安全机制
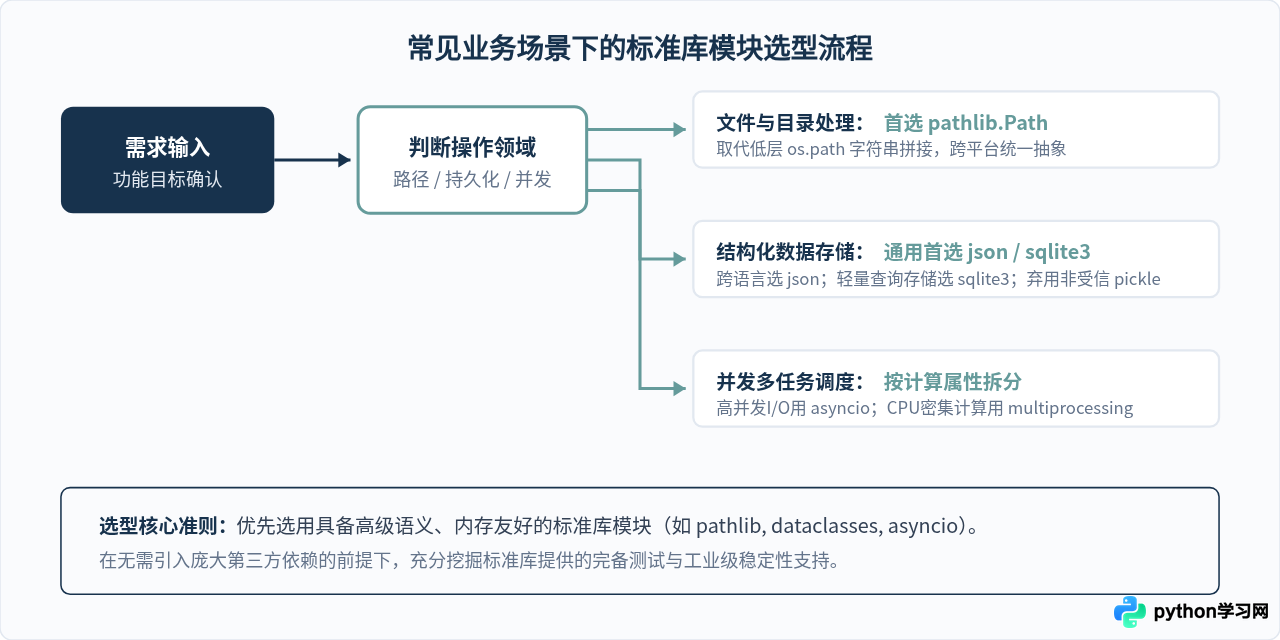
标准库提供了应对各种数据格式的工具,但在实际使用中,开发者必须清晰认识到不同格式的应用边界与安全隐患。
1. JSON 与 CSV:通用的结构化文本
json 模块是Web API交互和配置文件存储的标准方案。使用 json.loads() 解析字符串,使用 json.dumps() 序列化为文本。需要注意的是,原生 json 仅支持 dict、list、str、int、float、bool 和 None,遇到 datetime 或自定义类对象时,需要编写自定义继承自 json.JSONEncoder 的编码器。
2. sqlite3:无需部署的完备SQL引擎
许多单机工具或轻量后端为了避免搭建独立数据库,往往使用本地文件记录状态。sqlite3 模块直接将 SQLite 数据库引擎内嵌在Python运行时中,支持标准SQL语法、ACID事务控制与参数化防SQL注入查询,是轻量化存储的最佳选择。
3. pickle 的核心用途与高危警示
pickle 能够将几乎任意Python对象(包括类实例、函数指针)序列化为二进制流。然而,pickle.loads() 在反序列化时允许执行任意Python操作码。绝对不要使用 pickle 反序列化来自不信任网络或用户输入的数据,否则将直接导致远程任意代码执行(RCE)漏洞。
四、并发机制三剑客:threading、multiprocessing 与 asyncio
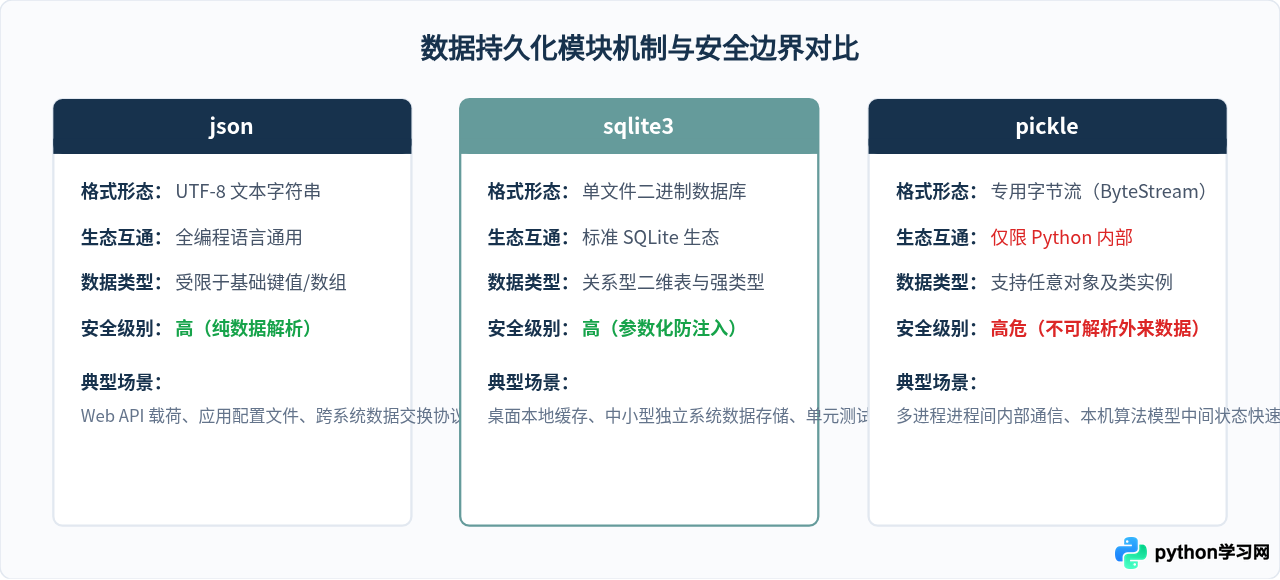
由于全局解释器锁(GIL, Global Interpreter Lock)的存在,在CPython解释器中,同一时刻只有一个原生线程在执行Python字节码。针对不同的计算任务,标准库设计了三种针对性的并发解决路径:
| 并发模块 | 底层模型 | GIL 限制影响 | 核心适用场景 |
|---|---|---|---|
| threading | 操作系统的原生线程 | 受GIL限制,无法利用多核加速CPU计算 | 网络请求等待、磁盘日志写入等I/O阻塞型任务 |
| multiprocessing | 独立的子进程 | 每个进程拥有独立GIL,完全利用多核 | 图像渲染、矩阵计算、音视频转码等CPU密集任务 |
| asyncio | 单线程异步事件循环(协程) | 单线程执行,彻底消除线程上下文切换开销 | 高并发Socket长连接、轻量网络爬虫、异步API代理 |
对于大部分需要多任务执行但逻辑较为单一的场景,标准库还提供了高度封装的 concurrent.futures 模块。它将底层细节统一抽象为 ThreadPoolExecutor 和 ProcessPoolExecutor,开发者只需编写统一的 executor.map() 即可快速切换底层运行模型。
五、探索标准库的有效工具与版本演进规律
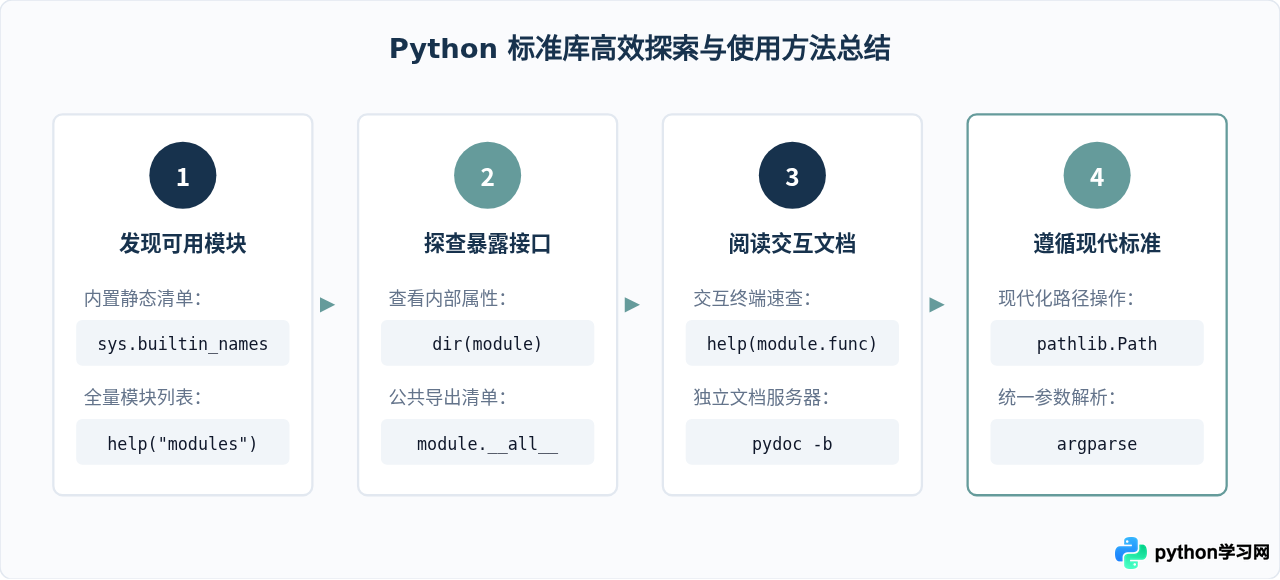
掌握标准库不仅是记住模块名字,更重要的是掌握自给自足的探索方法:
- 探查内置模块:在交互式Shell中,
sys.builtin_module_names记录了编译在解释器核心里的C模块;而通过help("modules")可以列出当前环境可用的全部安装模块。 - 快速查看导出符号:使用
dir(module)或检查module.__all__,可以直观看到模块暴露的核心函数与类。 - 即时阅读文档与签名:无需切出终端打开浏览器,直接在终端执行
help(module.function)或使用命令行python -m pydoc module即可查阅权威文档。
distutils;命令行解析领域 argparse 早已彻底取代老旧的 optparse 与 getopt;动态导入领域 importlib 完全替代了过时的 imp。在编写新代码时,应始终以官方最新文档推荐的标准写法为准。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















