


Python标准库模块分类清单与核心功能速查

Python被称为自带电池(Batteries Included)的编程语言,其强大的标准库让开发者在不安装任何第三方依赖的情况下,即可处理文件解析、系统调用、数据运算与高并发网络通信。然而,标准库包含超过200个模块,功能广泛且部分模块存在历史演进与替代关系。本文将Python标准库系统梳理为九大核心业务分类,提炼每个分类下的高频关键模块与推荐用法,帮助你在开发中快速做出准确的库选型决策。
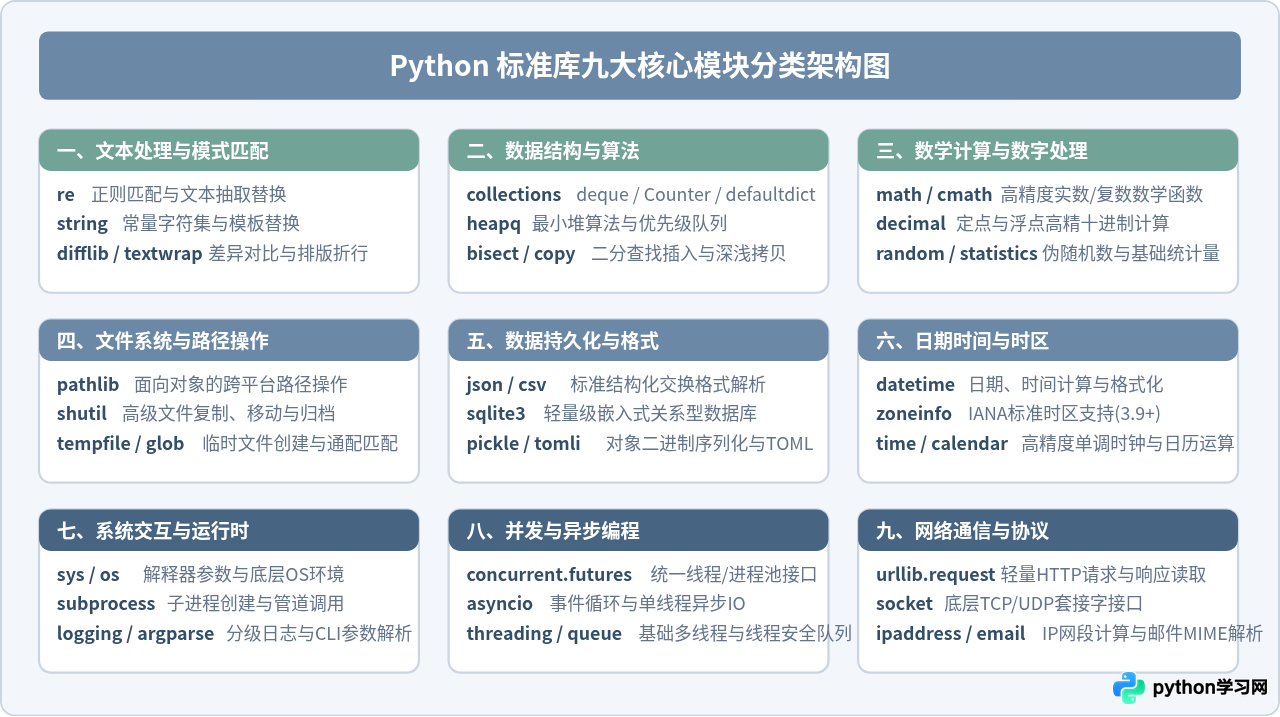
一、文本处理与模式匹配
字符串操作是日常编码中最基础的任务。对于常规的切分、去空和大小写转换,直接使用内建的 str 方法效率最高。当逻辑涉及模式抽取、格式比对与长文本格式化时,标准库提供了完备的专门工具:
| 模块名 | 核心能力 | 典型应用场景 | 高频函数 / 类 |
|---|---|---|---|
re |
基于PCRE语法的正则表达式引擎 | 提取指定规则数据、复杂分割、敏感词过滤替换 | compile(), search(), findall(), sub() |
string |
预定义字符集常量与安全模板字符串 | 密码字符集构造、安全模板渲染(防注入) | ascii_letters, digits, Template |
difflib |
序列与文本的差异比对 | 生成类似git diff的补丁差异、拼写模糊纠错 | unified_diff(), get_close_matches() |
textwrap |
文本换行、缩进与段落填充 | 命令行帮助信息排版、日志格式化折行 | wrap(), fill(), dedent() |
实用示例:正则提取与安全模板
import re
from string import Template

# 1. 预编译正则提高循环执行效率
LOG_PATTERN = re.compile(r"\[(?P<level>\w+)\]\s+(?P<msg>.*)")
match = LOG_PATTERN.search("[ERROR] Database connection failed")
if match:
    print(match.group("level"))  # 输出: ERROR
    print(match.group("msg"))    # 输出: Database connection failed

# 2. 安全模板渲染,无需担心常规format中的属性注入风险
tpl = Template("尊敬的用户 $user,您的验证码为 $code")
text = tpl.safe_substitute(user="张三", code="892341")
print(text)
二、高效数据结构与算法
Python的 list 与 dict 已经足够强大,但在双端队列、高频计数、默认初始化和优先级堆等特定算法场景中,标准库提供了针对性优化的高性能数据结构。
collections.deque:双端队列。在首尾插入或弹出的时间复杂度均为 O(1),而普通list.pop(0)是 O(N)。非常适合滑动窗口、任务队列与缓存淘汰机制。collections.Counter:专用于计数的字典子类,一行代码统计词频并支持most_common(n)排名。collections.defaultdict:避免频繁的key in dict校验或繁琐的setdefault。heapq:在常规列表上维护二叉堆结构,提供 O(log N) 的入堆出堆,获取 Top-K 数据无需将全量数据排序。bisect:在已有序的列表中执行二分查找与就地插入,适合分段区间映射(如分数定级)。
from collections import deque, Counter, defaultdict
import heapq
import bisect

# 1. 限制长度的双端队列(保留最新100条日志)
recent_logs = deque(maxlen=100)

# 2. 词频统计
counts = Counter(["apple", "banana", "apple", "orange", "banana", "apple"])
top1 = counts.most_common(1)  # [('apple', 3)]

# 3. 分数定级(二分查找)
scores = [60, 70, 80, 90]
grades = ['不及格', '及格', '中等', '良好', '优秀']
def get_grade(score):
    idx = bisect.bisect_right(scores, score)
    return grades[idx]

print(get_grade(85))  # 输出: 良好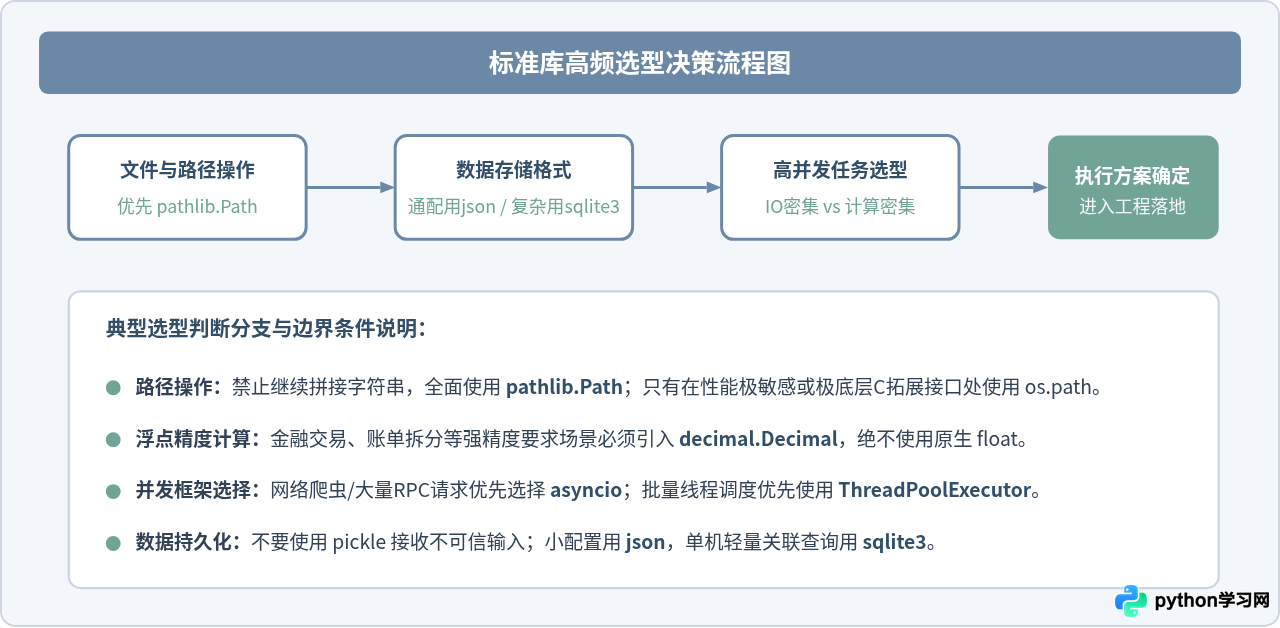
三、数学计算与数字处理
在涉及数字精度、科学计算和随机抽样时,明确各个模块的精度边界至关重要:
math:提供底层C语言标准的浮点运算支持(如三角函数、对数、开方)。需要注意它遵循IEEE 754规范,存在常规浮点数舍入误差。decimal:专为高精度十进制设计,支持自定义舍入模式与精度上下文。计算金额、利息与计费时是强制选型。random:用于仿真、洗牌与游戏模拟的伪随机数发生器(基于梅森旋转算法)。严禁将其用于密码、Token或加解密密钥的生成;安全场景必须使用secrets模块。statistics:轻量级统计分析模块,内置均值(mean)、中位数(median)、标准差(stdev)与线性回归(linear_regression),无需引入体积庞大的科学计算包。
四、文件系统与路径操作
自 Python 3.4 引入 pathlib 之后,标准库的文件系统交互进入了面向对象的现代化阶段。传统代码中充斥的 os.path.join、os.path.exists 等字符串拼接方式已全面建议被 pathlib.Path 取代。
pathlib.Path 的 / 运算符拼接路径,代码更清晰、跨平台(Windows 反斜杠与 Linux 正斜杠自动适配),且内置了 read_text()、write_text() 等高频IO便捷方法。
from pathlib import Path
import shutil

base_dir = Path("./workspace")
data_file = base_dir / "logs" / "app.log"

# 1. 递归创建父目录并直接写入文本
data_file.parent.mkdir(parents=True, exist_ok=True)
data_file.write_text("2026-10-21 service started\n", encoding="utf-8")

# 2. 模式遍历文件
for p in base_dir.rglob("*.log"):
    print(p.name, p.stat().st_size)

# 3. 复制或移动文件夹
shutil.copy(data_file, base_dir / "app_backup.log")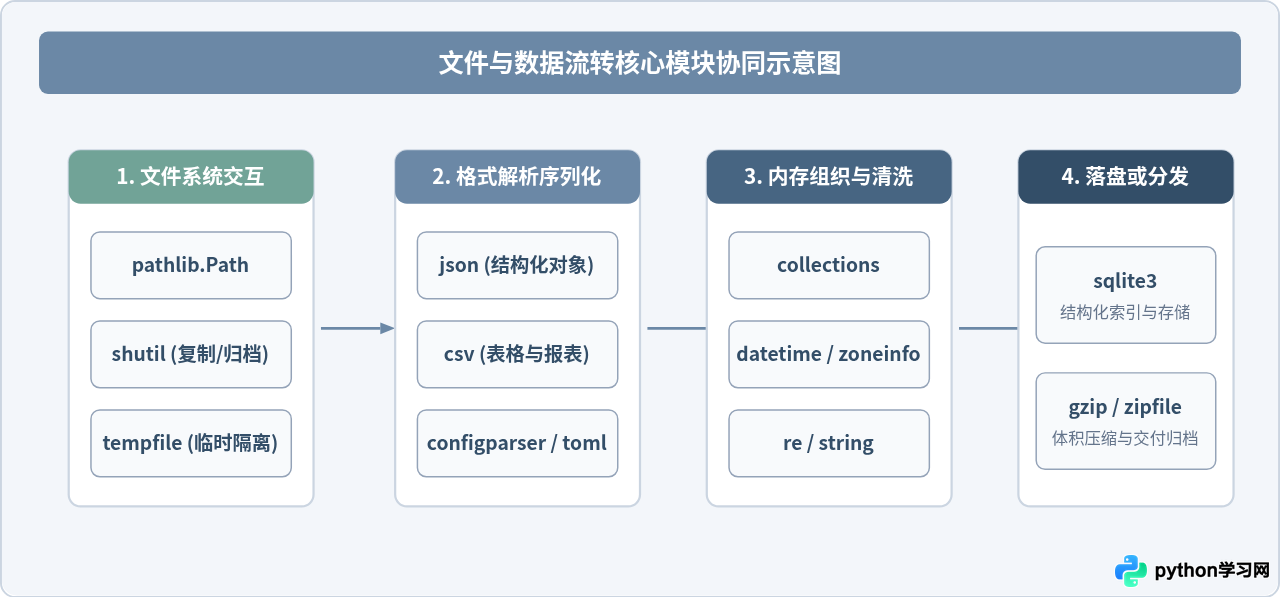
五、数据持久化与配置解析
处理本地状态保存与不同系统间的数据交换时,推荐依据场景轻重区分处理:
json:现代Web及前后端事实上的通用数据交换格式。解析大型JSON时建议流式读取,避免一次性消耗过大内存。csv:读写逗号分隔文件。务必使用csv.DictReader和csv.DictWriter,通过表头映射字典避免硬编码索引错位。sqlite3:无服务器、零配置的完整SQL引擎。非常适合单机中小型缓存、离线分析与本地状态留存。tomllib(Python 3.11+):只读解析 TOML 配置文件。适用于读取现代pyproject.toml风格的配置。
pickle 模块可以将任意 Python 对象序列化为二进制流,但其反序列化机制允许执行任意代码。绝对不能使用 pickle.loads() 处理未经验证的客户端上传数据或公网传入数据。
六、日期、时间与现代时区
时间处理常见的三大陷阱是:时区混乱(Naive vs Aware 时间对象混用)、夏令时错误以及系统单调时钟选型错误。
| 模块与类 | 核心用途 | 注意事项 |
|---|---|---|
datetime.datetime |
年月日时分秒的表示与差值运算(timedelta) |
避免使用 utcnow()(已被标记废弃),应使用 datetime.now(timezone.utc) |
zoneinfo.ZoneInfo |
标准IANA时区映射(Python 3.9+内置) | 无需第三方 pytz,直接支持 ZoneInfo("Asia/Shanghai") |
time.monotonic() |
高精度单调时钟 | 用于测量代码耗时与超时重试,不会因系统校时或NTP调整而倒退 |
七、系统交互与底层环境控制
标准库提供了直接与宿主操作系统环境、外部进程通信的能力:
sys:与当前 Python 解释器紧密相关。提供sys.argv(脚本参数)、sys.exit()(退出状态码)、sys.path(包导入检索路径)以及sys.platform。os:直接调用底层操作系统的系统调用。如os.environ获取环境变量、os.cpu_count()获取核心数。subprocess:替代旧式的os.system与os.popen。必须优先使用现代统一入口subprocess.run()。默认情况下请保持shell=False,以杜绝命令注入漏洞。argparse:内置且功能完备的命令行参数解析器,支持子命令、参数互斥以及自动生成带有-h/--help的说明文档。logging:企业级分级日志框架(DEBUG / INFO / WARNING / ERROR / CRITICAL),支持多 Handler 输出到控制台与轮转文件。
八、并发与异步编程
Python由于全局解释器锁(GIL)的存在,并发编程分为两大典型场景:I/O密集型与CPU密集型。
- I/O密集型任务(网络请求、数据库查询、磁盘读写):
推荐方案A:
concurrent.futures.ThreadPoolExecutor。以面向任务(Future)的形式提交线程任务,代码简洁,支持超时等待与异常捕获。推荐方案B:
asyncio。单线程协程事件循环,内存开销极小,可以支撑数万级网络长连接与高并发RPC。 - CPU密集型任务(图像处理、加密解密、复杂矩阵运算):
推荐方案:
concurrent.futures.ProcessPoolExecutor或multiprocessing。通过多进程完全避开GIL限制,充分利用多核CPU算力。
from concurrent.futures import ThreadPoolExecutor, as_completed
import urllib.request

urls = [
    "https://www.python.org",
    "https://docs.python.org",
    "https://pypi.org"
]

def fetch(url):
    req = urllib.request.Request(url, headers={"User-Agent": "PythonQuickCheck/1.0"})
    with urllib.request.urlopen(req, timeout=5) as resp:
        return url, len(resp.read())

# 使用线程池并发抓取网页
with ThreadPoolExecutor(max_workers=3) as executor:
    futures = [executor.submit(fetch, u) for u in urls]
    for fut in as_completed(futures):
        try:
            url, length = fut.result()
            print(f"[{url}] 数据大小: {length} 字节")
        except Exception as e:
            print(f"请求失败: {e}")
九、网络协议与安全通信
在网络通信层,Python标准库覆盖了从底层传输层到应用层的完整协议栈:
urllib.request/urllib.parse:不需要引入 requests 或 httpx 即可完成简单的HTTP GET/POST请求与URL编解码。socket:操作系统套接字接口,用于编写TCP服务端/客户端或底层UDP广播。ssl:为套接字提供TLS/SSL加密封装,确保传输层安全通信。ipaddress:IP地址与CIDR子网计算模块。可快速判断某个IP是否属于私有内网或某个特定子网段,非常适用于防火墙过滤与访问控制。
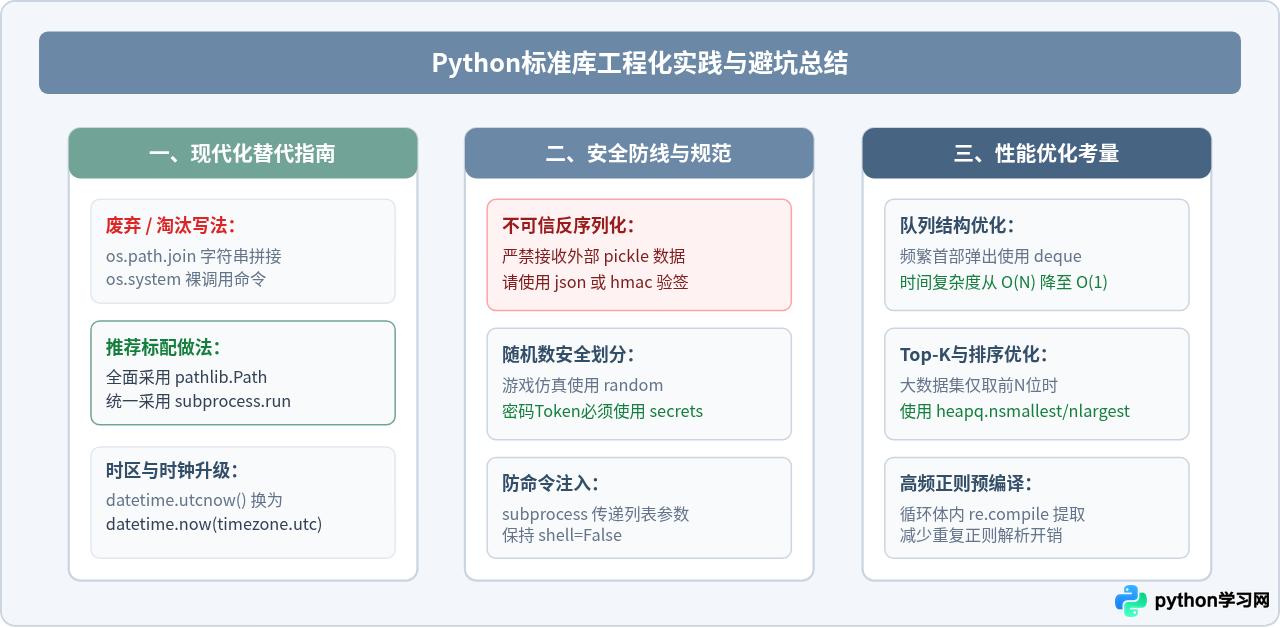
总结与速查清单
掌握Python标准库的核心在于“建立模块索引心智模型”,在面临具体问题时优先从标准库中寻找原生解决方案。避免为了几个工具函数引入庞大的外部第三方包,既能降低依赖版本冲突的风险,也能显著缩减镜像构建体积与发布部署成本。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















