


Python开发必知的10个高频标准库模块及用途
Python 自带的“开箱即用”标准库免去了引入第三方依赖的维护成本。在实际工程与日常脚本编写中,深入掌握最核心的 10 个高频标准库模块(pathlib、os、sys、json、datetime、re、collections、subprocess、logging、itertools),能够覆盖文件系统处理、外部进程协作、数据格式转化与工程级日志输出等绝大多数核心开发场景。本文直接剖析这 10 个模块的具体用途、核心 API 范式及开发避坑要点。
1. pathlib:面向对象的现代路径与文件操作
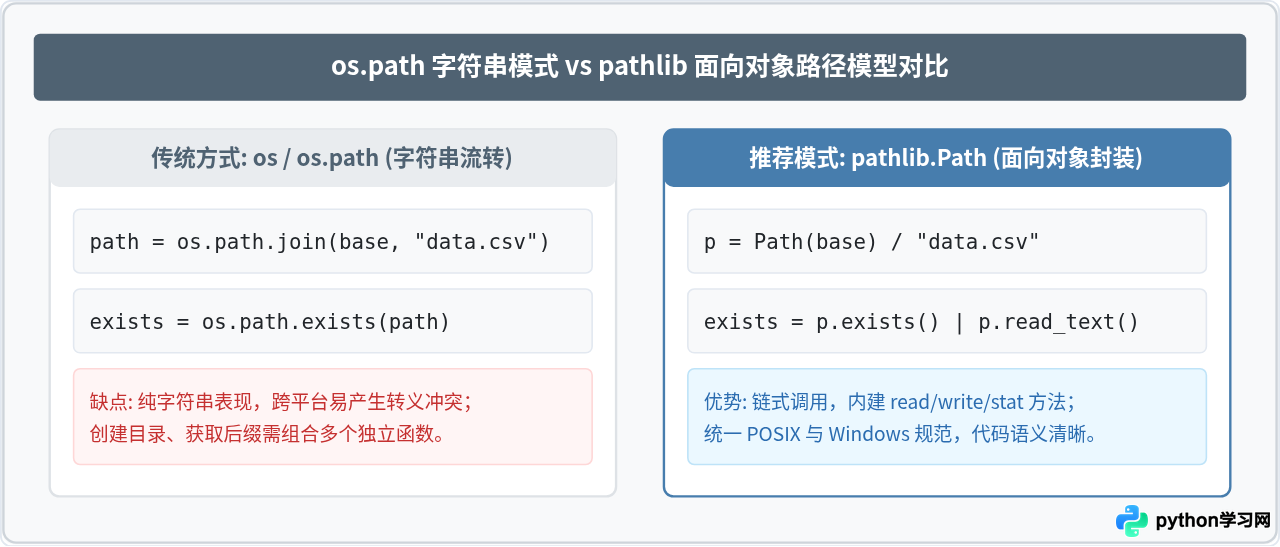
Python 3.4 引入的 pathlib 提供了面向对象的路径处理抽象,用以替代以往分散且易错的字符串拼接方式(如 os.path.join)。通过重载除号运算符 /,路径操作直观且天然跨平台,自动处理 Windows 的反斜杠与 POSIX 系统的正斜杠差异。
from pathlib import Path

# 获取当前工作目录与路径组合
base_dir = Path.cwd()
config_file = base_dir / "config" / "settings.json"

# 判断存在性与文件类型
if config_file.exists() and config_file.is_file():
    # 直接读取文本内容,无需手动 open/close 上下文
    content = config_file.read_text(encoding="utf-8")
    print(f"配置文件大小: {config_file.stat().st_size} 字节")

# 安全创建多级目录
logs_dir = base_dir / "output" / "logs"
logs_dir.mkdir(parents=True, exist_ok=True)
在日常路径处理时,优先使用 read_text() 和 write_text() 快速读写小文件,利用 resolve() 获取规范绝对路径。需要特别注意:mkdir() 若不带 parents=True,在父目录缺失时会直接抛出 FileNotFoundError。
2. os:操作系统交互与环境变量管控
尽管路径处理推荐交由 pathlib,os 模块仍然是与宿主操作系统交互的基石,主要职责在于读取和设置环境变量、进程退出与权限掩码调整。
import os

# 读取环境变量,设置安全默认值
database_url = os.environ.get("DATABASE_URL", "sqlite:///default.db")
debug_mode = os.environ.get("DEBUG", "False").lower() in ("true", "1")

# 获取系统当前运行状态
cpu_cores = os.cpu_count() or 1
current_pid = os.getpid()

print(f"运行PID: {current_pid}, 逻辑CPU数: {cpu_cores}, DB配置: {database_url}")
读取配置时,切忌直接使用下标 os.environ["KEY"],缺少该变量时会引发 KeyError 异常。推荐使用 os.environ.get("KEY", "default") 确保生产环境容错性。
3. sys:解释器环境与命令行控制
sys 模块直通 Python 解释器运行时,负责访问传入脚本的底层参数、标准输入输出流重定向、以及依赖模块的搜索路径 sys.path。
import sys

# 获取外部命令行入参
raw_args = sys.argv  # 第一个元素为脚本自身名称

# 判定 Python 运行时版本(例如要求最低 3.10)
if sys.version_info < (3, 10):
    sys.stderr.write("错误: 当前环境版本低于 Python 3.10,拒绝执行。\n")
    sys.exit(1)

# 查看模块引用缓存
loaded_modules_count = len(sys.modules)
print(f"已加载标准及用户模块数: {loaded_modules_count}")
4. json:数据序列化与接口协议交互
json 是 Web API 数据传输、配置持久化不可或缺的模块。它支持 Python 基础字典/列表与 JSON 字符串之间的相互转化。
import json

payload = {
    "status": "success",
    "code": 200,
    "items": ["cpu", "memory"],
    "enabled": True
}

# 序列化为字符串,ensure_ascii=False 保留中文原字,indent 格式化输出
json_str = json.dumps(payload, ensure_ascii=False, indent=2)

# 反序列化
parsed_data = json.loads(json_str)
assert parsed_data["code"] == 200s(String)的 loads() 和 dumps() 用于内存中字符串与对象的转换;不带 s 的 load() 和 dump() 必须传入实现了 read() 或 write() 的文件描述符。同时,JSON 标准不支持 datetime 或 set 类型,直接传参会抛出 TypeError,需要自定义 default 转换函数。
5. datetime:时间戳、日期计算与时区管理
时间记录与计算是各类业务系统的标配。datetime 模块提供 datetime、date、time 与 timedelta 类型。Python 3.9 之后推荐结合 timezone.utc 进行明确的时区标注,避免“天真时间对象(naive datetime)”在分布式环境下引发时间偏差。
from datetime import datetime, timedelta, timezone

# 推荐获取带明确 UTC 时区的时间
now_utc = datetime.now(timezone.utc)

# 日期偏移计算(计算未来 7 天)
future_date = now_utc + timedelta(days=7)

# 格式化字符串输出与反向解析
time_str = now_utc.strftime("%Y-%m-%d %H:%M:%S %Z")
parsed_dt = datetime.strptime("2026-10-14 12:00:00", "%Y-%m-%d %H:%M:%S")

print(f"当前UTC时间: {time_str}")
6. re:正则表达式与高效文本抽取
当普通的字符串 split()、replace() 或 find() 难以应对复杂格式时,re 模块提供了快速的模式匹配能力。对于反复执行的规则,务必使用 re.compile() 预编译正则对象,大幅提升执行吞吐。
import re

text = "用户 A102 于 2026-10-14 登录,IP为 192.168.1.100,端口 8080"

# 命名分组抽取模式
pattern = re.compile(r"IP为 (?P<ip>\d{1,3}(?:\.\d{1,3}){3}),端口 (?P<port>\d+)")
match = pattern.search(text)

if match:
    ip_addr = match.group("ip")
    port = int(match.group("port"))
    print(f"提取结果: IP={ip_addr}, Port={port}")
7. collections:高性能专业容器数据类型
Python 内置的 dict、list、tuple 涵盖了通用场景,但 collections 提供了针对特定数据结构的高性能扩展:
defaultdict: 消除键缺失异常,自动初始化默认类型(如列表或整数计数)。Counter: 专门用于频次统计与 Top-N 词频计算。deque: 双端队列,头部与尾部的插入和弹出均为 O(1) 复杂度(列表的头部插入为 O(n))。
from collections import defaultdict, Counter, deque

# 1. 自动成组的 defaultdict
grouped = defaultdict(list)
data = [("fruit", "apple"), ("veg", "carrot"), ("fruit", "banana")]
for category, item in data:
    grouped[category].append(item)

# 2. 词频统计 Counter
words = ["python", "java", "python", "go", "python", "go"]
counts = Counter(words)
print("出现最高前2项:", counts.most_common(2))

# 3. 定长滑动窗口 deque
window = deque(maxlen=3)
for i in range(5):
    window.append(i)
print("滑动窗口保留最后3项:", list(window))  # [2, 3, 4]
8. subprocess:外部命令执行与进程管理
调用系统现有二进制命令(如 git、ffmpeg 或 curl)时,切勿使用过时的 os.system(),而应统一采用 subprocess.run()。它提供了精确的参数列表传递、标准流捕获与超时防护,防止命令注入风险。
import subprocess

try:
    # 推荐列表传参而非 shell=True 字符串拼接
    result = subprocess.run(
        ["git", "--version"],
        capture_output=True,
        text=True,
        check=True,
        timeout=5
    )
    print("Git版本输出:", result.stdout.strip())
except subprocess.CalledProcessError as e:
    print(f"命令执行非零退出: {e.returncode}, 错误: {e.stderr}")
except subprocess.TimeoutExpired:
    print("命令执行超时已中断")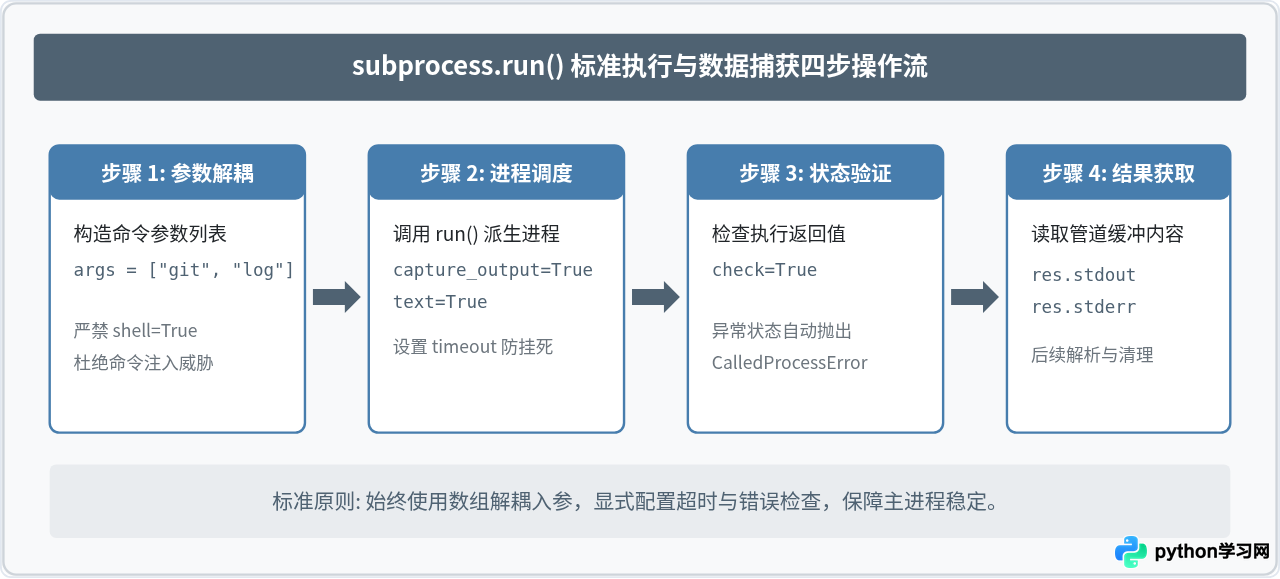
9. logging:生产级可配置日志框架
在严肃项目中,使用 print() 打印调试信息会丧失时间戳、代码位置、日志分级过滤以及输出目标动态切换能力。标准库 logging 提供了完整的日志处理管道。
import logging

# 快速配置控制台日志格式与日志等级
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(name)s (%(filename)s:%(lineno)d): %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)

logger = logging.getLogger(__name__)

logger.debug("低级别调试信息(默认不打印)")
logger.info("服务启动就绪,端口: %d", 8000)

try:
    1 / 0
except ZeroDivisionError:
    # exc_info=True 会自动附带完整调用栈 Traceback
    logger.error("计算过程发生异常", exc_info=True)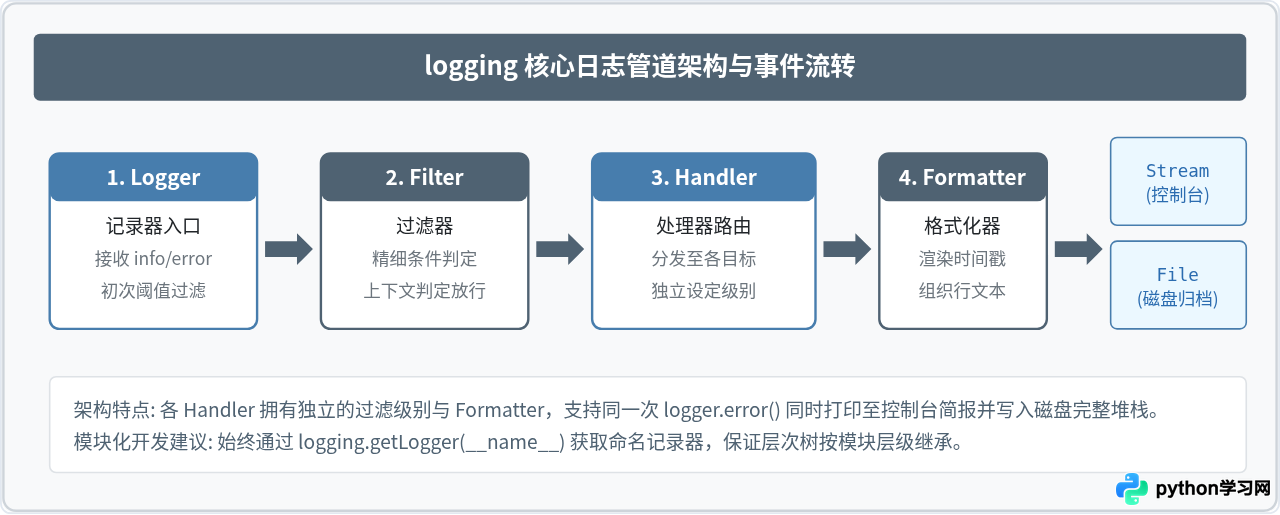
10. itertools:内存友好型惰性迭代工具集
处理大型数据集或多重循环时,直接生成列表极易消耗过多内存。itertools 提供了丰富的函数式迭代器工具,全部采用惰性计算(逐项生成),节约内存开销。
chain(*iterables): 零拷贝平顺链接多个可迭代对象。islice(iterable, stop): 对无索引的生成器进行切片截取。product(*iterables): 替代多层嵌套for循环计算笛卡尔积。
import itertools

# 1. 链式拼接多个序列,无需相加构建大列表
seq1 = [1, 2, 3]
seq2 = ["a", "b"]
combined = itertools.chain(seq1, seq2)
print("拼接结果:", list(combined))  # [1, 2, 3, 'a', 'b']

# 2. 替代两层嵌套循环计算笛卡尔积
colors = ["red", "blue"]
sizes = ["S", "M", "L"]
sku_list = [f"{c}-{s}" for c, s in itertools.product(colors, sizes)]
print("SKU组合数:", len(sku_list))  # 6 项

# 3. 惰性无限计数切片
counter = itertools.count(start=10, step=2)
first_three = list(itertools.islice(counter, 3))
print("惰性取样:", first_three)  # [10, 12, 14]
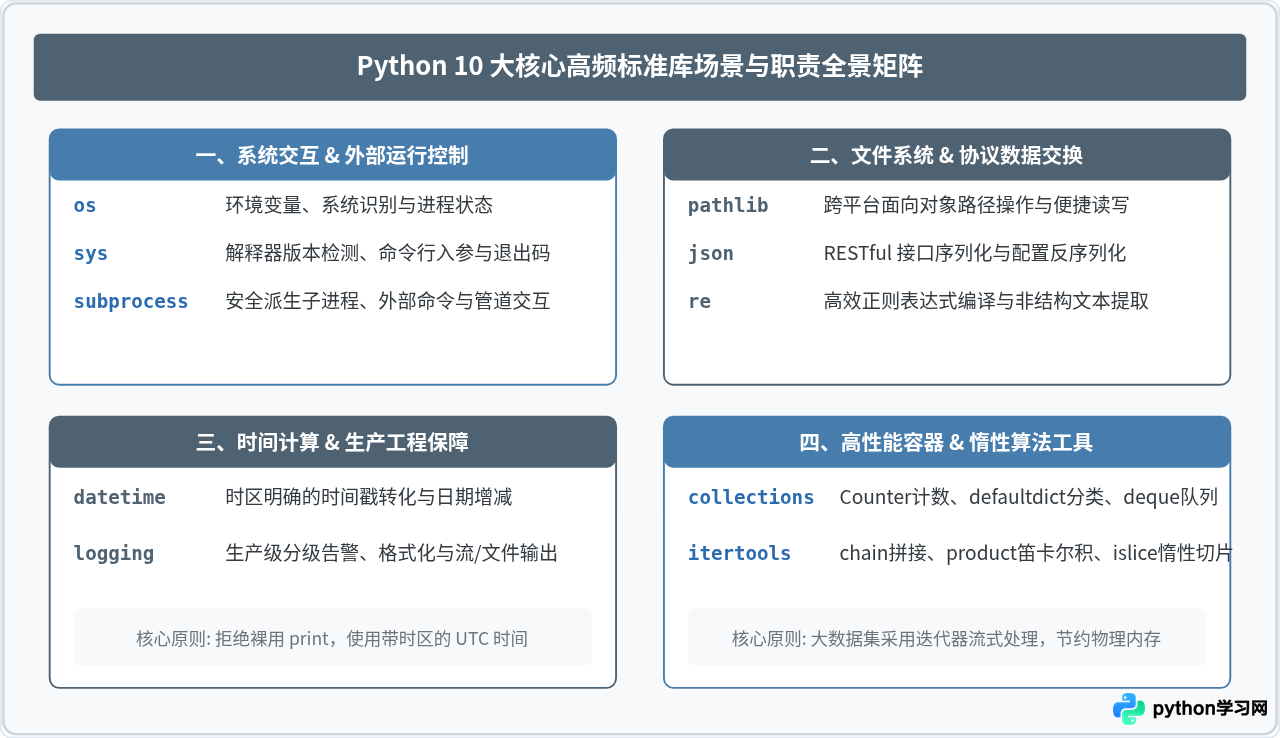
模块选型与职责总结全景
在实际开发中,不应把标准库孤立看待,而应结合架构分层合理搭配使用。例如在编写自动化调度任务时:通过 sys 读取参数,用 os 检视运行配置,通过 pathlib 检索目录,调用 subprocess 调度执行,并通过 logging 归档运行轨迹。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















