


Python Web开发、数据分析与AI方向的学习深度有何不同?
深入对比Python在Web开发、数据分析与AI方向的学习深度差异,从知识重心、能力演进、认知辨析到决策选型,全面解析各方向的核心技术壁垒与进阶关键。
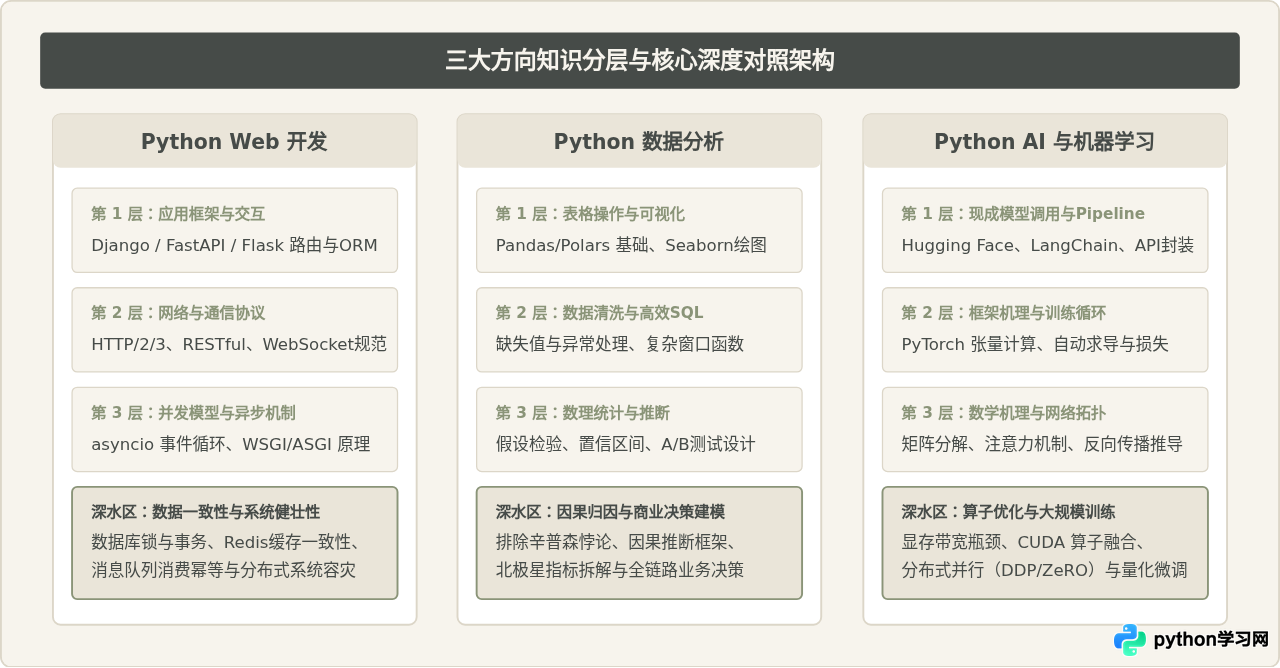
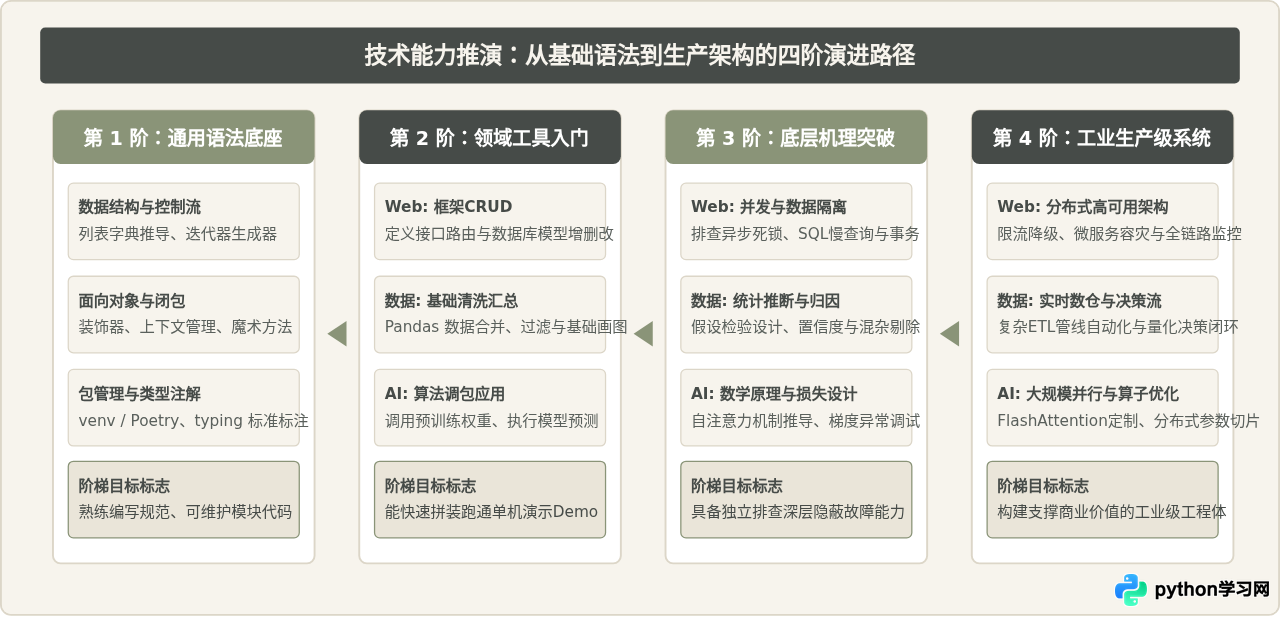
Python在Web开发、数据分析与AI(人工智能/机器学习)三个方向上的学习深度差异,核心不在于Python语言基础语法的复杂程度,而在于各自向上依托的领域理论与系统底层能力的重心完全不同:Web开发以“网络通信协议、并发模型与数据工程一致性”为纵向深度,数据分析以“统计学推断、数据管线治理与商业因果归因”为横向深度,而AI方向则以“高等数学推导、模型架构机理与异构算力优化”为垂直深度。
一、Web开发:以系统工程、协议规范与并发边界为纵向深度
在许多初学者的认知中,Python Web开发似乎只是“写写路由、查查数据库、返回JSON”。使用轻量框架(如Flask或FastAPI),几十行代码确实就能启动一个服务。然而,Web开发的真实深度并非体现在框架API的熟练度上,而是体现在对整个计算机系统与分布式网络工程的控制能力。
1. 网络协议与通信生命周期
从浏览器发起一个请求,到Python应用进程接收并返回响应,中间经历了完整的DNS解析、TCP握手、TLS加密协商、反向代理(Nginx)转发以及网关协议(WSGI/ASGI)转换。深入学习Web开发,需要理解HTTP各个头部字段的缓存语义(如Cache-Control、ETag与条件请求验证)、跨域资源共享(CORS)的安全握手流程,以及长连接协议(WebSocket与SSE)的状态维持机制。
2. 异步IO与事件循环的底层制约
现代Python Web框架(如FastAPI、Tornado)大量依赖asyncio。理解协程并不只是在函数前加上async和await关键字,其核心深度在于搞清楚事件循环的工作机理:
- 协同式调度的局限:一旦在
async def路由中执行了耗时较长的CPU密集计算或调用了同步阻塞库(如未经包装的传统数据库驱动),事件循环将被卡死,导致整个进程在此期间无法处理任何其他并发网络请求。 - 线程池与进程池委托:理解何时应该将同步阻塞任务通过
run_in_executor派发到后台线程池,何时需要多进程并行绕过全局解释器锁(GIL)。
3. 关系型数据库事务与缓存一致性
实际生产环境中,绝大多数性能与数据事故都发生在数据库与缓存交互层面。Web开发深入后的核心挑战包括:
- 事务隔离级别与死锁防御:在可重复读(Repeatable Read)或读已提交(Read Committed)隔离级别下,掌握行级锁(Row Lock)与间隙锁(Gap Lock)的加锁规则,避免高并发扣减库存时的死锁与数据超卖。
- 双写一致性与缓存失效风暴:掌握“旁路缓存(Cache-Aside)”模式下先更新数据库再淘汰缓存的原则,并设计应对缓存穿透、缓存击穿与缓存雪崩的具体策略(如互斥锁排队与布隆过滤器)。
二、数据分析:以统计推断、数据管线与商业归因为横向深度
数据分析方向常被误以为只是“Excel的Python替代品”。很多人学完df.groupby()和plt.plot()后,发现自己只能做出基础图表,却无法在企业中输出可信结论。数据分析的深度本质上是横向扩展的:一头深入业务逻辑与因果推断,另一头深入数据工程与统计学真理。
1. 统计推断严谨性与“假阳性”规避
仅凭肉眼看图表均值的增长,极易陷入认知误区。深入数据分析必须建立严密的数理推断体系:
- 样本分布与假设检验:正确识别数据是正态分布、偏态分布还是幂律分布。根据数据形态选用参数检验(如双样本t检验)或非参数检验(如Mann-Whitney U检验)。
- A/B测试的统计效力(Power):懂得在实验开始前计算最小样本量(MDE),控制第一类错误(虚报α)和第二类错误(漏报β),防止因提前停止实验导致伪显著。
2. 因果推断与混杂变量剔除
“相关不等于因果”是数据分析深水区的核心命题。例如在用户行为分析中,经常观察到“使用搜索功能的用户留存率明显更高”,初级分析容易推导出“应强制引导用户多搜索”的错误结论。深入分析需要识别“高意向用户天然更喜欢搜索”这一混杂变量(Confounder),并运用倾向评分匹配(PSM)或双重差分法(DID)剥离偏差,找到真实的因果增量。
3. 生产级数据治理与复杂分析SQL
现实中的数据绝非清晰规整的CSV文件。高级数据分析需要深入现代数据仓库环境:
- 熟练编写跨几十张表的复杂窗口函数(
ROW_NUMBER()、LEAD()、LAG())进行用户旅程还原。 - 防范数据倾斜、掌握空值插补与异常值识别边界,确保数据指标口径一致且可复现。
三、AI与机器学习:以数学推导、算法机理与算力优化为垂直深度
在当今开源生态繁荣的背景下,调用一个预训练模型或导入库只需几行Python代码。但AI方向之所以公认研发壁垒最高,在于其学习深度的下限直接锚定在高等数学理论,上限则直接触碰高性能异构计算(GPU/TPU)的物理硬件极限。
1. 数学理论决定了“为什么它能工作”
如果不理解数学推导,当模型在训练过程中发生损失(Loss)震荡不收敛、梯度爆炸或过拟合时,开发者将束手无策,只能随机修改超参数碰运气。深入AI方向所必须掌握的数学基石包括:
- 线性代数:张量乘法、奇异值分解(SVD)、特征值与特征向量,这是理解词嵌入(Embedding)与注意力矩阵投射的根本。
- 多元微积分与优化理论:梯度下降变体(SGD、AdamW)、链式法则反向传播推导,以及鞍点逃逸与正则化几何解释。
- 概率论与信息论:交叉熵、KL散度、贝叶斯先验以及最大似然估计(MLE)。
2. 架构拓扑机理与前沿演进
理解模型并非停留在抽象黑盒,而是要能逐层写出前向传播逻辑:
# 简化版自注意力机制核心计算流程演示
import torch
import torch.nn.functional as F

def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = Q.size(-1)
    # 1. 矩阵点积计算相似度并缩放
    scores = torch.matmul(Q, K.transpose(-2, -1)) / (d_k ** 0.5)
    if mask is not None:
        scores = scores.masked_fill(mask == 0, -1e9)
    # 2. 归一化注意力权重
    attn_weights = F.softmax(scores, dim=-1)
    # 3. 加权求和输出上下文表征
    return torch.matmul(attn_weights, V), attn_weights
深入该方向,需要透彻掌握自注意力机制(Self-Attention)为何能够克服RNN的长期遗忘缺陷,以及位置编码(RoPE)、多头机制(MHA/GQA)和残差连接对深层梯度流动的保护作用。
3. 大模型时代的工程深水区:显存与并行计算
当参数量从数百万飙升至数十亿、百亿级别时,学习深度迅速向底层硬件迁移:
- 显存占用精确计算:模型参数、反向激活值(Activation)、梯度与优化器状态(Adam动量)的显存分配机制。
- 分布式加速策略:数据并行(DDP)、张量并行(TP)、流水线并行(PP)以及ZeRO显存优化算法。
- 底层算子级优化:掌握FlashAttention如何通过分块计算避免SRAM与HBM之间的高频IO瓶颈,乃至编写或调试Triton/CUDA核函数。
四、容易混淆的认知辨析:如何客观评估学习难度?
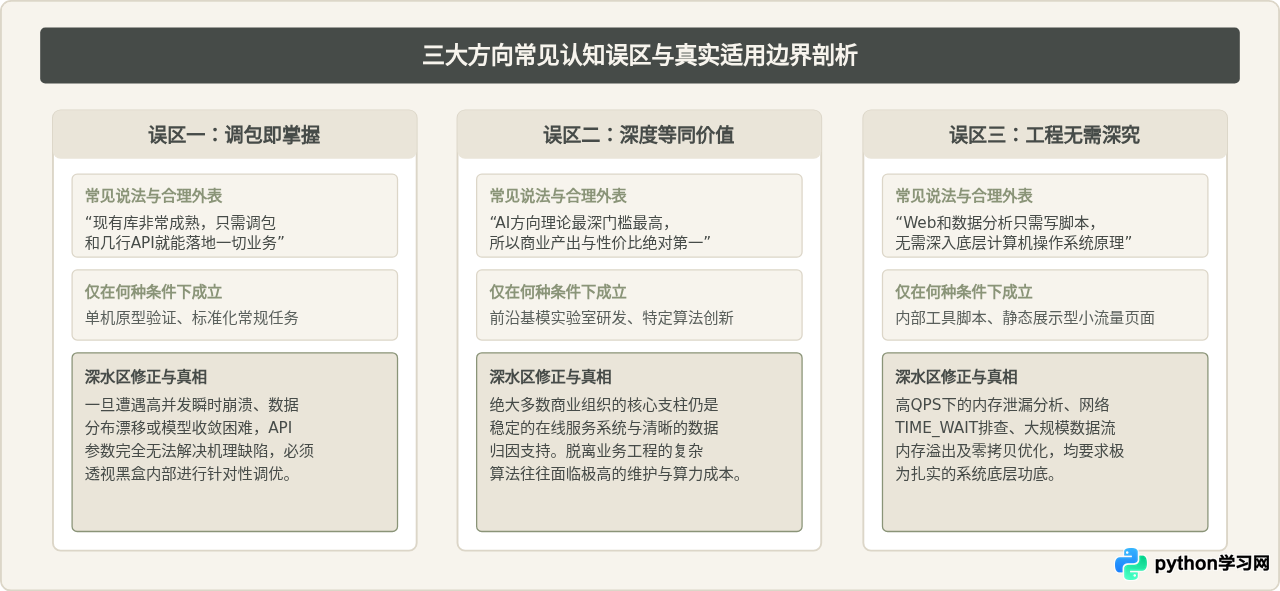
在技术讨论中,往往存在一些看似合乎常理、实则容易误导学习规划的说法。我们需要客观地拆解这些说法成立的前提及其局限:
1. “只要调库就能完成工作,深入底层没有意义”
这种说法在项目验证初期(POC阶段)是完全成立的。现代Python生态极其丰富,调用FastAPI可以瞬间搭建服务,调用Pandas可以快速计算相关性,调用Transformers几行代码就能完成情感分类。这一阶段,开发者的产出效率极高。
但它的局限在于:API只封装了“正常情况下的确定性逻辑”,没有封装“异常情况下的排查上下文”。当Web服务遇到偶发性长尾延迟(P99 latency抖动)、数据分析遇到脏数据导致的伪相关、或者AI模型发生梯度消失时,黑盒外部的API不会提供答案。唯有透彻理解底层通信机制、统计学假设前提与矩阵链式法则的开发者,才能迅速定位根因。
2. “AI方向难度最高,所以应该优先学AI”
AI方向在数学推导与理论门槛上确实最高,对概率统计、线性代数和微积分的要求远超其他两个方向。但“理论难度高”并不等同于“学习收益一定最大”。
AI算法的商业闭环极度依赖基础设施:再优秀的推荐算法,也需要依赖Web工程提供毫秒级的在线特征加载与API高并发服务;再先进的预测模型,也需要数据分析与数据工程清洗出高信噪比的训练特征。因此,脱离工程落地能力的AI学习很容易陷入“只会写Jupyter Notebook跑标准化数据集,却无法部署进生产系统”的尴尬境地。
五、决策与选型:如何根据自身基础确定深入路径?
评估自身应在哪个方向深耕,不应随波逐流,而应结合个人的底层知识背景、工作兴趣以及解决问题的思维方式来做出理性选择:
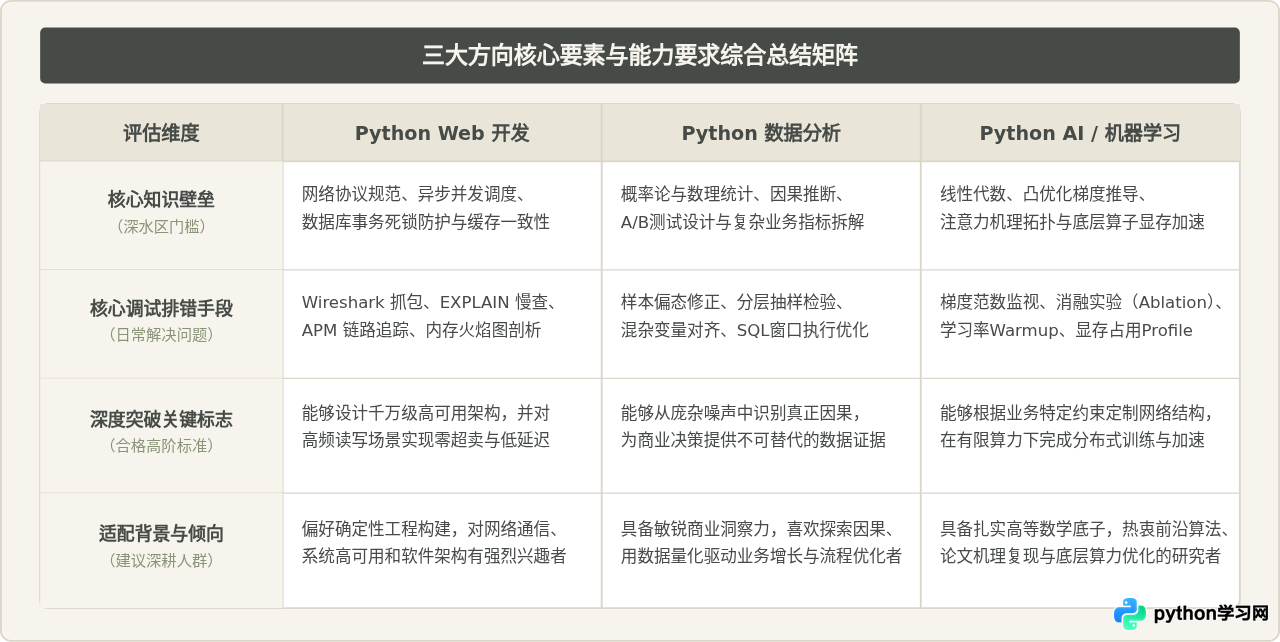
对于绝大多数工程师而言,最佳的策略不是将三者孤立看待,而是先确立一个主干深度(例如以Web开发为核心工程底座,或以数据分析为商业决策底座),再在主干深度之上,横向吸收其他方向的基础接口能力(如在Web后端中集成AI模型推理API,或在数据分析中编写自动化报表接口)。唯有在一个领域触碰到其深水区的核心本质后,向其他方向的迁移才能事半功倍。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















