


llama.cpp b12469 的二维卷积何时进入矩阵乘法内核?
发布时间:2026-11-17 |
6人浏览过
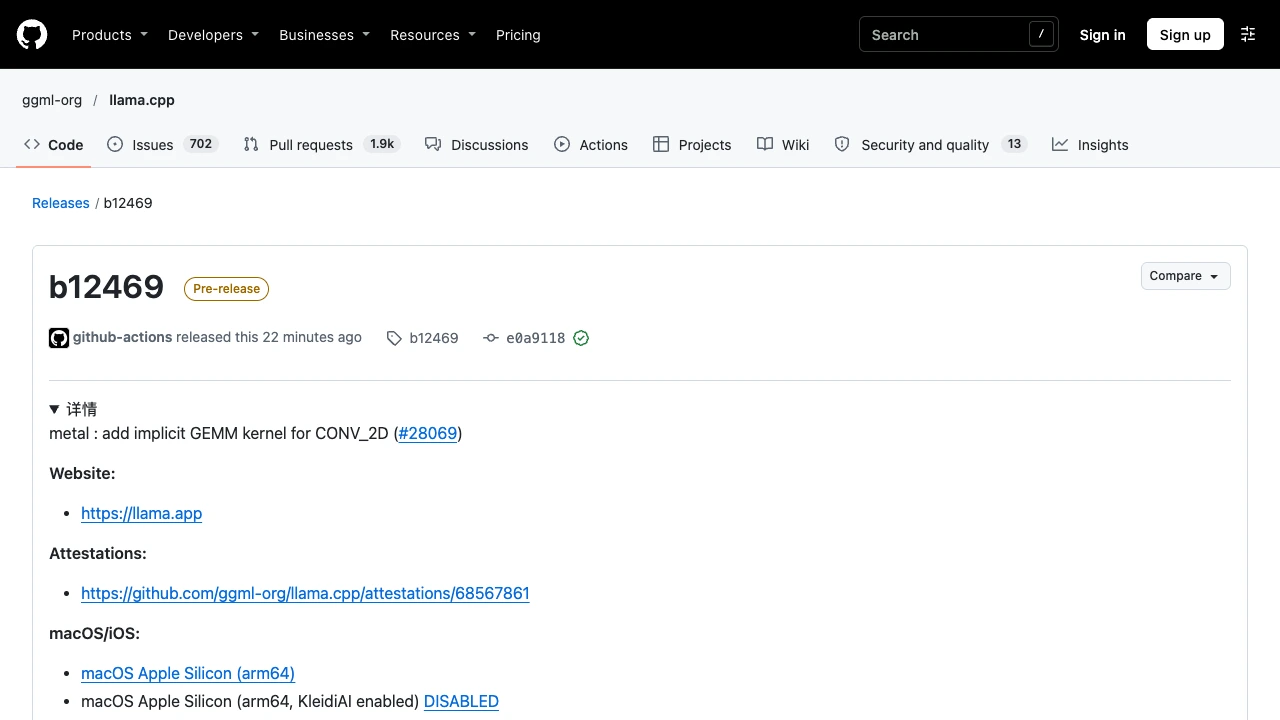
llama.cpp b12469 的 Metal 二维卷积可以在有相应矩阵指令的设备上使用隐式 GEMM。旧内核仍负责不具备该能力的设备。
卷积窗口如何映射成矩阵
llama.cpp b12469 为 Metal CONV_2D 增加隐式 GEMM 内核。每个输出通道对应权重矩阵的一行,每个输出像素对应由卷积窗口内的输入值组成的一列。
隐式处理节省了哪一步
线程组按需把窗口所需输入收集到共享内存,再通过 simdgroup 矩阵指令完成输出块的乘加。合并说明指出,输入以 f16 暂存,乘加结果在 f32 中累计。
设备不支持矩阵指令时怎样处理
旧内核仍保留作为无 simdgroup 矩阵支持设备的回退路径。b12469 是预发布构建,实际表现取决于设备、形状及分派结果,改动范围限于 Metal 的二维卷积。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















