


Python主要用来做什么:Web开发、数据分析与自动化脚本的核心应用
全面解析Python三大核心应用领域:Web后端开发、数据分析与科学计算、自动化脚本与系统运维。深入分析架构设计、工作流、实战代码与技术选型建议。
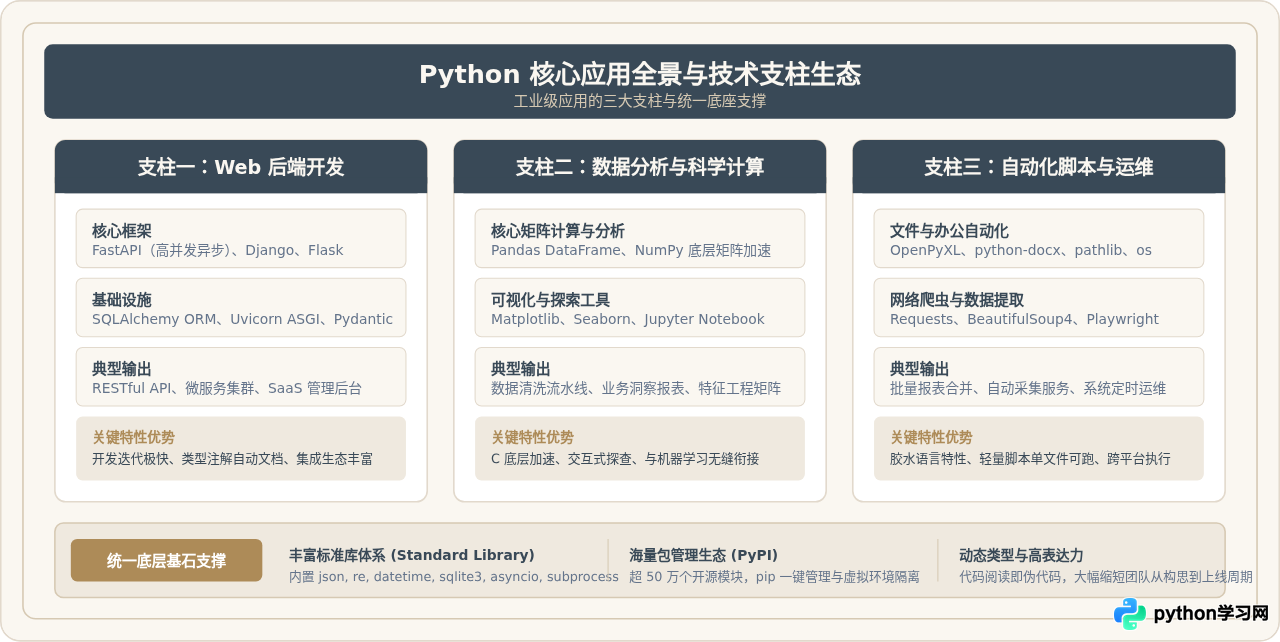
一、Web 后端开发:从轻量 API 到高并发架构
在 Web 领域,Python 并不负责浏览器的 UI 渲染(这是 HTML/CSS/JavaScript 的职责),而是专门处理服务器端业务逻辑。它接收前端发来的网络请求,进行身份认证与鉴权、调用数据库读写数据、执行业务计算,并将处理结果组装为结构化数据(如 JSON)或动态页面返回给客户端。
1. 主流 Web 框架定位与选型依据
Python 的 Web 生态经历了从单体全包到轻量微服务,再到当今异步高性能框架的演进:
- FastAPI(现代化异步标准):基于 Python 3.7+ 的类型提示(Type Hints)与 ASGI 协议构建。具有接近 Go/NodeJS 的高并发性能,支持自动生成符合 OpenAPI 规范的交互式文档(Swagger UI),并利用 Pydantic 严格校验请求数据,是目前新建 RESTful API 与微服务的首选。
- Django(全功能企业级):遵循“开箱即用(Batteries-Included)”理念,内置强大的 ORM 数据库映射、用户管理系统、CSRF 安全防护及成熟的管理后台(Admin)。非常适合需求明确、需要快速构建中后台管理系统或内容型产品的团队。
- Flask(极简轻量级):仅提供核心路由与请求上下文,其他组件(如数据库操作、表单验证)均交给第三方插件。适合编写功能明确的微小服务或教学原型。
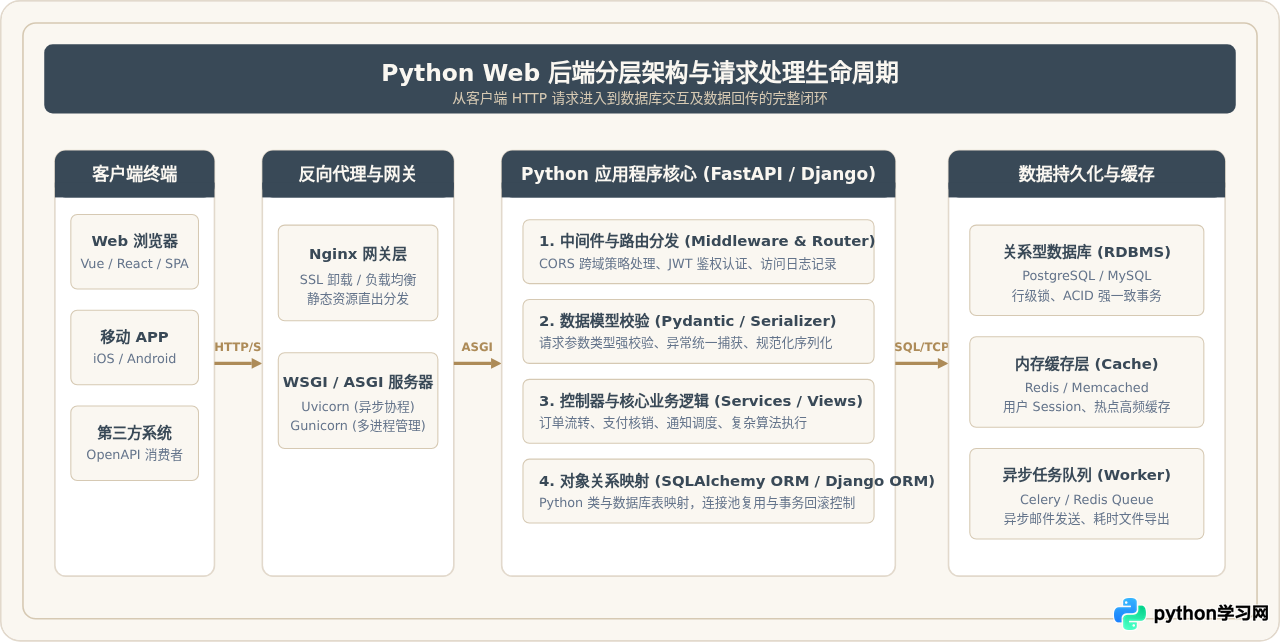
2. 实战示例:使用 FastAPI 构建结构化服务
下面是一个实际可运行的现代化 FastAPI 接口代码。通过 Pydantic 定义请求体结构,Python 会在运行时自动校验入参合法性,并在缺少字段或类型不符时直接返回详尽的 422 错误信息:
# main.py
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional
from datetime import datetime

app = FastAPI(title="用户任务管理系统", version="1.0.0")

# 1. 定义数据传输模型 (DTO / Schema)
class TaskCreate(BaseModel):
    title: str = Field(..., min_length=2, max_length=100, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")
    description: Optional[str] = Field(None, description="任务详细描述")

class TaskResponse(TaskCreate):
    id: int
    created_at: datetime
    is_completed: bool

# 模拟内存数据库
db_tasks = {}
task_id_counter = 1

# 2. 路由接口实现
@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(payload: TaskCreate):
    global task_id_counter
    new_task = {
        "id": task_id_counter,
        "title": payload.title,
        "priority": payload.priority,
        "description": payload.description,
        "created_at": datetime.now(),
        "is_completed": False
    }
    db_tasks[task_id_counter] = new_task
    task_id_counter += 1
    return new_task

@app.get("/api/v1/tasks/{task_id}", response_model=TaskResponse)
async def get_task(task_id: int):
    if task_id not in db_tasks:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail=f"未找到 ID 为 {task_id} 的任务"
        )
    return db_tasks[task_id]
在终端中安装依赖并启动服务:
pip install fastapi uvicorn
uvicorn main:app --host 127.0.0.1 --port 8000 --reload
启动后在浏览器访问 http://127.0.0.1:8000/docs,即可直接看到系统自动生成的交互式 Swagger 文档,免去人工编写 API 文档的成本。
二、数据分析与科学计算:从海量数据到业务决策
Python 能成为全球数据分析与人工智能领域的第一事实标准,关键在于其拥有由底层 C/Fortran 编写的加速计算核心与顶层极其简明的高级语法结合的完整生态。无论是金融风控、电商运营指标计算,还是科研实验数据处理,Python 都能完整覆盖数据提取、清洗转换、统计建模到最终图表呈现的全流程。
1. 数据分析核心工具链的职责划分
- NumPy(多维数组与矩阵计算):提供了高效连续内存存储的
ndarray结构,支持高维向量化(Vectorization)广播运算,避免了原生 Python 低效的for循环。 - Pandas(表格数据处理瑞士军刀):以
DataFrame(二维表格)为核心,提供类似 Excel 和 SQL 的透视、关联(Merge/Join)、分组聚合(GroupBy)、时间序列切片与缺失值处理功能。 - Matplotlib & Seaborn(数据可视化):提供从基础折线图、柱状图到复杂统计分布图(箱线图、热力图)的绘图能力。
- Jupyter Notebook(交互式探索环境):代码、运行结果、表格和图表一体化输出,让分析师可以按单元格分步探索数据并即时获得反馈。
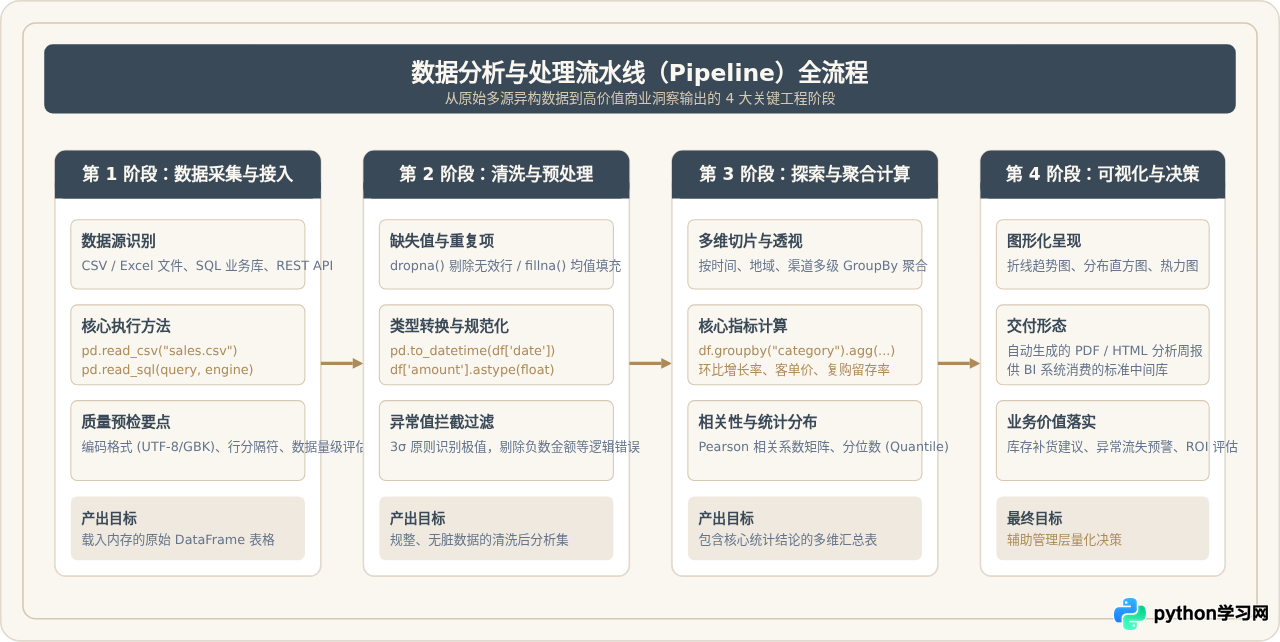
2. 实战示例:电商订单数据的清洗与多维聚合
以下代码演示了真实业务中常见的数据处理场景:读取订单日志、剔除未付款脏数据、提取时间维度并按品类进行销售总额与客单价聚合:
import pandas as pd
import numpy as np

# 1. 模拟生成原始交易数据集
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005, 1006],
    "category": ["电子数码", "日用百货", "电子数码", "服装鞋帽", "日用百货", "服装鞋帽"],
    "amount": [4999.0, 89.5, np.nan, 299.0, 150.0, -50.0],  # 含有缺失值与负数异常值
    "order_time": ["2026-03-01 10:20:00", "2026-03-01 11:15:00", "2026-03-02 09:00:00",
                    "2026-03-02 14:30:00", "2026-03-03 16:45:00", "2026-03-03 18:00:00"],
    "status": ["已支付", "已支付", "待支付", "已支付", "已支付", "已退款"]
}

df = pd.DataFrame(raw_data)
print("=== 原始数据集 ===")
print(df)

# 2. 数据清洗预处理
# 过滤非'已支付'状态,并清除金额为 NaN 或小于等于 0 的异常记录
clean_df = df[
    (df["status"] == "已支付") &
    (df["amount"].notnull()) &
    (df["amount"] > 0)
].copy()

# 转换时间列并提取日期特征
clean_df["order_time"] = pd.to_datetime(clean_df["order_time"])
clean_df["order_date"] = clean_df["order_time"].dt.date

# 3. 按品类进行统计指标聚合计算
analysis_result = clean_df.groupby("category").agg(
    order_count=("order_id", "count"),
    total_sales=("amount", "sum"),
    avg_order_value=("amount", "mean")
).reset_index()

# 格式化数值展示
analysis_result["total_sales"] = analysis_result["total_sales"].round(2)
analysis_result["avg_order_value"] = analysis_result["avg_order_value"].round(2)

print("\n=== 清洗与多维聚合结果 ===")
print(analysis_result)
在处理千万级(数 GB 以上)大规模数据时,避免在 Pandas 中使用 for _, row in df.iterrows() 遍历行,这会导致代码性能下降数百倍。应始终使用 Pandas 内置的矢量化方法(Vectorized Operations)或使用 chunksize 参数分块流式加载。
三、自动化脚本与系统运维:消除低效重复劳动
Python 最具大众亲和力与即时生产力价值的领域是“自动化脚本”。由于其跨平台支持优秀、标准库开箱即用,被誉为最顶级的系统胶水语言。无论是研发团队的 CI/CD 自动化构建与巡检,还是运营与财务人员的批量报表合并,几行清晰的 Python 脚本就能替代人工数小时的机械劳动。
1. 自动化核心场景分类
- 办公文件批量自动化:利用
openpyxl处理 Excel,python-docx批量修改合同,pypdf拆分合并文档,实现成百上千份办公文件的毫秒级生成。 - 网络数据采集(爬虫与自动化测试):利用
requests批量调用内部接口,或使用Playwright / Selenium驱动无头浏览器(Headless Browser),自动化完成网页登录、点击与结构化信息抓取。 - 系统运维与监控巡检:利用标准库
pathlib、os、shutil处理目录清理,结合psutil监控服务器 CPU/内存水位,一旦超标自动发送告警邮件或企业微信机器人消息。
2. 实战示例:跨部门多份 Excel 月度报表自动清洗合并
在实际企业行政或财务工作中,经常需要将不同部门交上来的 Excel 文件合并成一张汇总总表。传统人工复制粘贴容易漏项且极度耗时,用以下脚本仅需 1 秒即可自动遍历目录并合并:
# merge_reports.py
from pathlib import Path
import pandas as pd
from datetime import datetime

def batch_merge_sales_reports(source_dir: str, output_filepath: str):
    folder = Path(source_dir)
    # 获取目录下所有 .xlsx 报表文件
    excel_files = list(folder.glob("*.xlsx"))

    if not excel_files:
        print(f"提示:在目录 {source_dir} 下未找到任何 Excel 文件。")
        return

    merged_data = []

    for file_path in excel_files:
        try:
            # 读取每个部门的单份报表
            sub_df = pd.read_excel(file_path)
            # 添加源文件名作为溯源标记
            sub_df["来源文件"] = file_path.name
            sub_df["合并时间"] = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
            merged_data.append(sub_df)
            print(f"成功读取: {file_path.name} (行数: {len(sub_df)})")
        except Exception as e:
            print(f"读取失败跳过: {file_path.name}, 错误原因: {e}")

    if merged_data:
        # 纵向拼接所有表格
        final_df = pd.concat(merged_data, ignore_index=True)
        # 写出至指定合并结果文件
        final_df.to_excel(output_filepath, index=False)
        print(f"=== 合并完成!汇总行数: {len(final_df)},已保存至: {output_filepath} ===")

if __name__ == "__main__":
    # 执行示例:将 reports 文件夹下的全部报表合并为 summary.xlsx
    batch_merge_sales_reports("./monthly_reports", "./annual_summary.xlsx")
四、三大核心领域选型对比与综合决策
为了让读者更清晰地评估不同应用场景的技术要求与收益比,下表从核心职责、门槛、典型技术栈及常见陷阱对三大方向进行了系统对比:
| 核心应用领域 | 典型应用场景 | 核心依赖技术栈 | 上手门槛 | 主要优势 | 开发注意事项与边界 |
|---|---|---|---|---|---|
| Web 后端开发 | SaaS 服务、REST API、管理中后台、微服务 | FastAPI, Django, SQLAlchemy, Uvicorn | 中等 | 业务开发效率极高,生态成熟,ORM 与文档工具完备 | 受 GIL 限制,CPU 密集型高并发需依赖多进程,注重异步 I/O |
| 数据分析与科学 | 经营分析、用户画像、A/B 测试、报表自动化 | Pandas, NumPy, Matplotlib, Jupyter | 较低到中等 | C 语言底层矩阵加速,交互式探查,与 AI/ML 无缝衔接 | 大内存占用,需杜绝低效循环,必要时选用 Polars 或 DuckDB |
| 自动化脚本 | 文件批处理、系统巡检、数据抓取、DevOps | Requests, OpenPyXL, Pathlib, Subprocess | 低 | 代码短小精悍,零多余配置,跨平台即写即跑 | 需妥善处理网络超时与重试,做好日志记录与配置文件鉴权 |
总结
回到“Python 主要用来做什么”这个核心问题,答案正是这三大互相促进的应用场景:
- Web 后端开发:借助 FastAPI 与 Django,以极高的人效将业务创意转化为安全可靠的云端 API 与服务系统。
- 数据分析与科学计算:依托 NumPy、Pandas 与 Jupyter,将分散杂乱的企业业务日志转化为清晰的可视化图表与商业决策依据。
- 自动化脚本与运维:发挥强大的胶水语言特性,打通文件、操作系统、浏览器与第三方接口,将重复的人工劳动全部交由代码自动完成。
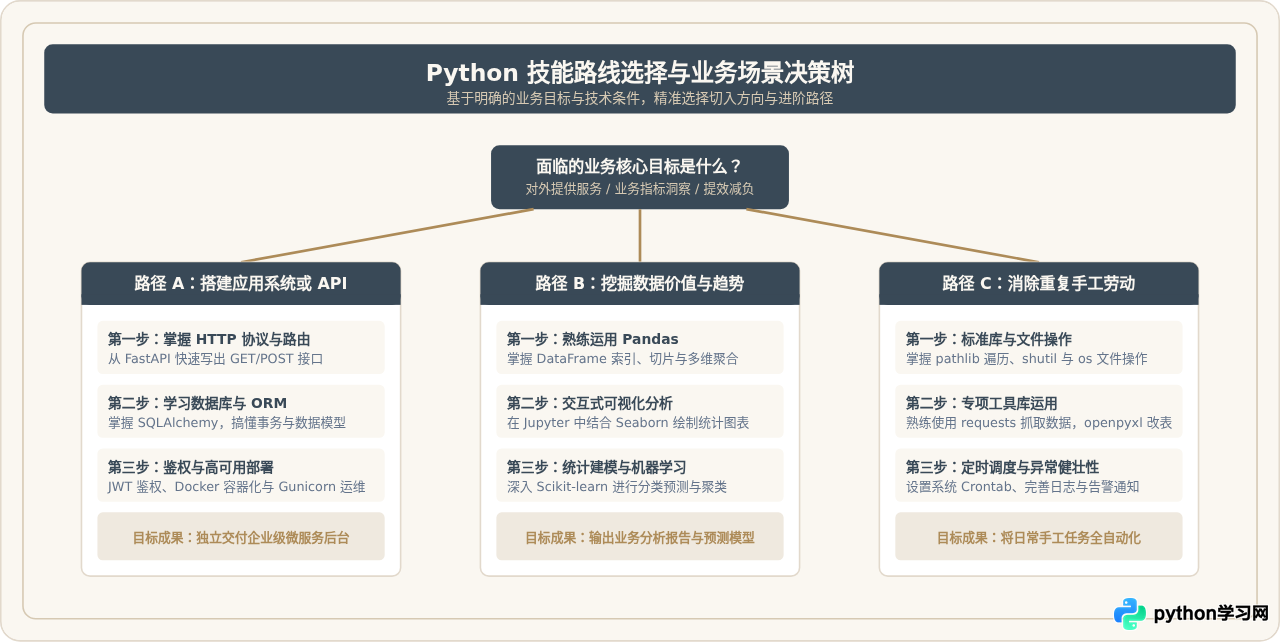
对于初学者或准备在团队中引入 Python 的技术负责人而言,无需试图一蹴而就掌握全部领域。最有效的方式是从当前痛点切入——若饱受 Excel 处理之苦,先写一个自动化合并脚本;若有数据探查需求,直接打开 Jupyter 加载 Pandas;若需要为前端提供数据支撑,用 FastAPI 启动第一个 REST 接口。明确目标、按需深耕,才能最大限度地发挥 Python 的生态威力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















