


Python自动化办公常用库推荐:处理Excel、PDF与邮件
深入解析Python自动化办公中处理Excel、PDF和邮件的常用库。从功能定位、适用场景、核心示例到选型避坑,帮助开发者与办公人员构建稳定高效的工作流。
在日常办公自动化中,数据处理、文档归档与信息分发是频次最高的三类任务。本文针对表格(Excel)、版式文档(PDF)和通信传递(邮件)三大核心对象,梳理当前主流 Python 库的核心定位、选型对比、代码范式与工程实践避坑要点,提供切实的落地指引。
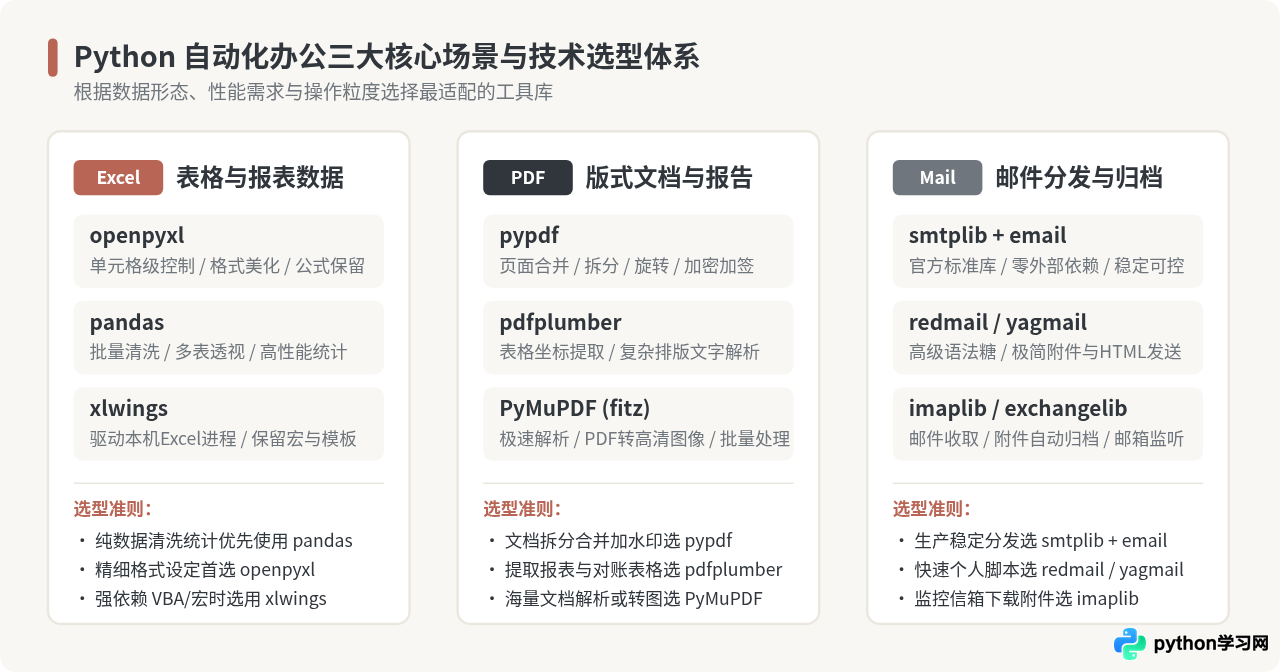
一、办公自动化三大核心场景与技术版图
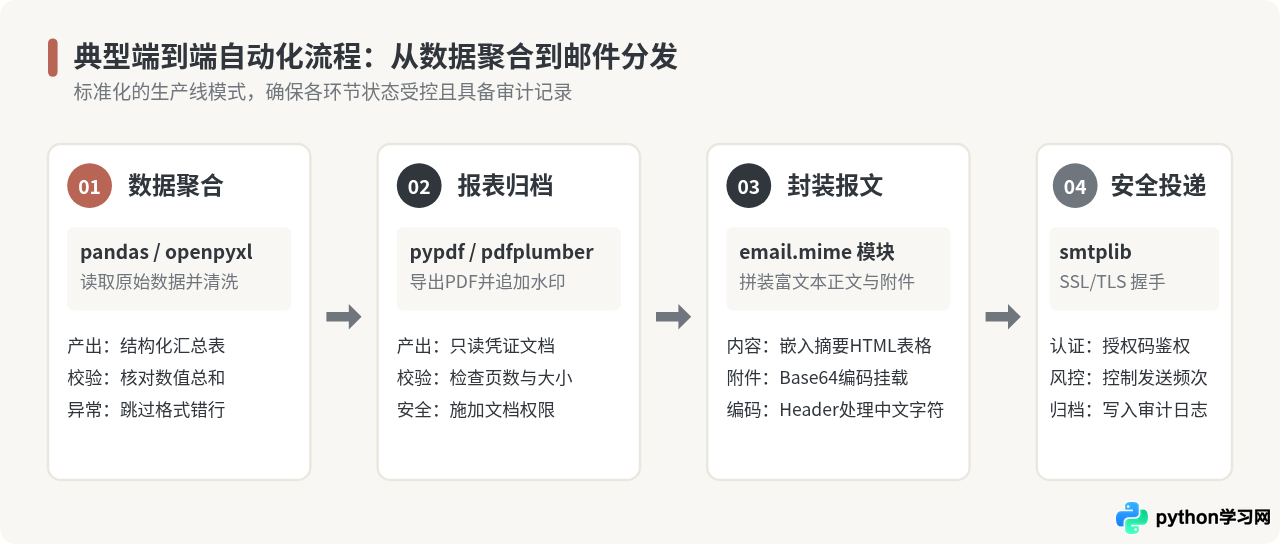
办公自动化的本质是将机械化、重复性的信息搬运工作交由脚本处理。无论是财务对账、销售周报生成,还是员工考勤统计,其标准业务链路通常都遵循“读取表格计算指标 → 汇总生成只读凭证文档 → 自动化打包发送给对应负责人”这一闭环。
在 Python 生态中,针对这三类场景存在多种工具库。很多初学者容易误将“数据分析工具”当成“报表排版工具”,或忽视了底层格式的本质差异。在动手编写脚本前,必须先看清各类库的能力边界。
二、Excel 处理库推荐与选型实践
Excel(主要是 .xlsx 格式)在本质上是由 XML 文件构成的压缩包。根据任务重心是“数值清洗”还是“排版展示”,通常在 openpyxl、pandas 与 xlwings 之间进行选择。
1. openpyxl:精细化读写与样式呈现
openpyxl 是目前纯 Python 环境下操作 .xlsx 文件的首选库。它不需要宿主机安装 Microsoft Office 软件,支持完整的行、列、单元格读写,以及字体、填充颜色、边框、对齐方式、条件格式和公式的写入。
当你需要基于一个预设了企业表头样式的模板填入数据,或者对异常数据单元格进行高亮标记时,openpyxl 是最合适的选择。
from openpyxl import load_workbook
from openpyxl.styles import PatternFill, Font

# 加载现有工作簿
wb = load_workbook("sales_report.xlsx")
ws = wb.active

# 定义警示高亮样式
warning_fill = PatternFill(start_color="FADBD8", end_color="FADBD8", fill_type="solid")
bold_font = Font(name="PingFang SC", size=11, bold=True, color="922B21")

# 遍历第 2 行至末尾,检查第 3 列(销售额)
for row_idx in range(2, ws.max_row + 1):
    cell = ws.cell(row=row_idx, column=3)
    # 假定数值低于 1000 时进行醒目标记
    if isinstance(cell.value, (int, float)) and cell.value < 1000:
        cell.fill = warning_fill
        cell.font = bold_font

# 写入公式计算总计
ws[f"C{ws.max_row + 1}"] = f"=SUM(C2:C{ws.max_row})"
wb.save("sales_report_highlighted.xlsx")
2. pandas:高效批量统计与数据清洗
如果任务的核心是“将 50 个销售分部的明细表合并为一张大表,并计算各品类的月度同比”,则不应该用 openpyxl 逐格循环。pandas 专为矢量化数据运算而生,底层基于 C/NumPy 优化,能以几行代码完成多表合并、去重、分组聚合与透视计算。
import pandas as pd
import glob

# 批量读取并合并所有分支机构的数据表
all_files = glob.glob("branches/*.xlsx")
df_list = [pd.read_excel(f, sheet_name="明细") for f in all_files]
combined_df = pd.concat(df_list, ignore_index=True)

# 基础数据清洗与透视统计
cleaned_df = combined_df.dropna(subset=["销售额", "品类"])
summary = cleaned_df.groupby("品类")["销售额"].agg(["count", "sum", "mean"]).reset_index()
summary.columns = ["品类", "订单笔数", "总销售额", "平均客单价"]

# 导出为新的统计报表
summary.to_excel("monthly_category_summary.xlsx", index=False)
3. xlwings:连接本机 Excel 与 VBA 生态
当工作簿内含有极其复杂的 VBA 宏、嵌套图表模板,或者需要将 Excel 转换为无失真的 PDF 时,纯 Python 解析库很难完全还原 Excel 原生的排版引擎。xlwings 通过 COM 接口(Windows)或 AppleScript(macOS)直接操控本机的 Excel 进程。其代价是执行速度受限于桌面程序启动,且服务器环境必须安装 Office。
1. 公式缓存陷阱:用 openpyxl 打开带公式的 Excel 文件时,若设置 data_only=True,读取的是上次 Excel 软件保存时缓存的计算结果。如果该文件是由另一个没有真实计算引擎的脚本直接写入的,读出的值可能为 None。
2. 内存泄漏与大文件:处理超过 20 万行的数据时,直接用 openpyxl.load_workbook() 会消耗数 GB 内存;此时必须使用只读模式 load_workbook(..., read_only=True),或者采用 pandas 分块读取。
三、PDF 处理库推荐与场景拆解
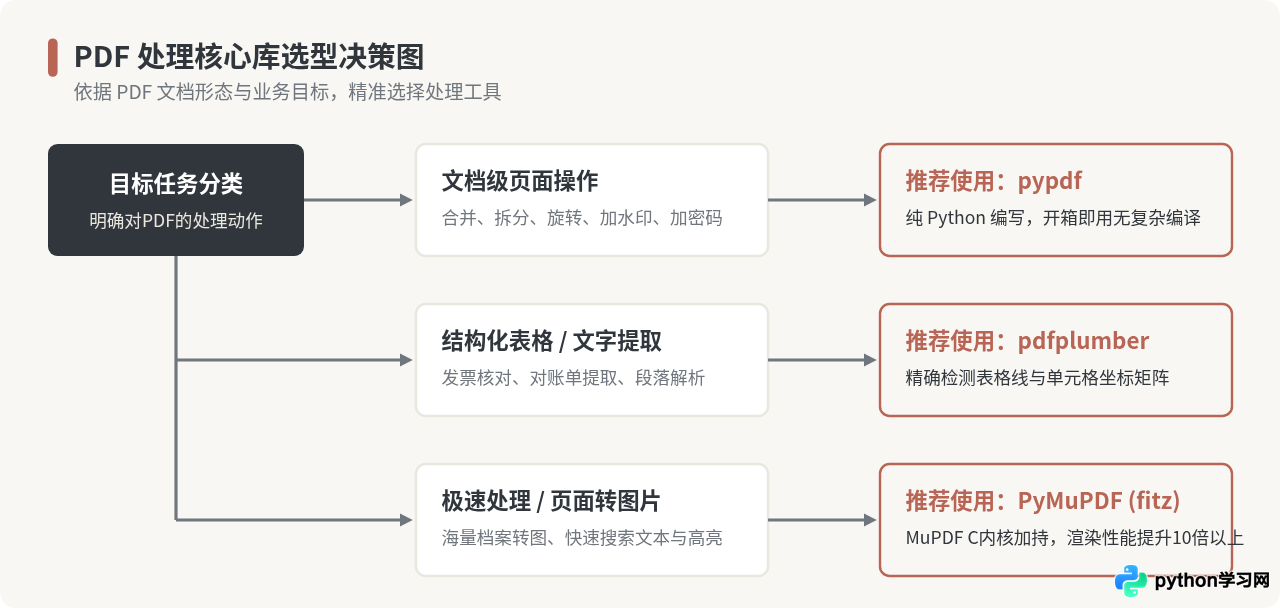
PDF(Portable Document Format)的设计初衷是“保证任何终端显示一致的版式文档”,因此其底层记录的是字符与图形的绝对坐标,并非如 Word 或 HTML 那样具备流式结构。这就导致了“修改 PDF”远比“修改 Excel”困难得多。常见的任务主要是页面合并拆分、表格抽取与格式渲染。
1. pypdf:纯 Python 的多页面组织利器
pypdf(曾命名为 PyPDF2,现已回归合并为主分支 pypdf)适用于不需要深入解析文字语义的文档级操作,如批量拼接报告、追加水印页、截取前几页做摘要、给合同设置查看密码等。
from pypdf import PdfWriter, PdfReader

# 合并多个 PDF 文档
writer = PdfWriter()
files = ["cover.pdf", "body_content.pdf", "appendix.pdf"]

for file in files:
    reader = PdfReader(file)
    for page in reader.pages:
        writer.add_page(page)

# 加密保护导出的文档
writer.encrypt(user_password="client_guest_pass", owner_password="admin_root_pass")

with open("final_merged_report.pdf", "wb") as f_out:
    writer.write(f_out)
2. pdfplumber:高精度表格解析提取
pdfplumber 专注于从文本型 PDF 中抽离版面与表格数据。它通过对 PDF 流中的直线(lines)、矩形(rects)和字符位置进行物理几何比对,能够精准识别并导出完整的二维列表,可以直接转为 pandas.DataFrame 处理。
import pdfplumber
import pandas as pd

table_data = []
with pdfplumber.open("invoice_sample.pdf") as pdf:
    # 解析第一页
    page = pdf.pages[0]
    extracted_tables = page.extract_tables()
    if extracted_tables:
        # 获取首个识别出的表格
        table_data = extracted_tables[0]

# 将二维列表转换为 DataFrame(第一行为表头)
if table_data:
    df_invoice = pd.DataFrame(table_data[1:], columns=table_data[0])
    print("提取出的明细数据:\n", df_invoice.head())
3. PyMuPDF (fitz):极限性能与图像化渲染
在面对数百页的长篇扫描档案,或者需要将 PDF 每一页无损转为高分辨率 PNG 图片进行预览展示时,PyMuPDF(在代码中导入为 fitz)具备无与伦比的性能优势。它基于 C 语言编写的高性能渲染引擎 MuPDF,解析速度比纯 Python 库快一个数量级。
很多初学者在提取 PDF 文字时发现结果为空,误以为是代码错误。实际上,若 PDF 是由扫描仪扫描纸质合同生成的,其内部本质是一张位图图片,没有任何字符信息。此时必须引入 OCR 工具(如 pytesseract 或 PaddleOCR)对图像进行文字识别,而非依靠常规的 PDF 解析库。
四、邮件自动化库推荐与工程落地
在完成报表整理与 PDF 导出后,最后一步是将产物准确分发给目标人群。邮件协议(SMTP 发送、IMAP/POP3 接收)非常成熟,但在处理富文本 HTML 排版、文件附件编码以及网络连接安全时,容易遇到细节坑。
1. smtplib 与 email 模块:工业级稳妥方案
Python 标准库内置的 smtplib 与 email 模块是生产环境中最推荐的方案。它不引入任何第三方依赖,严格遵循 RFC 5322 与 MIME 规范,透明且不易受到外部包版本变更的影响。
import smtplib
from email.mime.multipart import MIMEMultipart
from email.mime.text import MIMEText
from email.mime.application import MIMEApplication
from email.header import Header
import os

# 1. 构造多部分邮件容器
msg = MIMEMultipart()
msg["From"] = Header("数据监控中心 <sender@company.com>", "utf-8")
msg["To"] = Header("运营负责人 <manager@company.com>", "utf-8")
msg["Subject"] = Header("【自动化周报】本周销售与对账总览", "utf-8")

# 2. 挂载 HTML 正文
html_content = """
<h3>各位同事:</h3>
<p>本周销售明细与财务对账单已完成自动汇总,请查阅下方核心指标及附件。</p>
<ul>
  <li><strong>总销售额:</strong>¥ 1,280,500.00</li>
  <li><strong>完成率:</strong>104.2%</li>
</ul>
"""
msg.attach(MIMEText(html_content, "html", "utf-8"))

# 3. 挂载 PDF 附件
pdf_path = "final_merged_report.pdf"
if os.path.exists(pdf_path):
    with open(pdf_path, "rb") as f:
        part = MIMEApplication(f.read(), Name=os.path.basename(pdf_path))
        # 针对含中文附件名的标准化编码
        part.add_header("Content-Disposition", "attachment", filename=("utf-8", "", "本周销售对账报告.pdf"))
        msg.attach(part)

# 4. 通过 SSL 安全加密连接发送(以常见企业邮箱 465 端口为例)
SMTP_SERVER = "smtp.company.com"
SMTP_PORT = 465
AUTH_USER = "sender@company.com"
AUTH_CODE = os.environ.get("MAIL_AUTH_CODE", "YOUR_AUTH_CODE")

with smtplib.SMTP_SSL(SMTP_SERVER, SMTP_PORT) as server:
    server.login(AUTH_USER, AUTH_CODE)
    server.sendmail(AUTH_USER, ["manager@company.com"], msg.as_string())
print("周报邮件投递成功。")
2. 现代封装库:redmail 与 yagmail
如果是个人日常脚本或测试用途,标准库繁琐的 MIME 对象组装可能显得冗长。此时可以选用 redmail 或 yagmail。这类库把 HTML 模板渲染、附件添加、多收件人拆分等逻辑高度抽象化,通常只需调用 gmail.send(to=..., subject=..., contents=...) 即可完成任务。
3. 邮件监听与附件下载:imaplib
自动化的另一端是“收取用户回传的表格并自动归档”。标准库的 imaplib 配合 email 解析器,可以定时轮询公共收件箱,根据主题过滤邮件,自动剥离其中的 Excel 或 PDF 附件,存储至待处理目录并触发后续流水线。
1. 严禁明文密码:绝不能将邮箱登录密码直接硬编码在 Python 源码中。主流邮箱(如 QQ、163、Gmail、企业邮箱)均要求开启“POP3/SMTP服务”并生成专用的独立授权码,并通过操作系统环境变量或配置文件注入。
2. 频率控制与封禁防范:批量群发(如给 500 位客户发送独立账单)时,必须在循环间加入随机休眠(如 time.sleep(2)),否则极易触发邮件服务商的防垃圾机制导致 IP 或账号被临时封禁。
五、常用库选型矩阵与决策建议
为了让不同需求场景下的工具选取更加直观,下表对上述涉及的全部库进行了横向对比:
| 领域 | 库名称 | 定位与最大长处 | 主要局限 / 不适用场景 | 安装命令 |
|---|---|---|---|---|
| Excel | openpyxl |
格式精细化操作、保留公式、无须Office环境 | 超大文件(几十万行)耗内存,无图表计算引擎 | pip install openpyxl |
pandas |
大规模表格向量化计算、多表关联、数据透视 | 不擅长微调单元格视觉样式(颜色、边框等) | pip install pandas openpyxl |
|
xlwings |
调用本机真实Excel,完美兼容复杂VBA与模板 | 强依赖桌面系统与Office安装,无法纯无头云部署 | pip install xlwings |
|
pypdf |
轻量级页面拆分、合并、旋转、加密 | 无法精细还原表格结构,不提供原生渲染能力 | pip install pypdf |
|
pdfplumber |
基于物理坐标的精准表格与段落提取 | 纯Python计算,处理超大篇幅扫描件速度较慢 | pip install pdfplumber |
|
PyMuPDF |
MuPDF内核加持,超高速解析、渲染转高清图片 | C底层编译依赖,轻微增加依赖包体积 | pip install pymupdf |
|
| 邮件 | smtplib + email |
Python官方内置,零依赖,底层严格符合RFC标准 | MIME对象装配代码较繁琐,新手上手门槛稍高 | 内置模块,无需安装 |
redmail / yagmail |
现代高级语法糖封装,发附件与HTML极简 | 第三方依赖项,定制底层复杂网络代理相对受限 | pip install redmail |
六、工程化落地全景与避坑总结
将上述零散的库串联成能够在企业生产环境或后台定时任务中稳定运行的流水线,还需要在工程规范上建立以下四道防护墙:
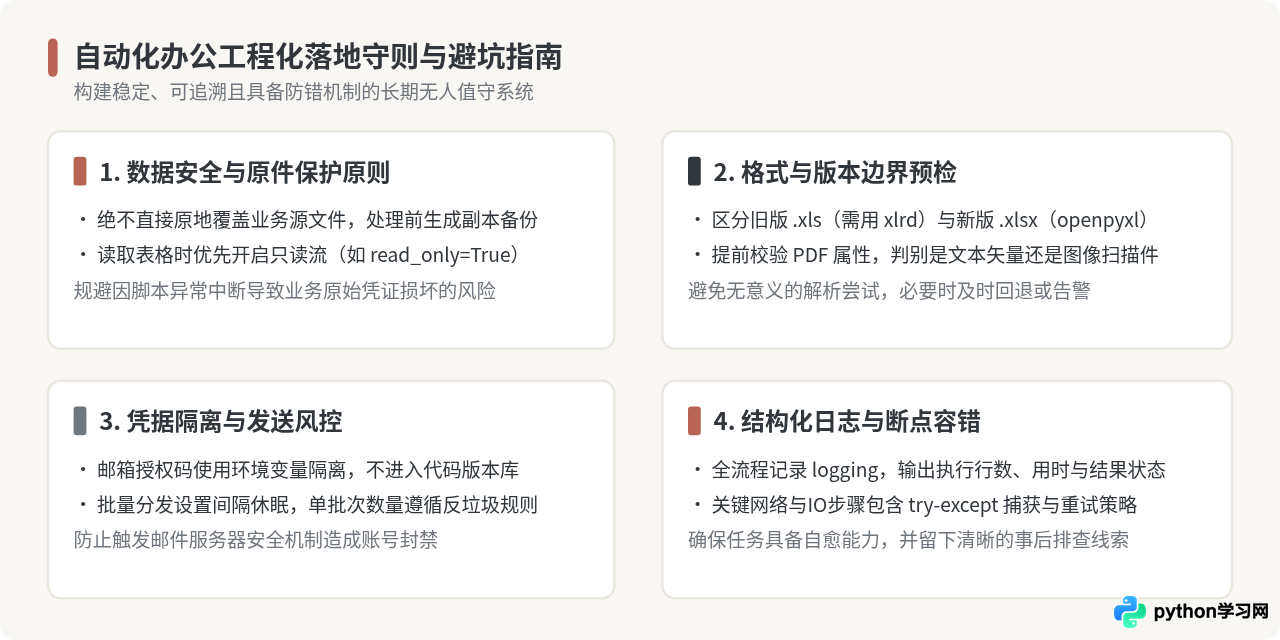
通过合理结合 pandas 的数据计算力、openpyxl 的格式表现力、pypdf / pdfplumber 的文档提取力,以及 smtplib 的标准化投递通道,开发者便能以最低的代码维护成本,搭建起一条高可用、高质量的自动化办公流水线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















