


llama.cpp b12474 在哪里传入 Qwen3-Next 的输出投影缩放?
发布时间:2026-11-17 |
9人浏览过
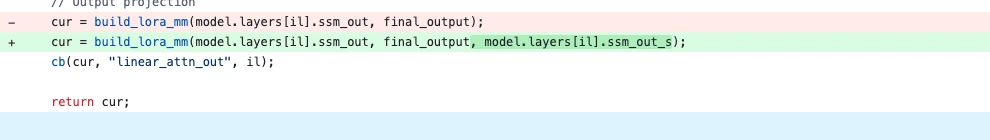
llama.cpp b12474 在 Qwen3-Next 的线性注意力输出投影调用中,将同一层的 ssm_out_s 作为第三个参数传给 build_lora_mm。
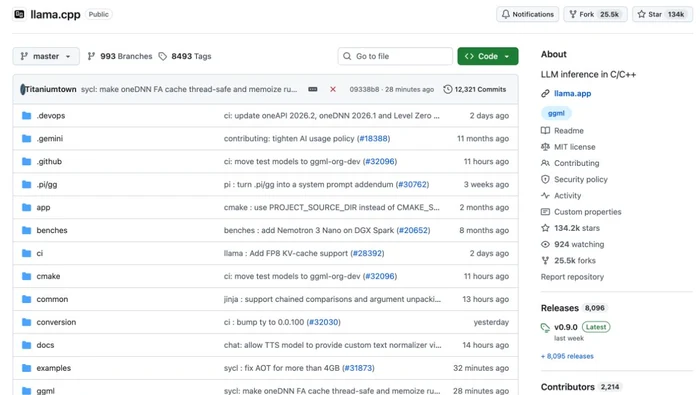
缩放接在线性注意力的哪一步
build_layer_attn_linear 在返回前把 final_output 送入输出投影。修复前参数包含 ssm_out 与 final_output,本次增加的是该层的输出缩放张量。
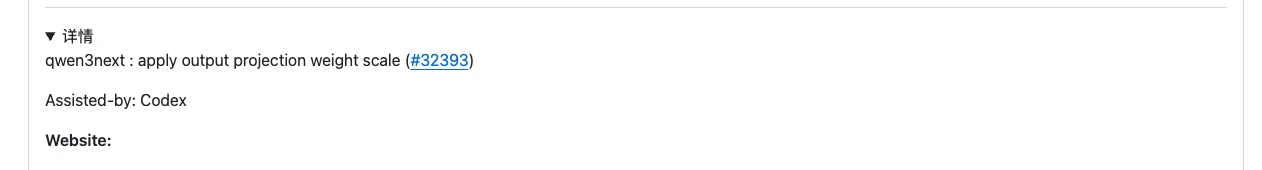
怎样理解这个参数
这项改动让现有推理图构建使用对应的权重缩放。官方差异定位在这条架构路径,加载其他架构模型时采用各自的图实现。
预发布说明给出了哪些结果
该修复编号对应 llama.cpp b12474。发布说明和差异确认的是计算步骤的变化,未提供推理速度或模型质量对照。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















