


Python数据分析实战案例:从数据清洗到可视化的完整流程演示
通过真实电商交易数据案例,详细演示从数据探索、清洗规整、聚合统计到图表可视化的Python数据分析完整实战流程。
在日常数据工作中,真实业务数据很少能拿来直接建模或画图。原始导出的表格通常伴随着字段类型不匹配、异常字符干扰、缺失值以及重复记录等问题。本文通过一份模拟但具备典型业务缺陷的电商零售交易数据集,完整演示在 Python 环境下从数据加载、质量探查、数据清洗、多维统计聚合到最终图表呈现的闭环流程,帮助读者掌握标准化的数据处理逻辑。
一、数据分析全流程概述
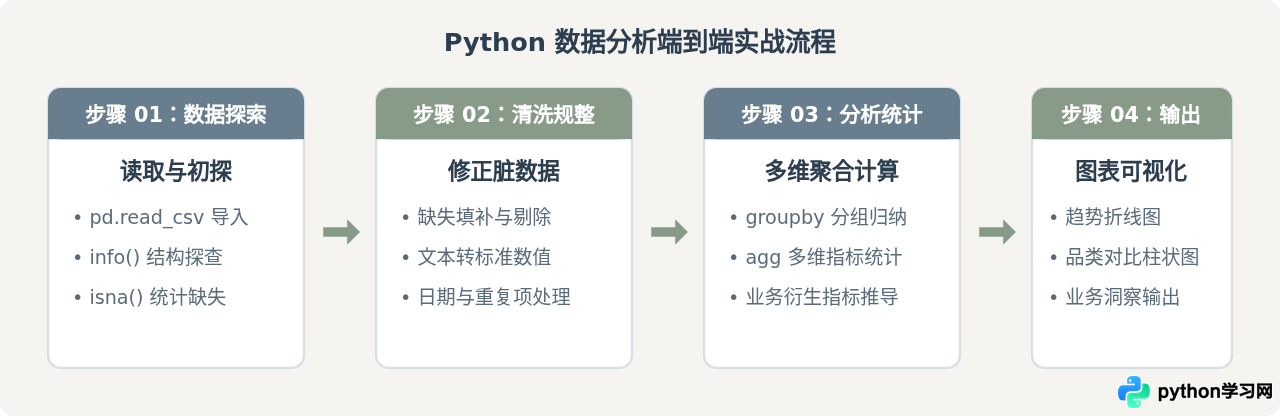
一套规范的数据分析工作流通常包含四个核心阶段:首先是数据的读入与结构探索,确认字段基本概况;其次是数据清洗与类型规范化,解决缺失、乱码与格式错误;随后依据业务问题进行切片、分组与聚合运算;最后将提炼出的指标通过图表直观输出。各环节承前启后,清洗质量直接决定了后续统计结果的准确性。
二、环境配置与构建实战数据源
演示使用的基础依赖库为 pandas、numpy 与 matplotlib。在终端中可通过 pip install pandas numpy matplotlib 完成安装。
为了完整展现真实场景中的清洗难点,我们直接构造包含以下典型缺陷的电商订单样本:
- 价格字段混有货币符号
$与多余空格,导致被误识别为字符串(object类型); - 日期格式不统一,存在类似
2023/10/01与2023-10-02的混用; - 购买数量字段包含缺失值(
NaN); - 包含完全一致的重复行记录。
import pandas as pd
import numpy as np

# 构造模拟原始交易数据
raw_data = {
    'order_id': ['ORD_101', 'ORD_102', 'ORD_103', 'ORD_104', 'ORD_105', 'ORD_105', 'ORD_106'],
    'order_date': ['2023-11-01', '2023/11/01', '2023-11-02', '2023-11-03', '2023-11-03', '2023-11-03', '2023-11-04'],
    'category': ['数码配件', '办公文具', '数码配件', '日用百货', '办公文具', '办公文具', '数码配件'],
    'unit_price': ['$ 129.50', '$ 15.00', ' $ 299.00 ', '$ 45.20', '$ 89.00', '$ 89.00', '$ 150.00'],
    'quantity': [2.0, 10.0, np.nan, 3.0, 5.0, 5.0, 1.0]
}

df = pd.DataFrame(raw_data)
print("=== 原始数据预览 ===")
print(df)
print("\n=== 数据类型与缺失统计 ===")
print(df.info())
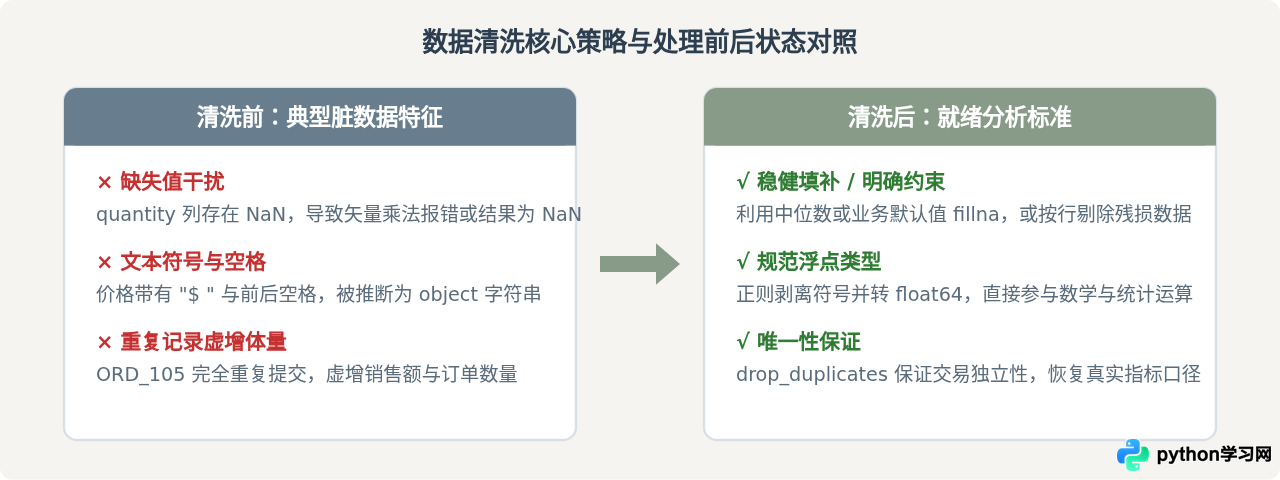
打印结果会显示 unit_price 为 object 类型,无法直接进行求和或均值计算;quantity 只有 6 条非空记录;同时 ORD_105 存在重复记录。这些都是数据进入分析计算前必须规整的目标。
三、核心环节:数据清洗与规整实战
数据清洗不是单一的删除操作,而需要根据业务特性在“直接剔除”与“合理填补/转换”之间做出选择。例如,对于数值型缺失,若随意删除会导致样本量缩减并引入选择性偏差;而若错误填补则会虚构指标。
1. 重复项核查与清除
首先调用 drop_duplicates() 清除多余的重复订单行。若仅依据部分字段判断重复,可指定 subset=['order_id'] 参数。
# 移除完全重复记录
df_cleaned = df.drop_duplicates().copy()
2. 字符串符号清理与数值转换
对 unit_price 列,使用 str.replace 将货币符号 $ 和多余空格清除,随后通过 astype(float) 转换为可计算的浮点数值类型:
# 清理货币符号并转为浮点型
df_cleaned['unit_price'] = df_cleaned['unit_price'].astype(str).str.replace('$', '', regex=False).str.strip().astype(float)
3. 日期时间规范化
通过 pd.to_datetime() 将混杂格式的日期文本解析为标准的 datetime64[ns]。该函数能自适应斜杠与短横线分隔符,便于后续按日、周、月做时间维度的切分与提取。
# 统一转换为标准日期对象
df_cleaned['order_date'] = pd.to_datetime(df_cleaned['order_date'])
4. 缺失值处理对比:填补 vs 剔除
面对缺失值主要有两种策略:直接剔除(dropna)与数值填补(fillna)。二者的选择需遵循严谨的业务边界:
- 直接剔除:适合核心业务主键缺失或样本体量极大、缺失极少的场景。缺点是会损失整行关联信息。
- 统计值填补:针对连续变量通常采用中位数(
median)或均值(mean)。在偏态分布中,中位数比均值更具抗干扰能力。在本例中,零售订单通常有最小起购量,缺失可填补为 1.0 或该品类中位数。
# 填补数量列缺失值为 1.0(业务保底件数),并计算总金额
df_cleaned['quantity'] = df_cleaned['quantity'].fillna(1.0)
df_cleaned['total_amount'] = df_cleaned['unit_price'] * df_cleaned['quantity']

print("=== 清洗后的干净数据 ===")
print(df_cleaned[['order_id', 'order_date', 'category', 'unit_price', 'quantity', 'total_amount']])df['col'][mask] = val),这容易触发 Pandas 的 SettingWithCopyWarning。推荐统一使用 .loc[row_indexer, col_indexer] 或显式使用 .copy() 创建副本。
四、多维聚合与业务指标分析
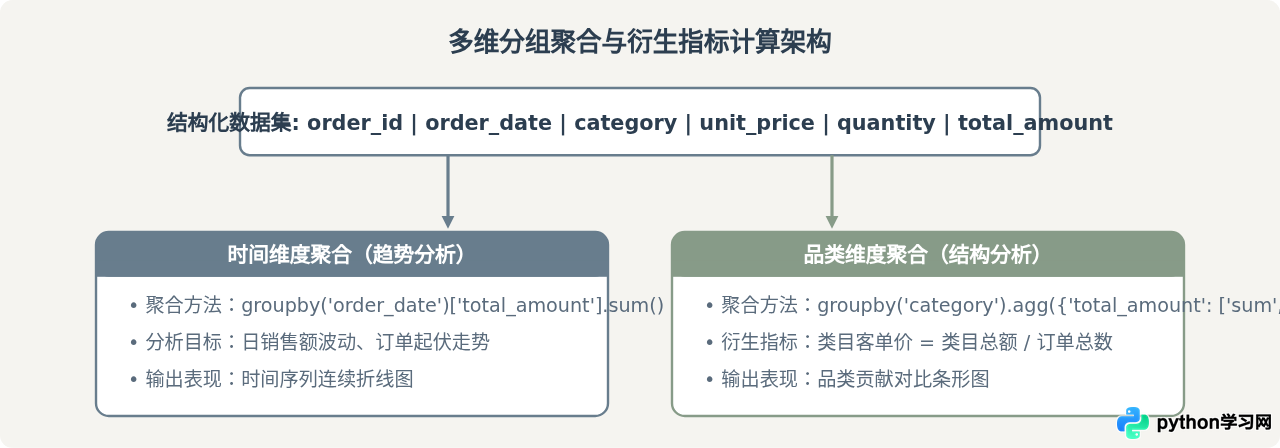
数据完成规整后,即可进行指标计算与分组统计。最常见的需求是按商品品类统计营业额、销量均值与客单价,以及按时间序列洞察增长节奏。
利用 agg 进行多指标组合计算
在 Pandas 中,groupby 结合 agg 能够一次性计算多个统计量。计算完毕后,建议调用 reset_index() 将分组索引平铺回标准列,方便后续传递至绘图模块。
# 按品类汇总指标
category_summary = df_cleaned.groupby('category').agg(
    total_sales=('total_amount', 'sum'),
    total_qty=('quantity', 'sum'),
    order_count=('order_id', 'count')
).reset_index()

# 衍生指标:品类均单价值
category_summary['avg_order_value'] = (
    category_summary['total_sales'] / category_summary['order_count']
).round(2)

print("=== 品类汇总统计表 ===")
print(category_summary)
五、结果呈现:图表可视化实战
得到汇总数据后,可以通过 matplotlib.pyplot 进行图表可视化。绘图时需特别注意中文字符显示配置,避免出现中文乱码(显示为方框)的问题。
import matplotlib.pyplot as plt

# 配置中文字体与负号正常显示
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 创建画布与子图
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))

# 子图 1:各品类销售总额柱状图
bars = ax1.bar(category_summary['category'], category_summary['total_sales'], color='#687D8D', width=0.5)
ax1.set_title('各商品品类总销售额对比', fontsize=13, pad=12)
ax1.set_xlabel('商品品类')
ax1.set_ylabel('销售额 (元)')
ax1.grid(axis='y', linestyle='--', alpha=0.5)

# 在柱状图上方标注具体数值
for bar in bars:
    height = bar.get_height()
    ax1.annotate(f'{height:.1f}',
                 xy=(bar.get_x() + bar.get_width() / 2, height),
                 xytext=(0, 3), textcoords="offset points",
                 ha='center', va='bottom', fontsize=10)

# 子图 2:每日销售趋势折线图
daily_trend = df_cleaned.groupby('order_date')['total_amount'].sum().reset_index()
ax2.plot(daily_trend['order_date'].dt.strftime('%m-%d'), daily_trend['total_amount'],
         marker='o', color='#879B88', linewidth=2, markersize=6)
ax2.set_title('每日销售总额走势', fontsize=13, pad=12)
ax2.set_xlabel('交易日期')
ax2.set_ylabel('销售额 (元)')
ax2.grid(True, linestyle='--', alpha=0.5)

plt.tight_layout()
plt.show()
在生成的双图结构中,左侧柱状图直观反映了“数码配件”属于高额营收的核心支撑类目;右侧折线图展示了订单在 11 月 1 日至 11 月 4 日期间的动态起伏,为经营复盘提供了直观依据。
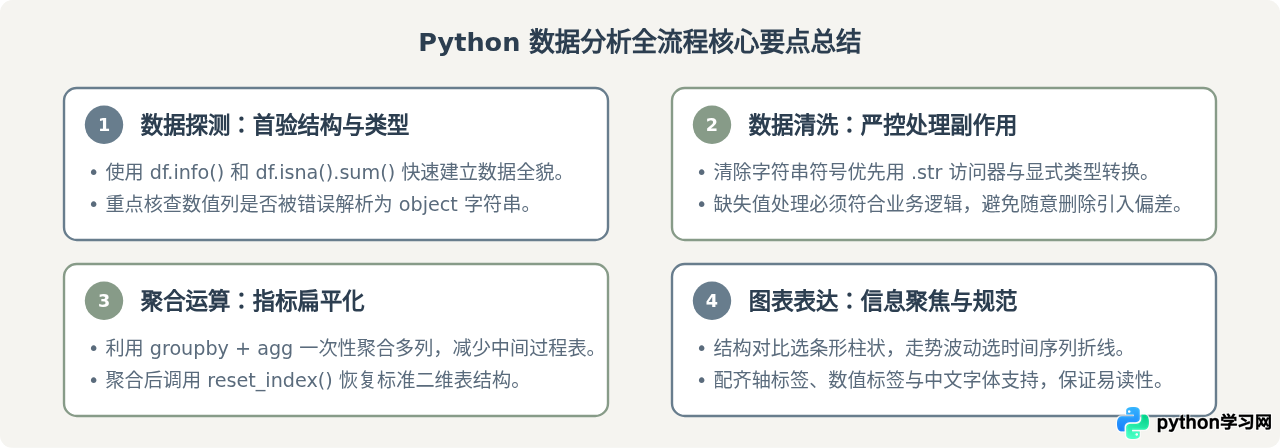
六、全流程关键要点总结
回顾从数据读入到可视化的全流程,每个环节都有其关键操作准则与防错要点:
七、常见问题排查与注意事项
-
为什么使用
pd.to_datetime后依然无法按时间索引筛选?
解析日期列后,它仍然是 DataFrame 的普通列。如果需要使用类似df['2023-11']的时间范围切片功能,必须通过df.set_index('order_date')将其设置为行索引(DatetimeIndex)。 -
如何避免多重索引(MultiIndex)带来的列名访问繁琐?
在使用agg({'total_amount': ['sum', 'mean']})时会生成层级列名。可以通过扁平化命名语法(如agg(sales_sum=('total_amount', 'sum')))直接在聚合时定义扁平列名,使代码保持清爽易维护。 -
数据量较大时,Pandas 运算速度变慢如何优化?
优先使用 Pandas 自带的向量化运算(Vectorized Operations),尽量避免使用for循环或iterrows()遍历行。对于极其庞大的数据集,可适当优化字段的数据类型(例如将 64 位浮点转换为 32 位,或将低基数字符串转换为category类型)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















