


Python join方法:将split分割后的列表重组为字符串
深入解析Python中如何利用str.join()方法将split分割后的列表重新拼接重组为字符串,涵盖核心语法、设计哲学、数据清洗转换步骤与高频避坑指南。
在 Python 日常开发与数据清洗中,字符串与列表之间的相互转换是一项基础且高频的操作。当我们需要对文本进行提取、过滤、去重或调整定界符时,通常先用 str.split() 将原始字符串拆分成元素列表,完成处理后,再借助 str.join() 将列表中的元素重新黏合成符合预期的全新字符串。本文将围绕这两个核心方法的协同运作机制展开,解析语法规则、操作流程、常见陷阱与性能考量。
一、核心机制:split 与 join 的逆向流转模型
split() 与 join() 在 Python 中互为反向操作。split() 负责“由整化零”,以特定分隔符切断字符串并输出列表;而 join() 负责“化零为整”,将可迭代对象中的字符串单元通过指定连接符汇聚为单个长字符串。
最基本的协作代码如下所示:
# 1. 原始字符串按逗号切分为列表
raw_text = "apple,banana,orange,grape"
items = raw_text.split(",")
# 此时 items 为: ['apple', 'banana', 'orange', 'grape']

# 2. 将列表重组为以制表符或自定义符号连接的新字符串
rejoined_text = " | ".join(items)
# 此时 rejoined_text 为: 'apple | banana | orange | grape'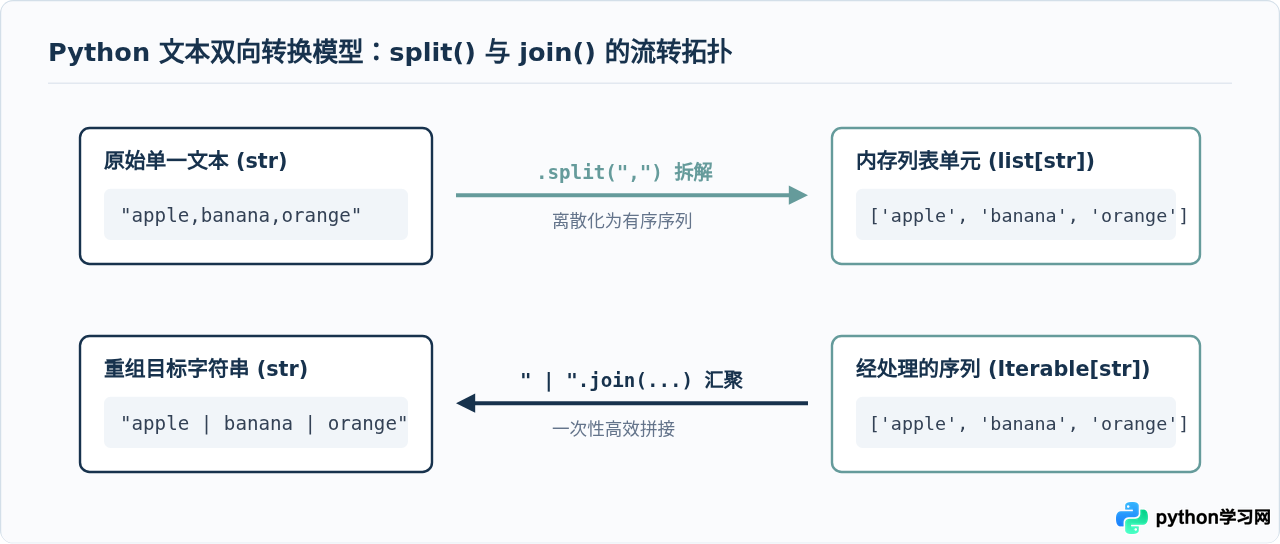
二、设计解析:为什么是 separator.join(list) 而非 list.join(separator)?
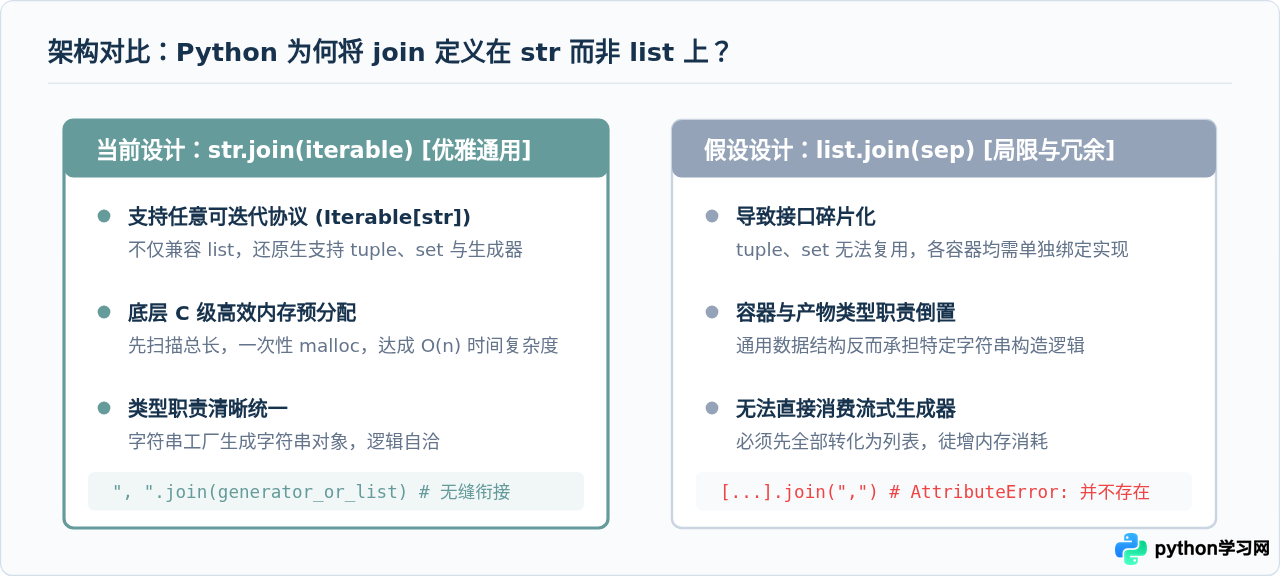
很多刚接触 Python 的开发者常会产生疑惑:既然操作的对象是列表,为什么不是调用 list.join("-"),而是反过来用字符串分隔符调用 "-".join(list)?
如果尝试写出 [...].join(","),Python 解释器会直接抛出报错:
AttributeError: 'list' object has no attribute 'join'这种设计背后蕴含着 Python 核心团队对类型系统和内存效率的深层考量:
- 通用协议支持(面向所有 Iterable):
join方法的目标是连接任意包含字符串的可迭代对象。除了list之外,它还能直接接收tuple、set、字典键视图、生成器表达式(generator)等。如果将方法挂载在list上,那么其他容器类就必须重复实现相同的逻辑,违背了代码复用原则。 - 职责单一性与内存预分配:
join生成的最终产物是字符串(str),由str类型负责创建对象更为符合面向对象设计职责。在 CPython 底层实现中,join会先遍历一次可迭代对象,精确计算出所有字符串与分隔符的总字节长度,并在内存中一次性申请足够的连续内存空间,再依次将字符复制进去。这种机制将时间复杂度严格控制在 $O(n)$,避免了频繁重新申请内存带来的性能浪费。
三、标准操作流程:文本分割重组的四步流水线
在实际应用中,从 split 分割到最终 join 拼接之间,通常需要经历清洗多余空白、筛选无效项或类型转换。规范的操作流程可以归纳为以下 4 个阶段:
- 步骤 1:精确切分(Split):依据数据结构选用默认空白切割或显式字符切割。
- 步骤 2:数据过滤与清洗(Filter & Clean):剔除空字符串、去除各元素两端的杂质字符(如换行符、首尾空格)。
- 步骤 3:类型守卫与转换(Type Casting):确保每个待拼接项都是合法的
str类型,防止类型报错。 - 步骤 4:指定定界符重组(Join):选定目标分隔符(如逗号、空格、下划线、换行符),调用
join()输出重构文本。
# 原始带有格式瑕疵的脏数据
raw_data = "  alpha, beta,, gamma , delta,  1024  "

# 步骤 1:按逗号切分
tokens = raw_data.split(",")

# 步骤 2:数据清洗,去除两端空白并过滤空串
cleaned_tokens = [item.strip() for item in tokens if item.strip()]

# 步骤 3:类型保证(若列表中存在数值或其他类型,需转为 str)
string_tokens = [str(x) for x in cleaned_tokens]

# 步骤 4:以破折号重构成规范标识串
normalized_result = " -> ".join(string_tokens)

print(normalized_result)
# 输出: alpha -> beta -> gamma -> delta -> 1024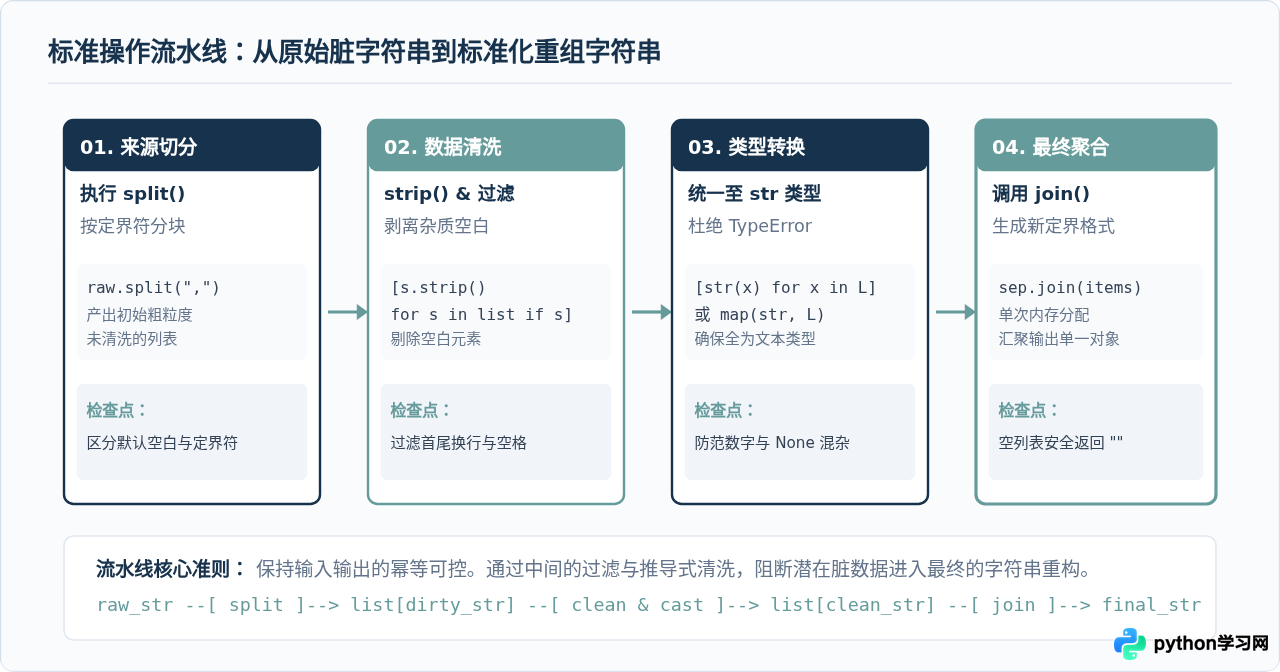
四、高频陷阱与必须掌握的注意事项
尽管 split() 与 join() 使用简单,但在实际运行中若忽略边界条件,很容易引发运行时错误或不符合预期的输出。
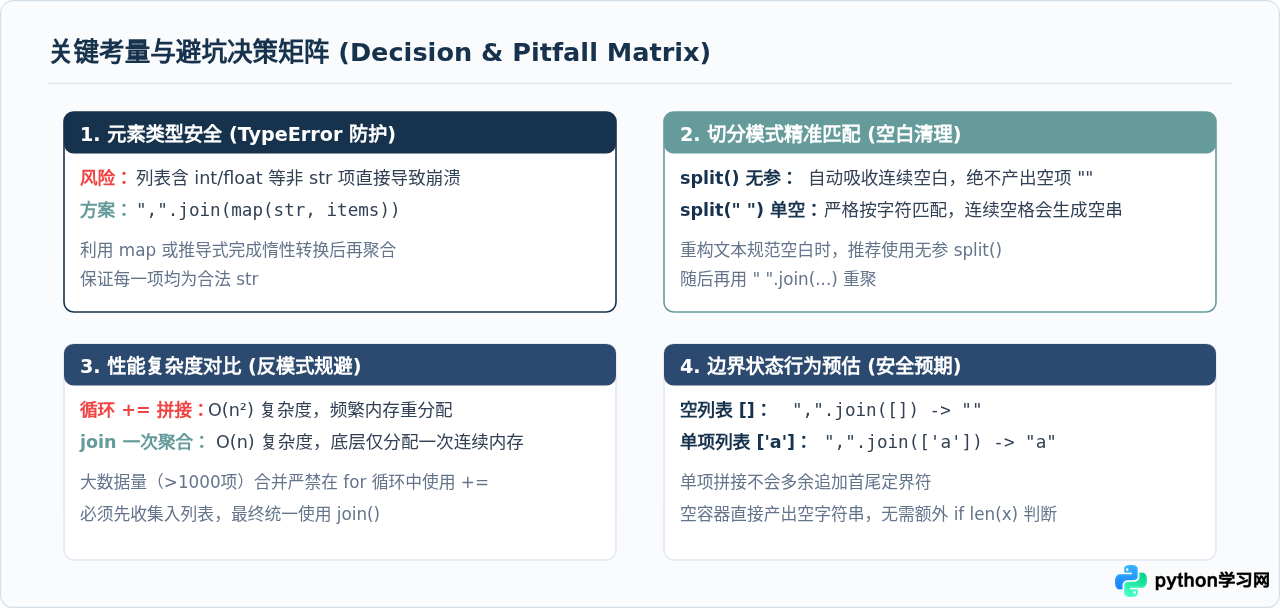
1. TypeError:列表中含有非字符串元素
这是初学者最常遇到的问题。join() 要求被迭代的序列中每一项都必须是 str 实例。如果列表中混入了 int、float 或 None,哪怕只有一个元素不是字符串,也会立刻引发 TypeError:
ids = [101, 102, 103, 104]

# 错误做法:直接 join
# 抛出: TypeError: sequence item 0: expected str instance, int found
result = ",".join(ids)

# 正确做法 1:使用生成器推导式
result = ",".join(str(i) for i in ids)

# 正确做法 2:使用 map 转换
result = ",".join(map(str, ids))建议:当数据源来自数据库查询结果、JSON 解析或数值计算时,在调用 join() 之前统一使用 map(str, data) 或列表推导式做防御性类型转换。
2. 显式切分 split(" ") 与无参数 split() 的差异
很多开发者认为 text.split(" ") 和 text.split() 完全等价,实则不然:
text.split()(不传参):将任意连续的空白字符(包括连续空格、制表符\t、换行符\n)统一视作单一分隔符,并自动丢弃开头和结尾的空白,绝不产生空字符串元素""。text.split(" ")(传单个空格字符):严格按单个空格划分。如果有连续两个空格,两者之间将被拆出一个空字符串""。
line = "hello    world   python\n"

# 模式 A:默认切分
print(line.split())
# 得到: ['hello', 'world', 'python']
# 再通过 " ".join(...) 重组可自然消除所有多余空格,得到规整文本

# 模式 B:指定空格切分
print(line.split(" "))
# 得到: ['hello', '', '', '', 'world', '', '', 'python\n']
# 如果直接重组,多余的空字符和换行仍会遗留
3. 空列表与单元素列表的边界行为
重组操作在边界条件下的行为具有确定的确定性:
- 对于空列表
[],join()直接返回空字符串"",不会产生报错。 - 对于单元素列表
["python"],join()会直接返回该元素的内容"python",分隔符不会被加在开头或末尾。
4. 性能陷阱:为什么绝不能用 += 替代 join?
在 Python 中,字符串是不可变对象(Immutable)。如果在一个长循环中通过 s += item 逐个拼接元素,每次拼接操作都会在内存中新建一个字符串对象并复制旧内容,导致整体时间复杂度退化至 $O(n^2)$。对于上万个词条的重组,+= 会严重阻塞进程,而 join() 仅需 $O(n)$ 时间一次完成。
五、实战常见场景代码全景
场景 1:规范化凌乱多空格的文本句子
从网页或文本文件中提取出的段落常包含不规则的多重空格与换行。利用无参数 split() 自动提取非空词元,再用单空格 " ".join() 重组,是消除多余空格最简练的方案:
dirty_sentence = "This    is   a \n deeply   nested\t text string.   "

# 提取所有单词列表,忽略任意空白序列
words = dirty_sentence.split()
# words: ['This', 'is', 'a', 'deeply', 'nested', 'text', 'string.']

# 规范化为一个空格分隔的标准句子
clean_sentence = " ".join(words)
print(clean_sentence)
# 输出: This is a deeply nested text string.
场景 2:CSV/TSV 数据行字段的转换与重组
在处理格式导出时,我们常常需要把以逗号分隔的数据行转换为制表符分隔(TSV)或 Markdown 表格管道符格式:
csv_row = "1001,Alice,Engineering,95.5"

# 切分各列字段
fields = csv_row.split(",")

# 替换或增加处理(例如给每个字段添加外层括号)
formatted_fields = [f"[{f.strip()}]" for f in fields]

# 重组成 Markdown 表格行
md_row = "| " + " | ".join(formatted_fields) + " |"
print(md_row)
# 输出: | [1001] | [Alice] | [Engineering] | [95.5] |
场景 3:生成器表达式流式重组(极致节省内存)
当处理大规模数据集时,避免在内存中实例化完整列表可以显著降低内存峰值。直接将生成器表达式传入 join(),数据项将随用随取:
# 模拟由大规模数字构成的流
data_stream = range(1, 10)

# 使用生成器直接传递给 join,不额外产生中间大列表
result = "-".join(str(n * 2) for n in data_stream if n % 2 == 0)
print(result)
# 输出: 4-8-12-16
六、核心方法特性速查表
| 对比维度 | str.split(sep, maxsplit) |
str.join(iterable) |
|---|---|---|
| 调用主体 | 原字符串对象 | 目标分隔符字符串对象 |
| 主要参数 | sep(分隔符,默认空白)、maxsplit(最大切分次数) |
iterable(任意包含字符串的可迭代对象) |
| 返回值类型 | list[str] |
str |
| 元素类型约束 | 无额外约束(操作自身即为字符串) | 严格要求迭代项全为 str(否则报 TypeError) |
| 空输入表现 | "".split(",") 返回 [""];"".split() 返回 [] |
sep.join([]) 返回 "" |
| 典型应用 | 文本解构、提取字段、词元切分 | 格式化重构、URL路径拼接、CSV拼装 |
七、总结
split() 与 join() 是 Python 文本处理工具箱中相辅相成的两把瑞士军刀。在具体编码时,请牢记三个核心要领:
- 牢记语法结构是
"分隔符".join(可迭代对象),不要误用list.join(); - 在拼接前对列表元素做类型检查或
map(str, ...)转换,确保零TypeError; - 善用
split()默认参数消除多余空白,配合join()高效完成文本规范化。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















