


Python序列结构详解:列表、元组与字符串的共性
深入解析 Python 中列表(list)、元组(tuple)和字符串(str)的底层序列共性,掌握正负索引、通用切片规则、序列运算符与内置函数的实际应用。
在 Python 中,列表(list)、元组(tuple)和字符串(str)各自承担着不同的职责:列表擅长动态增删元素,元组负责固定数据与安全传递,字符串则专注于文本表达与编码。然而,无论它们内部的可变性与用途差异有多大,它们在底层都统一遵循 Python 的“序列协议”(Sequence Protocol)。这意味着只要掌握了序列结构的通用机制,就能直接迁移应用到这三种数据结构上,不必针对每种类型重复记忆操作规则。本文将围绕索引机制、切片逻辑、通用运算符及内置函数,深入梳理它们完全一致的共性行为。
一、序列抽象契约:三大核心类型的统一结构
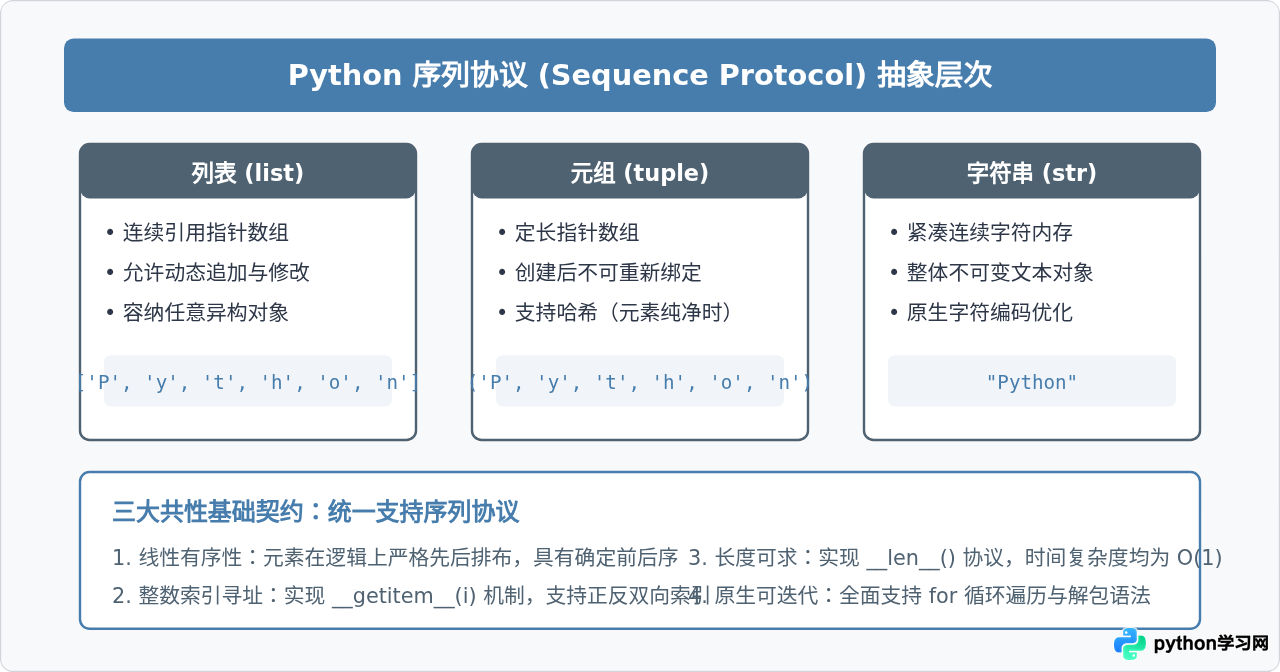
Python 中的“序列”是一组有序排列的数据集合。能够被称为序列的对象,必须满足三条硬性特征:一是集合内的元素具有确定的线性排列顺序;二是每个元素可以通过整数索引进行绝对定位;三是该集合具备明确的有限长度。列表、元组和字符串无论在语法上使用方括号、圆括号还是引号声明,在 Python 解释器内部都实现了对应的序列接口协议。
在内存管理上,这三者的呈现方式稍有区别,但对外提供的逻辑视图高度一致:
- 列表(list):底层是连续的指针数组。指针指向各个独立的 Python 对象,指针数组本身允许扩容或缩减,因此属于可变序列。
- 元组(tuple):底层同样是连续的对象指针数组,但在创建完成后长度固定且指针地址不可更改,属于不可变序列。
- 字符串(str):底层是经过优化的紧凑连续字符数组,专门存储 Unicode 字符,同样属于不可变序列。
二、双向索引与切片计算:统一的数据提取规则
无论操作何种序列类型,元素定位与子区间提取都采用同一套索引与切片规范。掌握了正负索引的推导过程和步长机制,就能完全掌控数据提取。
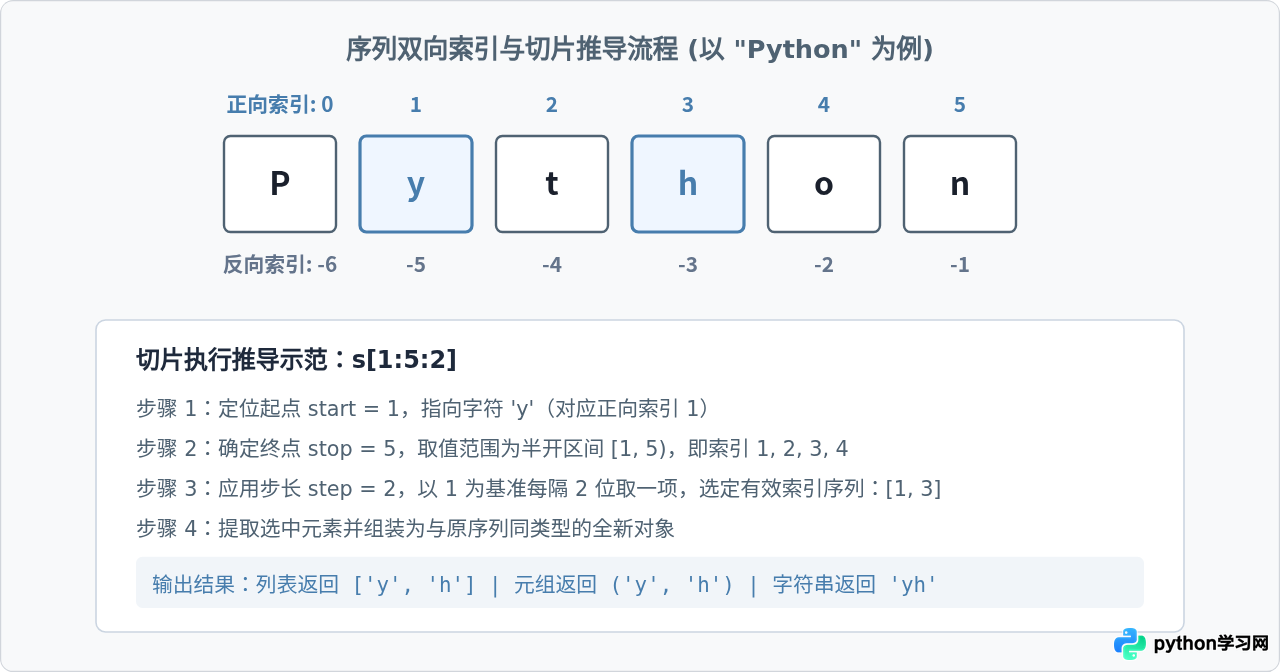
1. 正向与反向双向索引
Python 规定,长度为 n 的序列结构中:
- 正向索引:从序列首端开始,首元素下标为
0,尾元素下标为n - 1。 - 反向索引:从序列末尾向前,最后一个元素下标为
-1,首元素下标为-n。
当尝试访问超出 [-n, n - 1] 范围的下标时,列表、元组与字符串均会抛出完全一致的 IndexError: string index out of range 或 list index out of range。
2. 统一切片语法机制
切片基本语法为 sequence[start:stop:step],其关键规则如下:
- 左闭右开区间:切片范围严格包含
start所在位置,但不包含stop所在位置,即数学区间[start, stop)。 - 省略默认值:当
step > 0时,start缺省为0,stop缺省为len(seq);当step < 0时,start缺省为尾部,stop缺省延伸至首部之前。 - 容错机制:单索引越界会报错,但切片的
start与stop越界时,解释器会自动截断在序列合法边界内,不会抛出异常。
下面展示一段完整的 Python 代码,演示列表、元组和字符串在切片操作中的完全对等性:
# 统一序列切片与索引示例
# 执行环境:Python 3.8+ 交互式终端或脚本

raw_list = ['P', 'y', 't', 'h', 'o', 'n']
raw_tuple = ('P', 'y', 't', 'h', 'o', 'n')
raw_str = "Python"

# 1. 单元素索引(正向与反向)
print("列表元素:", raw_list[0], raw_list[-1])
print("元组元素:", raw_tuple[0], raw_tuple[-1])
print("字符元素:", raw_str[0], raw_str[-1])

# 2. 步长切片提取 [1:5:2]
sub_list = raw_list[1:5:2]
sub_tuple = raw_tuple[1:5:2]
sub_str = raw_str[1:5:2]

print("切片列表:", sub_list)
print("切片元组:", sub_tuple)
print("切片字符:", sub_str)

# 3. 步长为 -1 实现逆序
print("逆序列表:", raw_list[::-1])
print("逆序元组:", raw_tuple[::-1])
print("逆序字符:", raw_str[::-1])
上述代码在终端执行后,将产生如下输出:
# 示例输出:
列表元素: P n
元组元素: P n
字符元素: P n
切片列表: ['y', 'h']
切片元组: ('y', 'h')
切片字符: yh
逆序列表: ['n', 'o', 'h', 't', 'y', 'P']
逆序元组: ('n', 'o', 'h', 't', 'y', 'P')
逆序字符: nohtyP
三、通用序列运算符:拼接、重复与包含检测
Python 语言为序列类型重载了一组标准运算符。这些运算符在不同序列对象上的调用行为保持高度契合。
1. 拼接运算(+)与重复运算(*)
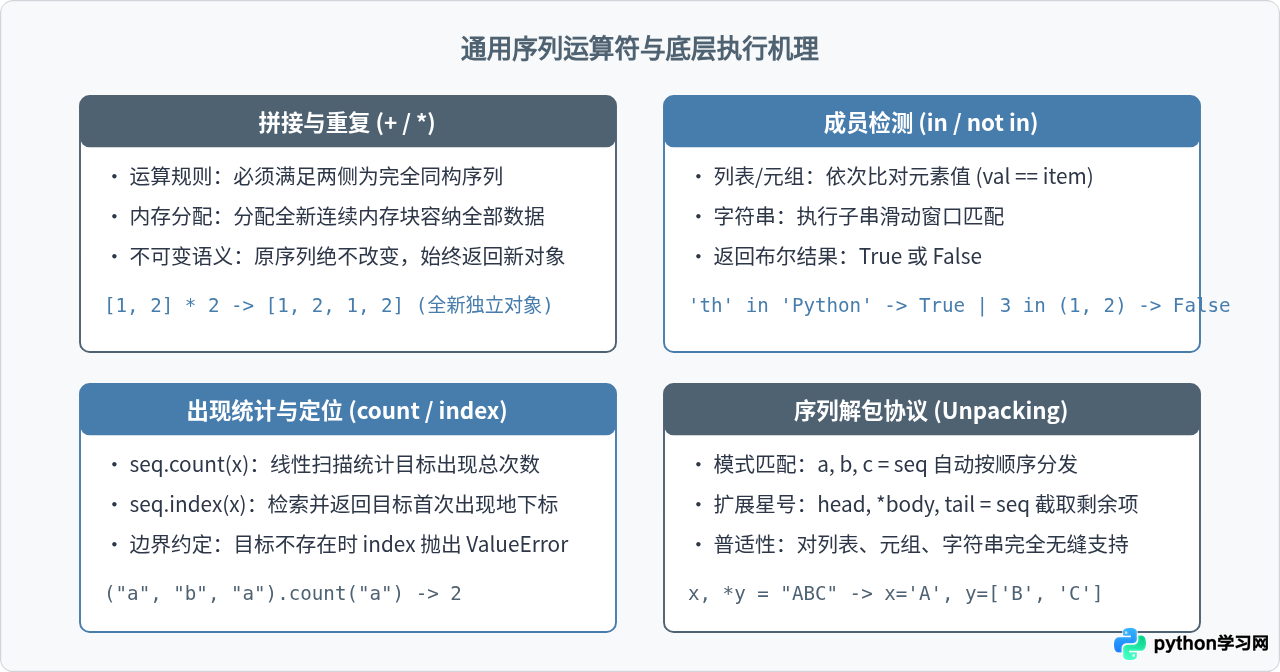
加法运算符 + 用于将两个同类型的序列串联起来,生成一个包含两侧所有元素的新序列。乘法运算符 * 用于将序列内容浅复制指定的正整数倍次,同样返回新实例。
+ 运算严禁跨类型操作。例如 [1, 2] + (3, 4) 或 "abc" + ['d'] 会直接引发 TypeError。此外,当可变对象参与 * 复制(如 [[0]] * 3)时,复制的是对象的内存引用而非深拷贝,操作其中一项会导致所有复本同步变化。
2. 成员资格检测(in 与 not in)
运算符 in 用于检查某个目标是否存在于序列之中:
- 对于列表和元组,
in执行从头到尾的线性匹配,使用==判断目标项与集合内任一元素是否等价。 - 对于字符串,
in执行子串搜索算法,判断目标串是否完整作为连续切片嵌入宿主字符串中。
四、全局内置函数与解包协议的统一协同
由于序列结构都实现了 __len__ 与 __iter__ 魔法方法,Python 内置的核心处理函数可以直接作用于任何序列类型上,而无需关心具体是列表、元组还是字符串。
1. 常用内置函数对序列的支持
len(s):直接从对象头部结构体中读取已保存的长度属性,耗时为严格的 \(O(1)\),不会发生逐项计数的耗时遍历。min(s)与max(s):利用迭代器遍历序列,基于元素的自然大小关系(比较运算符<)返回极值项。要求序列非空且元素两两之间类型可比。reversed(s):返回一个反向迭代器。对于实现了__reversed__或具备__len__与整数下标访问能力的序列均可直接生效。enumerate(s):将序列中的每个元素与从0(或指定值)开始的计数器打包成二元组。
2. 统一序列解包(Unpacking)
在 Python 变量赋值中,左侧放置逗号分隔的变量,右侧放置任意序列对象,解释器会按从左到右的位置关系依次完成解构赋值。配合 PEP 3132 引入的星号表达式(*),可以灵活捕获变长片段:
# 序列解包的通用性对比
items_list = [10, 20, 30, 40]
items_tuple = (10, 20, 30, 40)
items_str = "1234"

# 1. 严格等长解包
a, b, c, d = items_list
print(f"列表解包: a={a}, d={d}")

# 2. 星号表达式解包头部与尾部
first, *middle, last = items_tuple
print(f"元组带星解包: first={first}, middle={middle}, last={last}")

# 3. 字符串直接解包为单个字符
h, *tail = items_str
print(f"字符串解包: head='{h}', tail={tail}")
示例执行结果如下:
# 示例输出:
列表解包: a=10, d=40
元组带星解包: first=10, middle=[20, 30], last=40
字符串解包: head='1', tail=['2', '3', '4']
可以看到,无论右侧是元组还是字符串,使用 *middle 接收的剩余元素都会被统一转换为一个标准的 Python 列表。
五、共性对照与实际应用选型建议
理解了上述底层共性之后,在实际开发中面对具体业务需求,选择哪种序列结构便不再由“支持哪些操作”决定,而主要取决于“是否需要就地变动”以及“内存与安全性要求”。
| 功能维度 | 列表 (list) | 元组 (tuple) | 字符串 (str) |
|---|---|---|---|
| 可变性 (Mutability) | 可变(支持 append, pop, 切片赋值) | 不可变(创建后元素指针固定) | 不可变(只读字符文本序列) |
| 索引与切片支持 | 完全支持(并支持就地切片替换) | 完全支持(只读切片) | 完全支持(只读切片) |
| 拼接与重复 (+, *) | 支持(返回新列表) | 支持(返回新元组) | 支持(返回新字符串) |
| 成员检测 (in) | O(n) 线性元素值比对 | O(n) 线性元素值比对 | O(n) 子串匹配算法 |
| 字典键支持 (Hashable) | 不支持(不可哈希) | 支持(前提是所含元素均可哈希) | 支持(原生具备哈希缓存) |
| 内存开销与性能 | 有预留分配空间,开销略高 | 空间紧凑,创建与垃圾回收更快 | 连续定长单字节/多字节字符优化 |
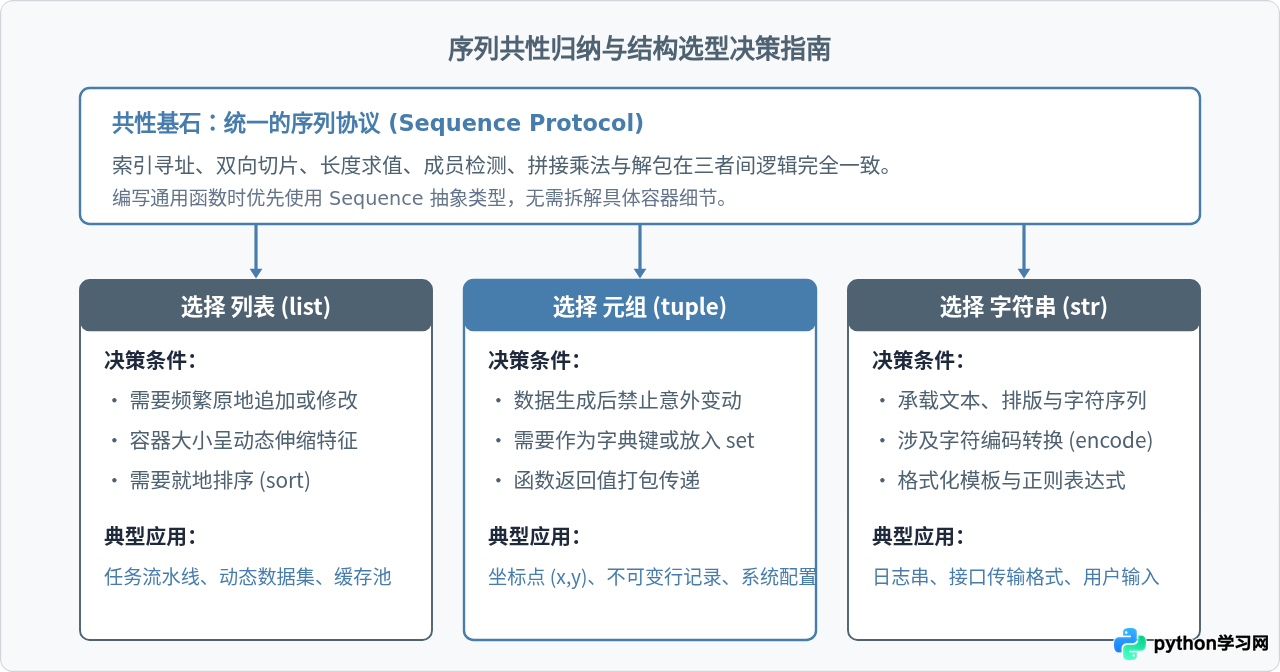
通过清晰划分“底层序列共性”与“具体容器个性”,在编写 Python 程序时不仅能减少重复的代码习惯,还能在函数参数设计中使用更为通用的迭代与切片逻辑,从而提升代码的健壮性与可复用度。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















