


为什么Python输出的JSON里中文变成了\u形式?
详细解析Python中json.dumps为何默认将中文字符转义为\uXXXX形式、背后的Unicode规范与设计初衷,并提供正确的解决方案与文件保存操作指南。
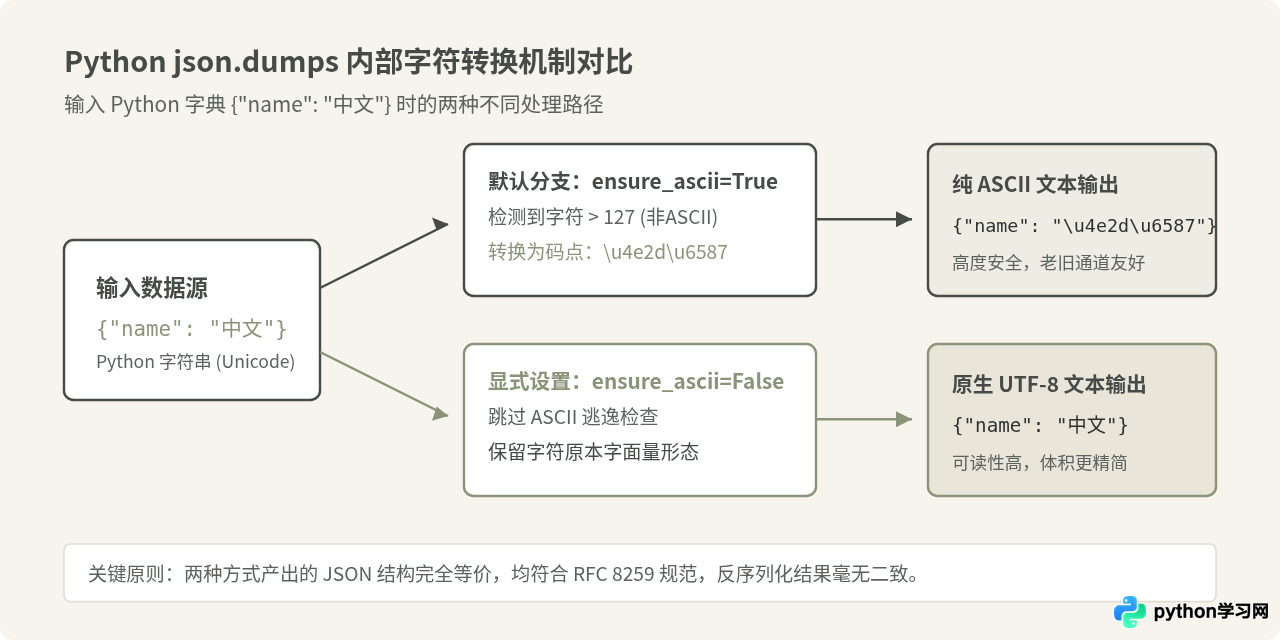
json.dumps() 序列化数据时,中文字符变成形如 \u4e2d\u6587 的字符串,是因为该函数默认启用了参数 ensure_ascii=True。该参数会将所有超出 ASCII 编码范围的字符强制转义为其 16 进制 Unicode 码点表示。解决此问题只需显式设置 ensure_ascii=False,若保存到本地文件,还需搭配 encoding="utf-8"。
一、现象与本质:\u 到底是什么?
在 Python 开发中,当我们尝试将包含中文的字典转换为 JSON 文本时,常常会观察到下面的现象:
import json

data = {"title": "Python实战", "author": "张三"}
result = json.dumps(data)

print(result)
# 输出: {"title": "Python\u5b9e\u6218", "author": "\u5f20\u4e09"}
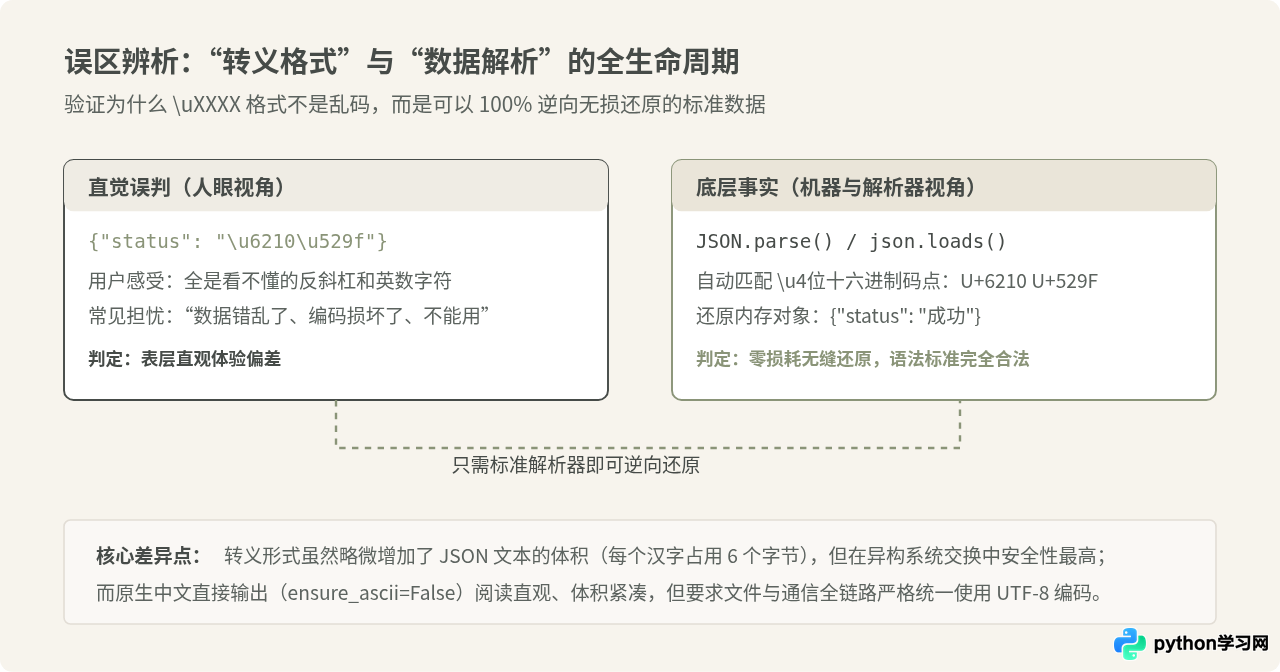
在上述输出中,“实战”变成了 \u5b9e\u6218,“张三”变成了 \u5f20\u4e09。初次遇到的开发者往往会怀疑程序出现了乱码或编码格式损坏。然而事实恰恰相反,这种带有 \u 前缀的字符串并不是乱码,而是国际标准的 Unicode 转义序列(Unicode Escape Sequence)。
具体而言,\u 后面紧跟着 4 个十六进制数,代表对应字符在 Unicode 字符集中的码点(Code Point)。例如:
- 字符 “实” 的 Unicode 十六进制码点是
5b9e,写作\u5b9e。 - 字符 “战” 的 Unicode 十六进制码点是
6218,写作\u6218。 - 字符 “张” 的 Unicode 十六进制码点是
5f20,写作\u5f20。 - 字符 “三” 的 Unicode 十六进制码点是
4e09,写作\u4e09。
根据国际标准 RFC 8259(JSON 数据交换格式规范),JSON 文本允许使用 \uXXXX 形式来表达任意 Unicode 字符。也就是说,纯 ASCII 字符集的传输通道也可以安全无损地传递包括中文、日文、阿拉伯文和 Emoji 在内的全部字符。
二、深层原因:Python 为何坚持默认 ensure_ascii=True?
了解了 \uXXXX 是 Unicode 转义序列之后,很多开发者可能会好奇:既然 UTF-8 已经普及全球,为什么 Python 标准库至今仍将 ensure_ascii=True 设为默认行为?这背后有三项根本考量:
1. 历史网络通信的鲁棒性(7 位 ASCII 安全性)
在早期的网络协议(如较老的邮件系统协议 SMTP、某些旧版代理服务器或古老的 RPC 接口)中,只保证传输 7 位 ASCII 字符。如果直接向这些通道发送多字节 UTF-8 编码的汉字,极易遭遇字符截断、高位清洗导致数据彻底乱码甚至崩溃。转义为纯 ASCII 字符后,可以安全跨越任何对编码支持不佳的网络节点。
2. 避免终端与环境解码冲突
不同的操作系统和控制台默认编码各异。例如在 Windows 系统的默认控制台(代码页通常为 CP936/GBK)下,打印包含原始非 ASCII 字符的文本很容易触发 UnicodeEncodeError。默认输出为纯 ASCII 序列,能够确保无论在任何操作系统、任何控制台环境下,json.dumps() 都能 100% 成功生成字符串而不引发崩溃。
3. 严格遵循向后兼容性保证
Python 核心开发团队对于标准库的稳定性要求极高。json 模块自 Python 2.6 引入以来,其默认行为一直保持一致。贸然改变标准库函数的默认参数,可能导致依赖原有行为的海量老旧系统产生非预期偏差。
三、常见误区与事实辨析
关于 Python 中文 JSON 处理,社区中流传着一些似是而非的说法,需要根据具体场景予以辨析:
合理成分:如果该 JSON 是供人眼直接查看的本地配置文件或调试日志,\u 形式确实极大地损害了可读性,需要优化。
需要修正:但如果该 JSON 是机器对机器(M2M)通信,它绝不是乱码,数据也没有任何丢失或损坏。下游无论是 Java、JavaScript、Go 还是 C++ 的正规 JSON 解析器,反序列化后都会自动还原成原本的中文字符串。
合理成分:ensure_ascii=False 确实能让 Python 在序列化时不转义中文。
需要修正:如果在写入文件时未显式指定 encoding="utf-8"(例如直接使用 open("data.json", "w")),Python 将使用系统的默认编码(Windows 下通常是 GBK)。此时,不仅可能在遇到生僻字时抛出 UnicodeEncodeError,保存下来的文件在其他 UTF-8 平台打开时还会真正变成乱码!
四、实战操作:如何让输出保留原样中文?
掌握了原理后,在实际编码中让 JSON 正常显示中文字符非常直截了当。针对不同的使用场景,推荐按照以下规范执行:
1. 内存中序列化为原生中文 JSON 字符串
在调用 json.dumps() 时,直接传入关键字参数 ensure_ascii=False 即可。若希望输出更易阅读,可同时加上 indent=2:
import json

user_info = {
    "name": "李雷",
    "role": "系统管理员",
    "hobbies": ["编程", "阅读", "骑行"]
}

# 显式关闭 ASCII 转义,并指定缩进
pretty_json = json.dumps(user_info, ensure_ascii=False, indent=2)
print(pretty_json)
执行输出(示例输出):
{
  "name": "李雷",
  "role": "系统管理员",
  "hobbies": [
    "编程",
    "阅读",
    "骑行"
  ]
}
2. 持久化保存至本地 JSON 文件(黄金法则)
若要将数据写入本地文件,必须同时完成两项配置:第一,在 json.dump() 中指定 ensure_ascii=False;第二,在 open() 中显式传入 encoding="utf-8":
import json

config = {
    "project": "数据监控中心",
    "version": "2.1.0",
    "maintainer": "开发组",
    "status": "运行中"
}

# 规范操作:指定编码为 utf-8,并关闭 ensure_ascii
with open("config.json", mode="w", encoding="utf-8") as f:
    json.dump(config, f, ensure_ascii=False, indent=2)

print("配置文件已成功保存为 UTF-8 编码的中文 JSON 文件。")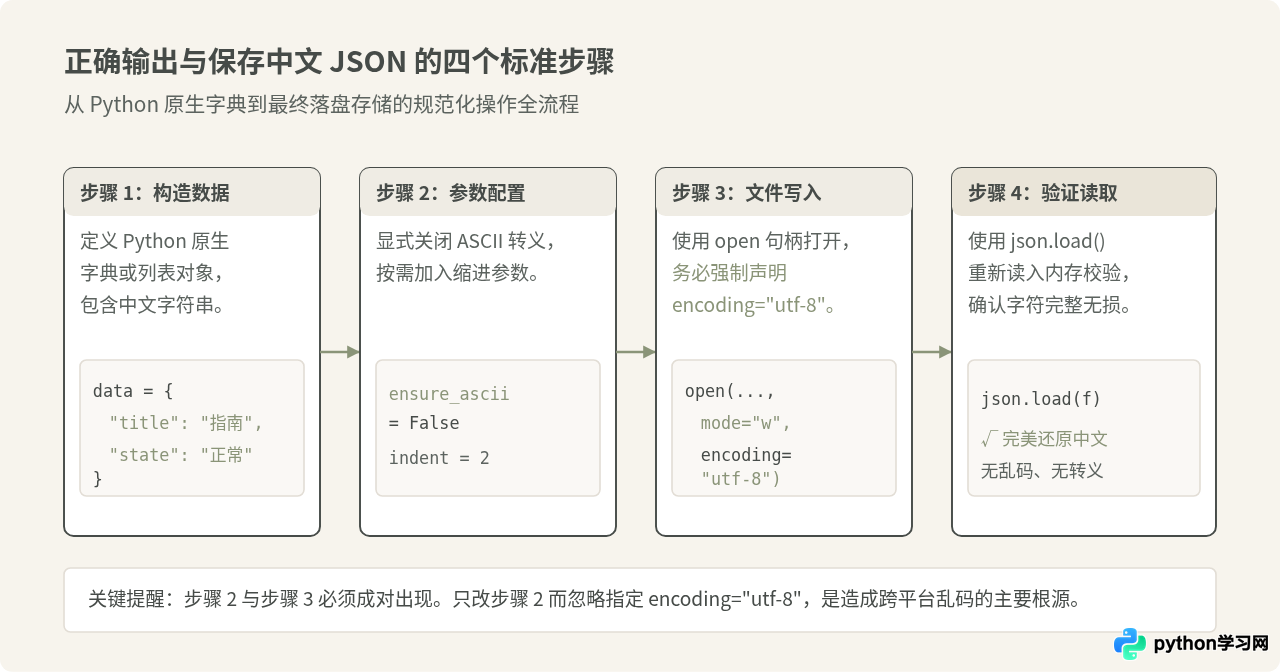
五、场景决策:何时保留转义,何时关闭转义?
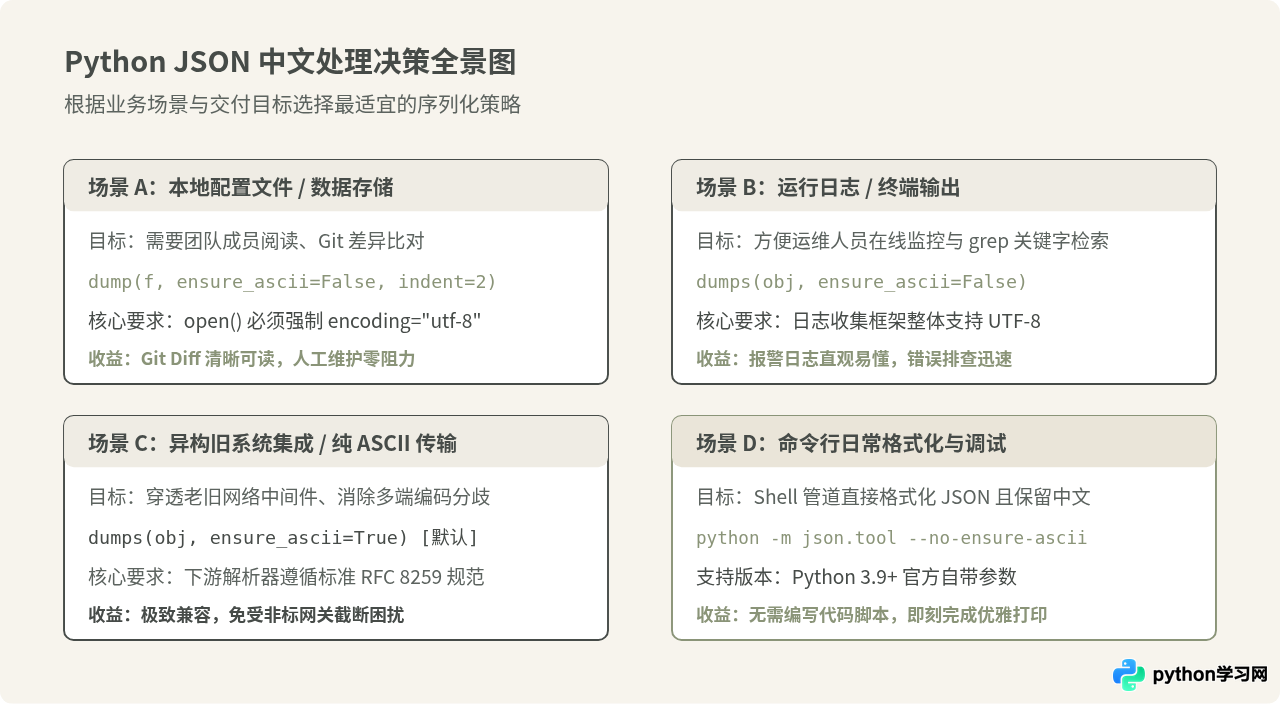
在实际工程项目中,并非所有场合都必须关闭转义。我们需要根据系统边界和目标受众做出清晰的权衡选择:
| 应用场景 | 推荐设置 | 选用理由 |
|---|---|---|
| 本地配置文件 / 人工维护数据 | ensure_ascii=False + utf-8 |
以人为中心,配置项需要开发人员或运维人员直接查看、审阅与修改,中文字面量具备最高可读性。 |
| 程序运行日志 / 本地排查输出 | ensure_ascii=False |
日志排查时若堆满 \uXXXX 会严重影响阅读效率与关键词检索定位。 |
| 旧版外部系统集成 / 未知网络接口 | ensure_ascii=True(默认) |
下游接收端环境未知或存在遗留代理网关时,转义输出能规避所有传输层编码不一致引起的隐蔽故障。 |
| 现代微服务 HTTP API 接口 | ensure_ascii=False |
主流现代框架(如 FastAPI、Flask)通常在返回 Content-Type: application/json; charset=utf-8 时直接输出原生 UTF-8,既节省带宽流量,又方便抓包分析。 |
六、实用拓展:命令行快速美化 JSON 且不转义中文
在 Linux 或 macOS 终端中,许多开发者习惯使用内置的 python -m json.tool 来美化 JSON 文本。然而在早期 Python 版本中,该工具默认也是转义中文的。
自 Python 3.9 开始,官方为 json.tool 新增了 --no-ensure-ascii 选项。可以直接在命令行中实现中文字符的无损美化展示:
# 将包含转义的 JSON 文件以清晰的中文格式化展示在终端
python -m json.tool --no-ensure-ascii data.json

# 结合 curl 管道请求 API 并优雅呈现中文响应
curl -s https://api.example.com/info | python -m json.tool --no-ensure-ascii
七、总结与自查清单
回顾本文的核心要点,可以归纳为三句话自查清单:
- 本质认识:
\uXXXX是标准 Unicode 转义序列,非乱码、无数据损伤,是老旧环境高兼容性的产物。 - 内存转换:若需在代码输出中直观看到中文,调用
json.dumps(obj, ensure_ascii=False)。 - 文件存储:写入文件时,务必将
ensure_ascii=False与open(..., encoding="utf-8")绑定使用,确保跨平台绝对安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















