


Python列表、字典与元组的基础语法及常用操作
全面讲解Python三大核心内置数据结构:列表(list)、字典(dict)与元组(tuple)的基础语法、内存模型、高频操作方法、性能特征以及实际选型决策。
一、核心容器全景与内存特征
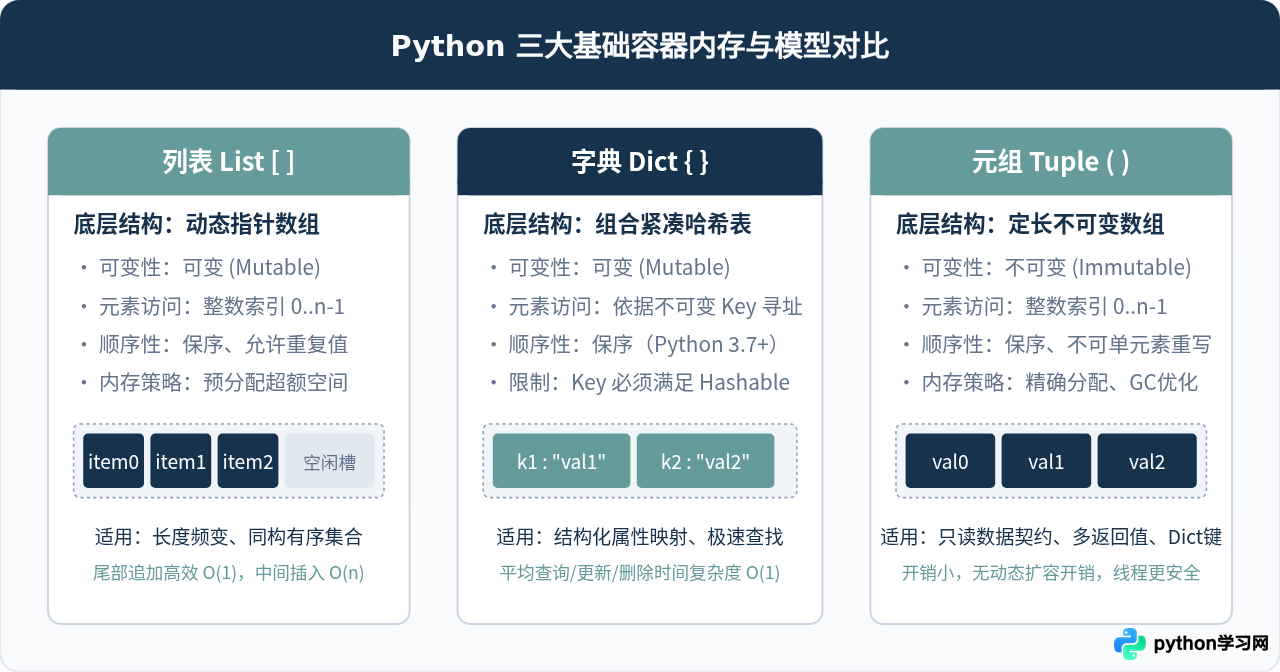
在深入具体操作之前,先从全局理解这三类容器的本质差异。Python 的数据容器在底层由不同的 C 数据结构支撑,其数据组织方式直接决定了读写效率与使用限制:
- 列表(List):动态连续指针数组,元素按加入顺序排列,支持任意类型且允许重复,属于典型的可变序列。
- 字典(Dict):基于哈希表(Hash Table)实现的键值对集合,键(Key)必须是可哈希(不可变)的对象且唯一,属于可变映射。
- 元组(Tuple):固定长度的不可变指针序列,一旦定义其元素引用不可变更,属于不可变序列。
二、列表(List)的基础语法与常用操作
列表是 Python 最通用的线性数据结构,通过方括号 [] 或内置构造函数 list() 定义。
1. 定义与访问
# 创建列表
fruits = ["apple", "banana", "orange"]
mixed = [1, "hello", 3.14, True]

# 正向索引与反向索引
print(fruits[0])   # 输出: apple(首个元素)
print(fruits[-1])  # 输出: orange(末尾元素)

# 切片操作:[start:stop:step](包含 start,不含 stop)
numbers = [0, 1, 2, 3, 4, 5, 6, 7]
print(numbers[2:5])    # 示例输出: [2, 3, 4]
print(numbers[::2])    # 示例输出: [0, 2, 4, 6](步长为2)
print(numbers[::-1])   # 示例输出: [7, 6, 5, 4, 3, 2, 1, 0](反转列表)
2. 增、删、改操作
列表的操作方法非常丰富,但不同方法在时间复杂度上有较大差异:
- 追加元素:
list.append(x)将单个元素添加至末尾,复杂度为 O(1)。 - 合并序列:
list.extend(iterable)将另一个可迭代对象的全部元素追加至末尾。注意与append区分,append([1, 2])会将整个列表作为单个嵌套元素插入。 - 指定位置插入:
list.insert(index, x)将元素插入指定索引,其后所有元素后移,复杂度为 O(n)。 - 弹出与删除:
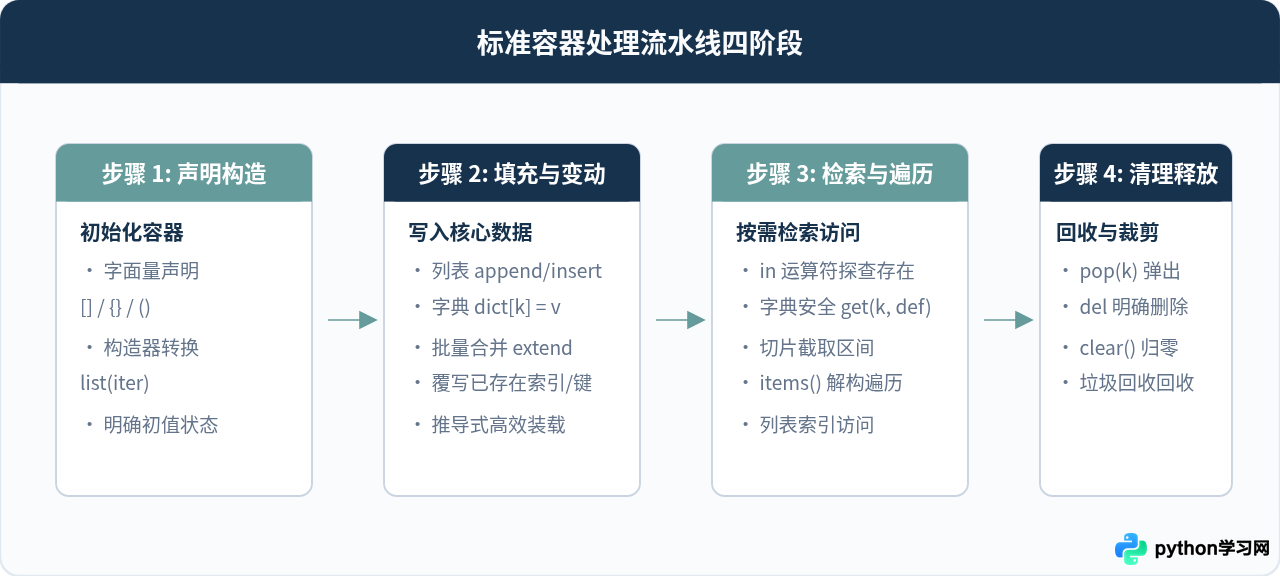
list.pop([index]):移除并返回指定索引处的元素,默认索引为-1(末尾元素,O(1));若弹出首位元素pop(0),复杂度为 O(n)。list.remove(value):查找并移除第一个匹配的值。若值不存在会抛出ValueError。del list[index]:Python 关键字语句,可直接按索引或切片批量释放元素。
tasks = ["write_doc", "code_review"]

# 1. 增
tasks.append("deploy")              # ["write_doc", "code_review", "deploy"]
tasks.insert(1, "run_tests")        # ["write_doc", "run_tests", "code_review", "deploy"]
tasks.extend(["monitor", "report"]) # 追加两个任务

# 2. 改
tasks[0] = "write_api_spec"

# 3. 删
finished_task = tasks.pop()         # 弹出末尾 "report"
tasks.remove("run_tests")           # 删除匹配到的首个 "run_tests"
del tasks[0:2]                      # 批量删除切片范围内的元素
3. 列表推导式(List Comprehension)
列表推导式提供了一种简洁、地道的语法用于对序列进行过滤与变换。它的底层执行在字节码层面经过专门优化,运行速度通常显著快于手动构建的 for 循环追加:
# 传统循环方式
squares = []
for x in range(10):
    if x % 2 == 0:
        squares.append(x ** 2)

# 等价但更高效的列表推导式
squares = [x ** 2 for x in range(10) if x % 2 == 0]
# 示例输出: [0, 4, 16, 36, 64]
浅拷贝与深拷贝陷阱:使用 list.copy() 或切片 nums[:] 创建的是浅拷贝(Shallow Copy)。如果列表中嵌套了子列表或字典,修改拷贝后的嵌套对象仍会同步影响原列表。需要完全独立的新副本时,应使用 copy.deepcopy()。
三、字典(Dict)的基础语法与常用操作
字典是 Python 最核心的映射类型,使用花括号 {"key": value} 定义。其底层为高度优化的紧凑哈希表,能够在无论数据量多大的情况下,均保持常数级别 O(1) 的查找与插入耗时。
1. 定义与键的哈希约束
字典的键必须是可哈希(Hashable)的对象。在 Python 中,整数、浮点数、字符串、元组等不可变类型均实现了 __hash__() 协议,可以作为键;而列表、字典或集合等可变容器不能作为键,否则会触发 TypeError: unhashable type: 'list'。
# 合法的键类型
valid_dict = {
    1001: "admin_id",
    "name": "Alex",
    (39.9, 116.4): "Beijing_Coordinates"  # 元组可作为键
}

# 非法的键定义(会抛出 TypeError)
# invalid_dict = {[1, 2]: "error"}
2. 查找与安全提取:直接索引 vs get()
通过键访问字典有两种途径,其适用场景截然不同:
dict[key]:直接取值。如果键不存在,将直接抛出KeyError异常导致程序中断。dict.get(key, default=None):安全取值。当键不存在时,不会报错,而是平稳返回指定的默认值。dict.setdefault(key, default):如果键存在则返回其值;若不存在,则以该默认值将键值对写入字典并返回该值。
user = {"username": "zhangsan", "role": "developer"}

# 方式 1:直接访问(需确保键必存在)
print(user["username"])  # 输出: zhangsan

# 方式 2:防御性读取
department = user.get("department", "Default-Engineering")
print(department)        # 输出: Default-Engineering

# 方式 3:按需预置默认结构
user.setdefault("login_count", 0)
user["login_count"] += 1
print(user["login_count"]) # 输出: 1
3. 更新、删除与多维度遍历
config = {"host": "localhost", "port": 8080}

# 批量更新或合并键值对
config.update({"port": 9000, "debug": True})

# 安全移除键值并获取其对应的值
current_port = config.pop("port")      # 返回 9000,且 config 中不再包含 'port'
missing_val = config.pop("timeout", 30) # 键不存在时返回默认值 30,不报错

# 遍历字典的三种视角
for key in config.keys():              # 仅遍历键
    pass

for value in config.values():          # 仅遍历值
    pass

for k, v in config.items():            # 遍历键值对(最常用)
    print(f"Key: {k} -> Value: {v}")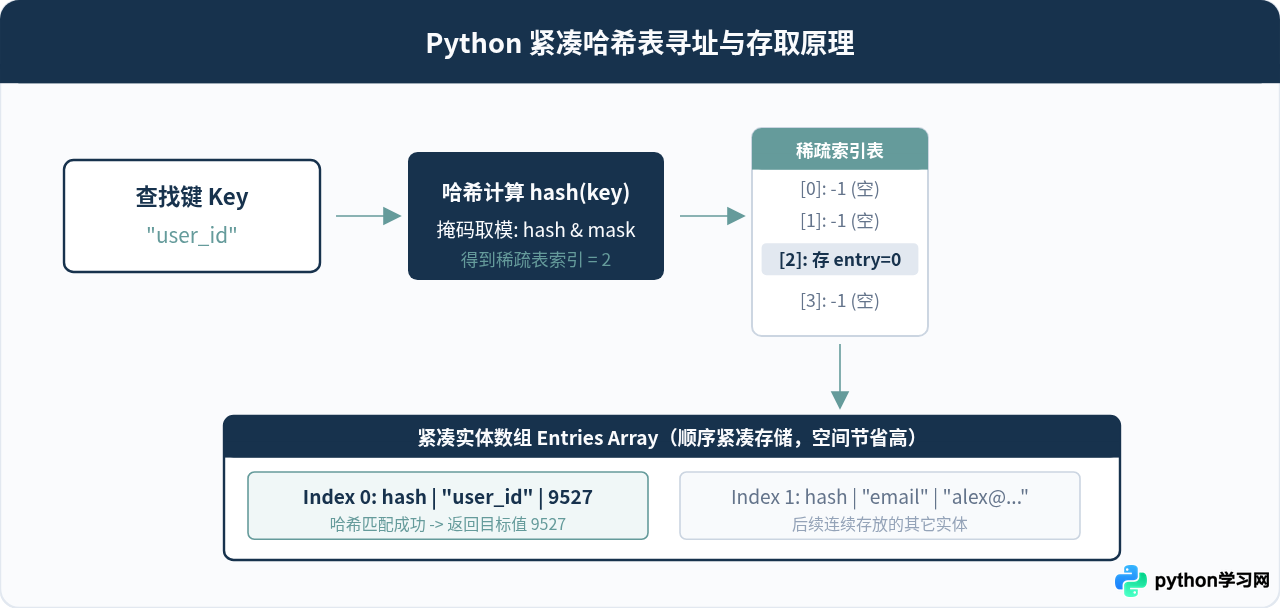
四、元组(Tuple)的基础语法与不可变意义
元组使用圆括号 () 定义,元素以逗号分隔。它的核心特性是不可变性(Immutability)。一旦构建,元组包含的引用对象、顺序和长度即被彻底固化,不可进行追加、删除或重新指向。
1. 语法陷阱:单元素元组的逗号
初学者极易出现的书写错误是遗漏单元素元组的逗号。在 Python 语法中,单独的圆括号会被解析为算术运算符的优先级括号,而非元组字面量:
# 错误示范:这不是元组,而是普通的整数 42
fake_tuple = (42)
print(type(fake_tuple))  # 示例输出: <class 'int'>

# 正确写法:单元素元组必须带有尾随逗号
real_tuple = (42,)
print(type(real_tuple))  # 示例输出: <class 'tuple'>
2. 解包语法(Unpacking)
元组支持极其优雅的变量解包语法,包括星号 * 收集剩余元素,常用于解析固定结构数据或多值返回:
# 1. 基础解包
point = (10, 20, 30)
x, y, z = point
print(f"x={x}, y={y}, z={z}")

# 2. 星号解包(收集多余项为列表)
record = ("Alex", "Developer", 28, "Python", "Docker", "Linux")
name, job, age, *skills = record
print(name)    # 输出: Alex
print(skills)  # 输出: ['Python', 'Docker', 'Linux']

# 3. 交换变量值(基于元组解包的 Python 经典技巧)
a, b = 1, 2
a, b = b, a    # 等号右侧隐式构建 (b, a) 元组,随后解包赋给 a, b
3. 为什么需要不可变的元组?
既然列表如此灵活,为什么语言设计还要保留元组?其原因涵盖工程严谨性与运行效率两方面:
- 防御性设计(数据契约):向函数传递不可变元组可以从语言层面保障数据不会被下游模块意外修改,消除隐蔽的副作用。
- 可用作字典的键:因为元组不可变且具有稳定的哈希值,可以作为字典键或存入集合(前提是元组内部所有元素也均为不可变类型)。
- 内存与垃圾回收优化:元组没有动态扩容的冗余指针,空间占用更小;Python 对小尺寸元组内部实现了对象缓存重用池,创建和销毁的开销远低于列表。
元组的“不可变”指的是其内部持有的对象引用地址不可变。如果元组中包含可变对象(如列表),虽然该列表的引用不可变,但列表内部的内容依然可以被更改:
tpl = ("status_ok", [1, 2, 3])
# tpl[1] = [4, 5]     # 抛出 TypeError: 'tuple' object does not support item assignment
tpl[1].append(4)       # 完全合法!tpl 变为 ('status_ok', [1, 2, 3, 4])
由于其内部哈希值依赖元素内容,包含可变对象的元组不能作为字典的键。
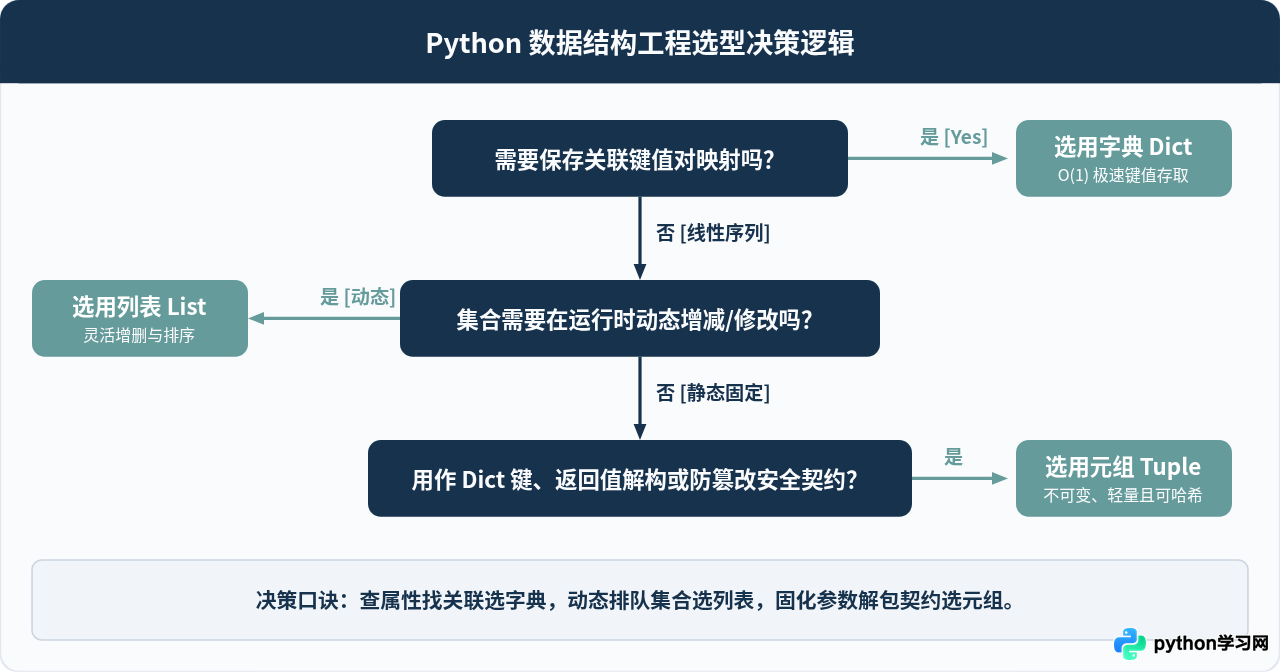
五、三者的对比总结与选型指南
在实际项目开发中,选用哪种容器取决于数据的业务语义、读写频次与一致性要求。下表汇总了核心特性维度的直接对比:
| 特性维度 | 列表 (List) | 字典 (Dict) | 元组 (Tuple) |
|---|---|---|---|
| 语法标志 | [1, 2, 3] |
{"k": "v"} |
(1, 2, 3) |
| 可变性 | 可变 (Mutable) | 可变 (Mutable) | 不可变 (Immutable) |
| 访问方式 | 整数索引 lst[i] |
键值检索 d[k] |
整数索引 tpl[i] |
| 元素重复性 | 允许元素重复 | 键唯一,值允许重复 | 允许元素重复 |
| 主要操作复杂度 | 尾部追加 O(1),按值查找 O(n) | 键检索/插入/删除均 O(1) | 只读访问 O(1),不支持变动 |
| 能否作 Dict 键 | 否 | 否 | 是(需内部所有元素均可哈希) |
| 典型应用场景 | 动态变动的有序集合、任务队列 | 结构化记录、实体属性、缓存映射 | 函数多返回值、数据记录契约、字典复合键 |
六、容器间的相互转换技巧
在真实业务流中,三种容器经常需要根据阶段不同发生形态转换:
# 1. 列表与元组互转
lst = [1, 2, 3]
tpl = tuple(lst)       # 转换为不可变元组
back_to_lst = list(tpl) # 转回可变列表

# 2. 键值对序列与字典互转
pairs = [("id", 101), ("name", "service")]
d = dict(pairs)        # 示例输出: {'id': 101, 'name': 'service'}

# 3. 字典转元组列表(常用在排序场景)
scores = {"Alice": 95, "Bob": 88, "Charlie": 92}
# 按分数降序排列字典项目
sorted_items = sorted(scores.items(), key=lambda x: x[1], reverse=True)
print(sorted_items)    # 示例输出: [('Alice', 95), ('Charlie', 92), ('Bob', 88)]
理解列表、字典与元组不仅是掌握 Python 基础语法的必经之路,更是编写高效、健壮 Python 程序的前提。熟练结合 get()、列表推导式、元组解包等惯用写法,能使代码逻辑更紧凑清晰;在合适的数据边界选用不可变的元组或可快速检索的字典,更能直接提升程序的性能与设计质量。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















