


python必背源代码GIL多线程影响演示代码
提供完整可运行的Python多线程GIL影响基准测试代码,定量对比单线程与多线程在CPU密集型与I/O密集型任务下的耗时表现,深入解析GIL工作机制及绕过方案。
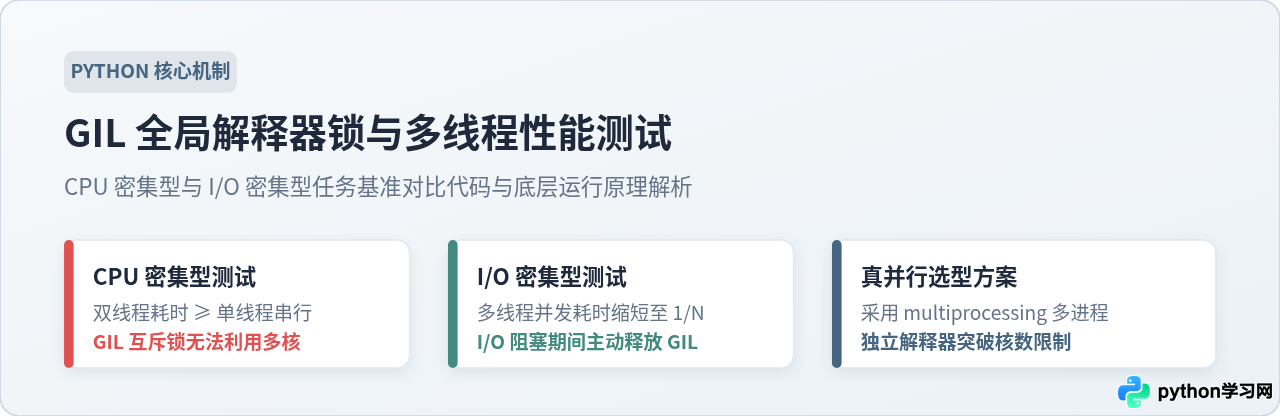
一、GIL 对多线程的底层约束与原理架构
CPython 是绝大多数开发者日常使用的官方 Python 实现。为了保证内部 C 语言级别内存管理(特别是引用计数机制)的线程安全,CPython 引入了 GIL(Global Interpreter Lock,全局解释器锁)。GIL 本质上是一个互斥锁(Mutex)。
尽管 Python 的 threading 模块创建的是真实的操作系统原生内核线程(POSIX Threads 或 Windows 线程),但在执行 Python 字节码时,任何线程都必须首先争夺并持有 GIL。这就导致了在任意单核或多核机器上,同一进程空间内在任意瞬间只能有一个线程在 CPU 上执行 Python 字节码。
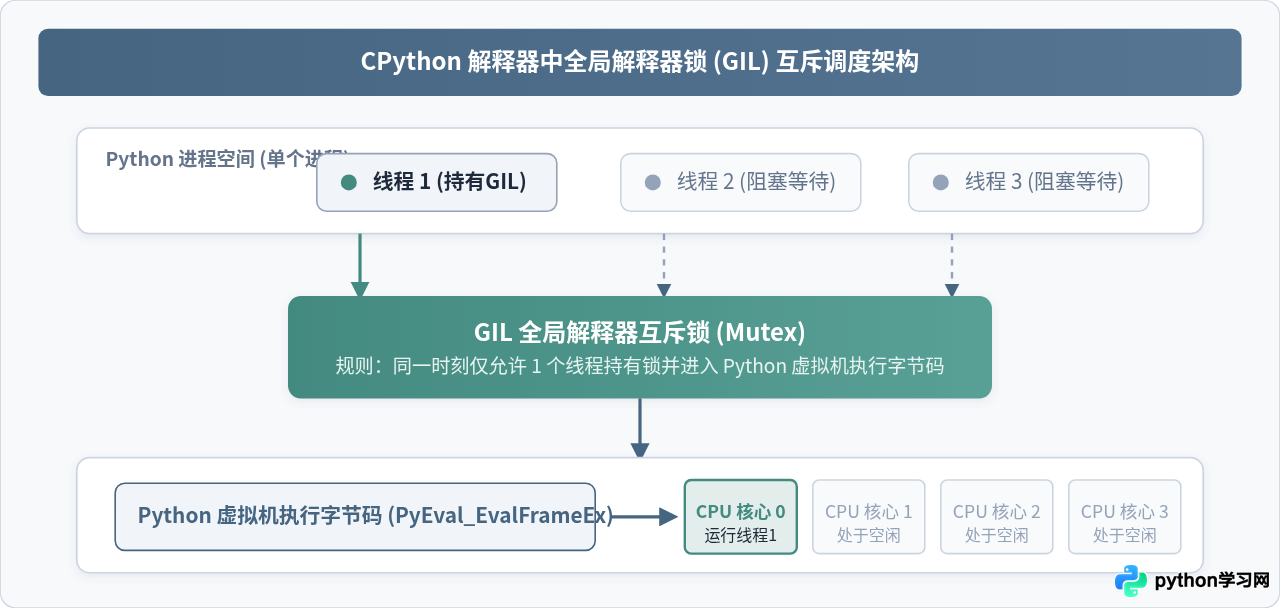
如图 1 所示,即使操作系统调度器将两个线程分配给不同的 CPU 物理核心,由于 GIL 的互斥保护,未拿到锁的线程依然处于阻塞等待状态。只有当前线程发生以下两种情况之一时,才会交出 GIL:
- 时间片耗尽:在 Python 3 中,默认每连续执行一段固定时间(可通过
sys.getswitchinterval()查询,默认为 5 毫秒),解释器会强制触发上下文切换释放锁。 - 触发系统级 I/O 阻塞:当线程执行网络请求、文件读写或
time.sleep()等系统调用时,解释器内部会自动执行Py_BEGIN_ALLOW_THREADS宏主动释放 GIL,待 I/O 数据准备就绪后再重新争锁。
二、基准测试设计与操作验证步骤
要客观、准确地观察 GIL 的影响,必须排除外部网络波动和复杂业务逻辑的干扰。评测标准包含四个规范步骤:
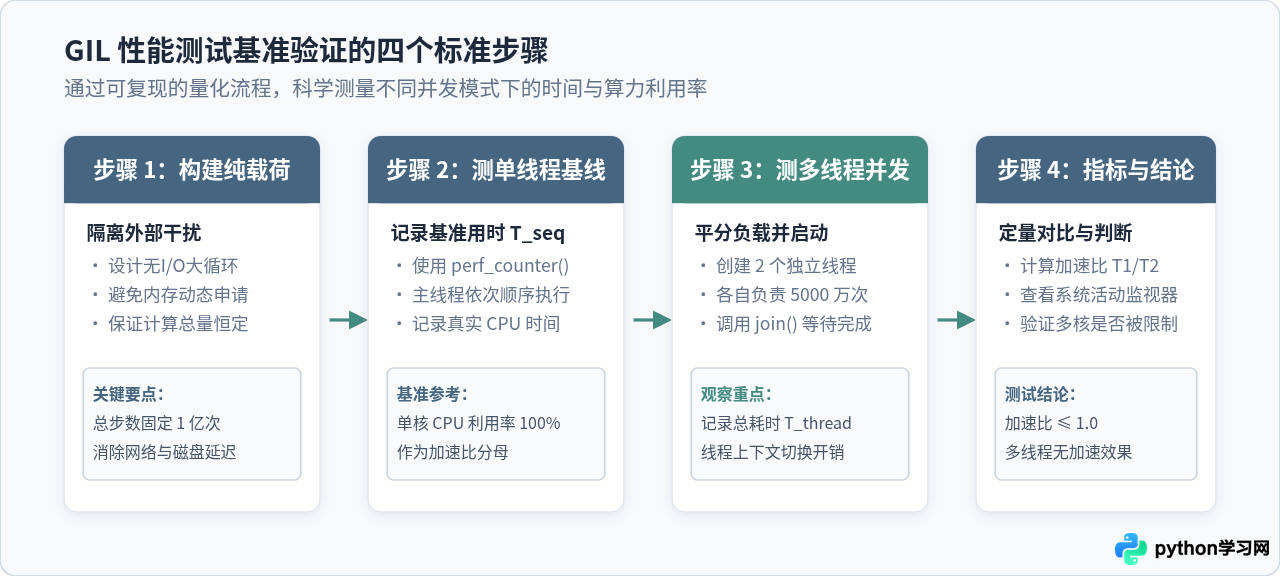
- 构建纯净计算载荷:采用大数值的整型递减循环,确保全程只有 CPU 算术运算,无任何内存重分配与 I/O 阻塞。
- 获取单线程串行基准耗时:在主线程内连续顺序执行 2 次计算,记录总用时 \(T_{seq}\) 作为加速比的分母。
- 执行双线程并发测量:将总计算量严格均分为两份,分别分配给 2 个并发线程并行执行,记录用时 \(T_{thread}\)。
- 计算加速比与判定:根据公式 \( ext{Speedup} = T_{seq} / T_{thread}\) 评估性能收益。若加速比接近 1 或小于 1,即确证 GIL 的串行约束。
三、CPU 密集型任务:多线程演示代码与实测
以下为必背的 CPU 密集型基准测试脚本。代码将 1 亿次累减计算拆分为单线程串行与双线程并发进行严格对照:
# -*- coding: utf-8 -*-
"""
Python 必背源代码:GIL 对 CPU 密集型任务的影响测试
运行环境:Python 3.8+ (CPython)
"""
import time
import threading

# 单个任务的运算量:5000 万次递减计算
COUNT = 50_000_000

def cpu_bound_task(n: int) -> None:
    """纯 CPU 密集型任务,无任何 I/O 操作"""
    while n > 0:
        n -= 1

def run_single_thread() -> float:
    """单线程串行执行 2 次任务(总计算量:1 亿次)"""
    start = time.perf_counter()
    cpu_bound_task(COUNT)
    cpu_bound_task(COUNT)
    duration = time.perf_counter() - start
    return duration

def run_multi_thread() -> float:
    """双线程并发执行 2 次任务(每个线程各计算 5000 万次,总计算量同样为 1 亿次)"""
    start = time.perf_counter()
    t1 = threading.Thread(target=cpu_bound_task, args=(COUNT,))
    t2 = threading.Thread(target=cpu_bound_task, args=(COUNT,))

    t1.start()
    t2.start()

    # 等待两个子线程均计算完成
    t1.join()
    t2.join()
    duration = time.perf_counter() - start
    return duration

if __name__ == "__main__":
    print("=" * 50)
    print("开始 CPU 密集型任务基准测试 (总计算量: 100,000,000 次)")
    print("=" * 50)

    # 1. 测量单线程串行耗时
    t_single = run_single_thread()
    print(f"[1] 单线程串行执行耗时: {t_single:.3f} 秒")

    # 2. 测量双线程并发耗时
    t_multi = run_multi_thread()
    print(f"[2] 双线程并发执行耗时: {t_multi:.3f} 秒")

    # 3. 计算加速比
    speedup = t_single / t_multi
    print(f"--> 加速比 (串行耗时 / 并发耗时): {speedup:.2f}x")

    if speedup < 1.05:
        print("结论证实: 多线程并发没有带来加速,由于 GIL 互斥与线程切换开销,运行时间甚至略有增加。")
测试结果示例与数据分析
==================================================
开始 CPU 密集型任务基准测试 (总计算量: 100,000,000 次)
==================================================
[1] 单线程串行执行耗时: 3.218 秒
[2] 双线程并发执行耗时: 3.364 秒
--> 加速比 (串行耗时 / 并发耗时): 0.96x
结论证实: 多线程并发没有带来加速,由于 GIL 互斥与线程切换开销,运行时间甚至略有增加。四、I/O 密集型任务:多线程演示代码与实测
当任务类型切换为 I/O 密集型(如网络请求、数据库查询、磁盘读写或休眠等待)时,GIL 的表现截然不同。以下代码使用 time.sleep(1.0) 模拟耗时 1 秒的外部阻塞调用:
# -*- coding: utf-8 -*-
"""
Python 必背源代码:GIL 对 I/O 密集型任务的影响测试
模拟 4 个阻塞型 I/O 请求
"""
import time
import threading

# 模拟单次网络请求的阻塞耗时(秒)
IO_WAIT_SECONDS = 1.0
TASK_TOTAL = 4

def io_bound_task(task_id: int) -> None:
    """模拟 I/O 阻塞:底层的系统调用会自动释放 GIL"""
    time.sleep(IO_WAIT_SECONDS)

def run_single_thread_io() -> float:
    """单线程依次串行执行 4 次 I/O 任务"""
    start = time.perf_counter()
    for i in range(TASK_TOTAL):
        io_bound_task(i)
    return time.perf_counter() - start

def run_multi_thread_io() -> float:
    """创建 4 个子线程并发执行 4 次 I/O 任务"""
    start = time.perf_counter()
    threads = []
    for i in range(TASK_TOTAL):
        t = threading.Thread(target=io_bound_task, args=(i,))
        threads.append(t)
        t.start()

    for t in threads:
        t.join()
    return time.perf_counter() - start

if __name__ == "__main__":
    print("=" * 50)
    print("开始 I/O 密集型任务基准测试 (4 次 1.0 秒阻塞等待)")
    print("=" * 50)

    t_single_io = run_single_thread_io()
    print(f"[1] 单线程串行 I/O 耗时: {t_single_io:.3f} 秒")

    t_multi_io = run_multi_thread_io()
    print(f"[2] 4线程并发 I/O 耗时: {t_multi_io:.3f} 秒")

    speedup_io = t_single_io / t_multi_io
    print(f"--> 加速比: {speedup_io:.2f}x")
    print(f"结论证实: I/O 等待期间线程交出 GIL,4 个线程并行等待,总耗时接近单次请求时长。")
测试结果示例
==================================================
开始 I/O 密集型任务基准测试 (4 次 1.0 秒阻塞等待)
==================================================
[1] 单线程串行 I/O 耗时: 4.012 秒
[2] 4线程并发 I/O 耗时: 1.018 秒
--> 加速比: 3.94x
结论证实: I/O 等待期间线程交出 GIL,4 个线程并行等待,总耗时接近单次请求时长。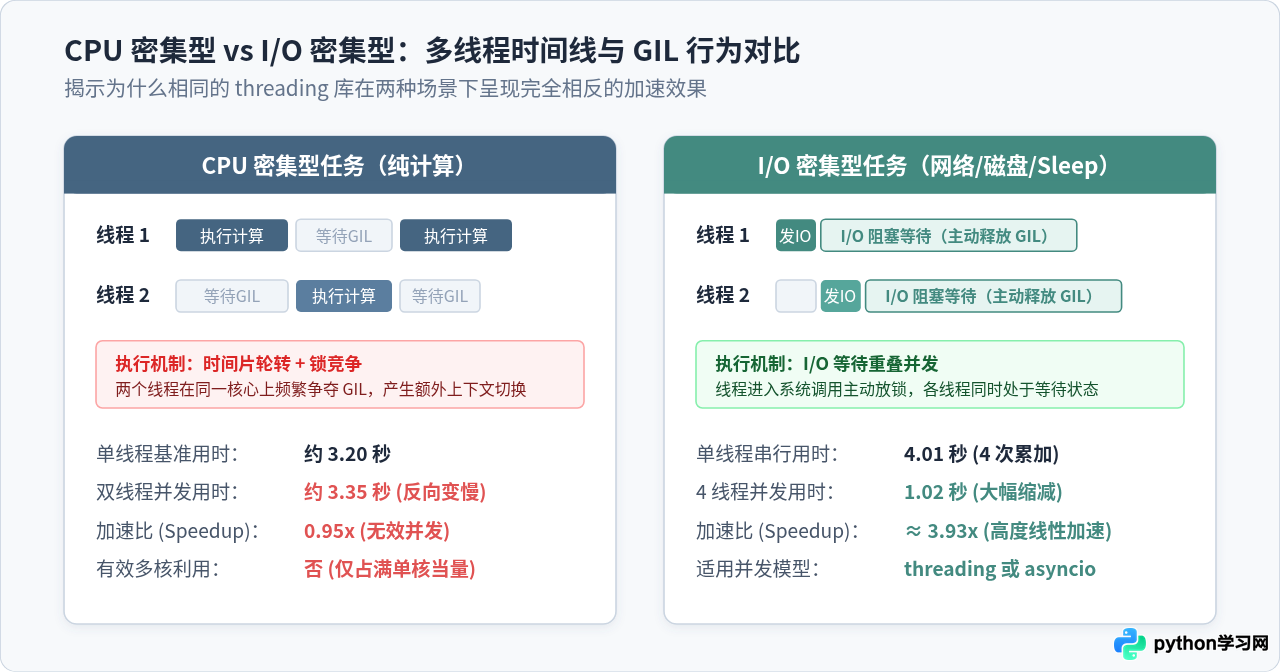
| 测试维度 | CPU 密集型(纯算术/图像处理) | I/O 密集型(网络爬虫/接口读写) |
|---|---|---|
| GIL 状态 | 线程争抢持有,直到强制时间片耗尽 | 进入底层系统调用时立即主动释放 GIL |
| 多线程耗时表现 | 不减反增(受制于单核算力) | 大幅缩减(趋近于 1/N 线性加速) |
| 多核 CPU 利用率 | 仅能吃满单核当量(约 100%) | CPU 消耗极低,主要处于事件等待 |
| 推荐处理方式 | multiprocessing 独立多进程 |
threading 或 asyncio |
五、CPU 密集型任务的真并行解决方案:多进程
如果需要在 Python 中充分释放多核 CPU 算力,最成熟、直接的解决方案是使用标准库中的 multiprocessing 模块或 concurrent.futures.ProcessPoolExecutor。每个独立的操作系统进程都拥有专属的 Python 解释器实例和独立的 GIL,因此能够真正并行运行在不同的 CPU 物理核心上。
# -*- coding: utf-8 -*-
"""
Python 必背源代码:使用 ProcessPoolExecutor 突破 GIL 限制
"""
import time
from concurrent.futures import ProcessPoolExecutor

COUNT = 50_000_000

def cpu_bound_task(n: int) -> None:
    while n > 0:
        n -= 1

def run_multi_process() -> float:
    start = time.perf_counter()
    # 启动 2 个独立进程,分别利用独立核心
    with ProcessPoolExecutor(max_workers=2) as executor:
        f1 = executor.submit(cpu_bound_task, COUNT)
        f2 = executor.submit(cpu_bound_task, COUNT)
        f1.result()
        f2.result()
    return time.perf_counter() - start

if __name__ == "__main__":
    t_proc = run_multi_process()
    print(f"双进程并行执行耗时: {t_proc:.3f} 秒 (相较单线程 3.218 秒,提速接近 2 倍)")
六、并发模型选型决策与总结
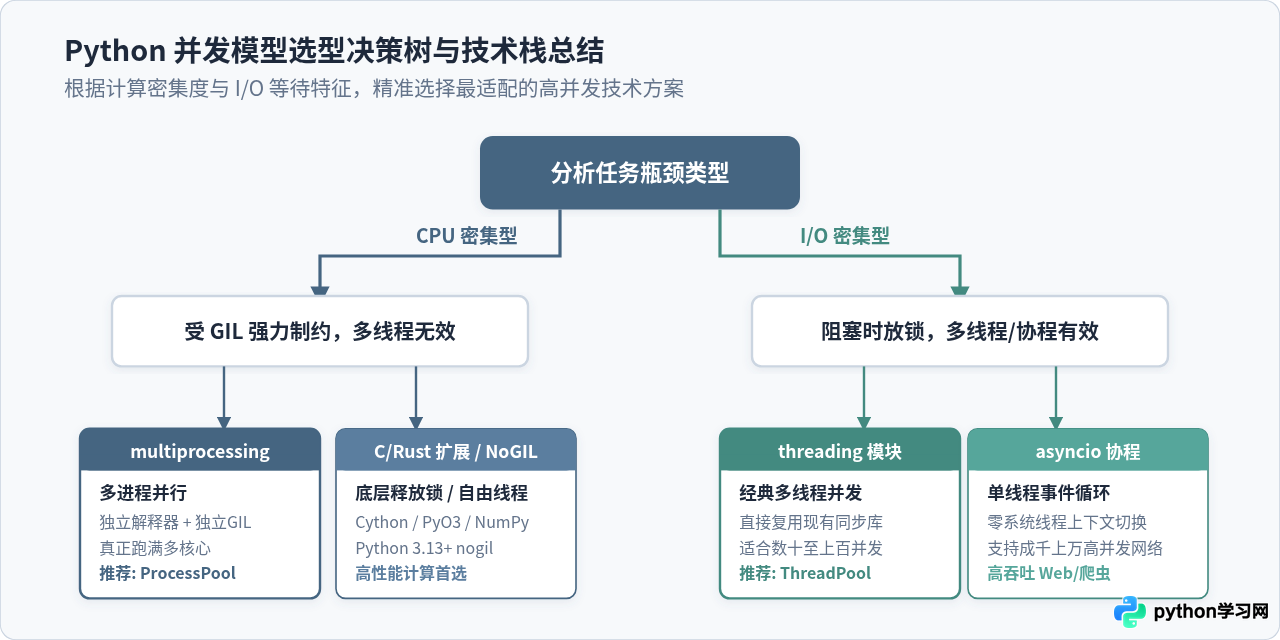
评估是否使用多线程时,应当基于业务代码的瓶颈特征进行决策:
- 选择
multiprocessing:适用于纯数值计算、视频/图像帧渲染、密码哈希计算、机器学习特征离线预处理等 CPU 密集型场景。注意跨进程传输超大对象时有序列化(pickle)开销。 - 选择
threading/ThreadPoolExecutor:适用于调用旧版阻塞型同步 SDK、多接口并发抓取、文件分块落盘等 I/O 场景。代码侵入性小,易于改写。 - 选择
asyncio协程:适用于超高并发(数千至数万连接)的长轮询、WebSocket 服务或微服务网关,拥有最低的内存占用和上下文切换损耗。 - 前沿进展(Python 3.13+ 自由线程 Free-threaded):自 Python 3.13 起,官方引入了实验性的禁用 GIL 构建选项(PEP 703
--disable-gil),未来在无需多进程的情况下也能直接让多线程在多核上并行执行纯 Python 代码,可根据生产环境的稳定度按需关注。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















