


Python三元运算符在列表推导式中的用法
深入讲解Python三元运算符在列表推导式中的具体用法,梳理前置三元运算与后置过滤条件的本质区别、执行流程、常见语法错误及工程编写规范。
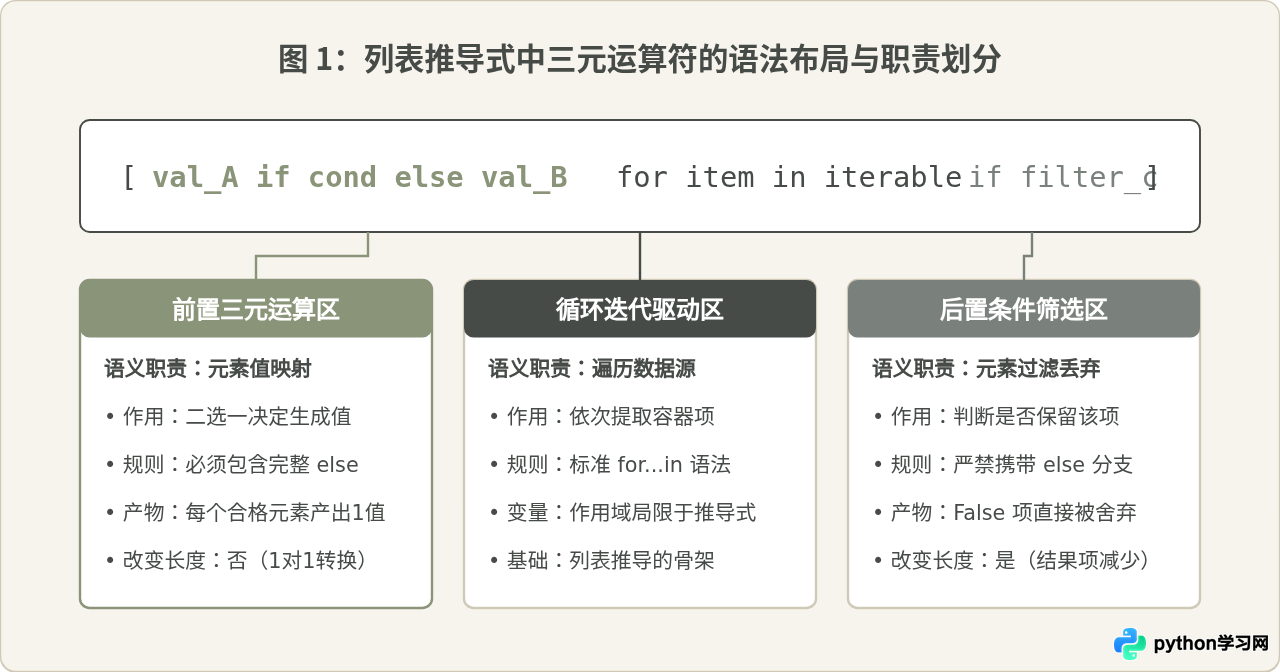
在 Python 列表推导式中使用三元运算符,核心目的是在构建新列表的同时,对每个元素执行二选一的值映射。其标准语法形式为 [值A if 条件 else 值B for 变量 in 可迭代对象]。与放置在推导式末尾用于排除元素的过滤语句不同,三元运算符位于表达式起始位置,属于值映射范畴,必须包含完整的 if...else 分支。
一、基本语法与结构定位
三元运算符(在 Python 官方称作条件表达式)的标准形态为 X if C else Y。当它嵌入到列表推导式中时,它的定位是“为每次迭代生成具体的元素值”。
理解该用法的关键,在于认清推导式中的不同职能分区:最左侧是针对元素进行计算或选值的表达式区,中间是驱动循环的 for...in 区,最右侧则是可选的筛选过滤区。
下面是一个直观的基础示例。我们要对一组整数打上奇偶标记:
numbers = [1, 2, 3, 4, 5]

# 使用三元运算符映射每个数字的类别
labels = ["偶数" if n % 2 == 0 else "奇数" for n in numbers]

print(labels)
# 示例输出:['奇数', '偶数', '奇数', '偶数', '奇数']在上面的代码中,"偶数" if n % 2 == 0 else "奇数" 整体作为一个完整的表达式单元。Python 会在每一次循环迭代中,先计算 n % 2 == 0 的布尔结果。如果为 True 则取 "偶数",为 False 则取 "奇数",并将选定后的值存入新生成的列表中。
二、执行推导过程与数据流向
很多开发者在初学时容易混淆推导式内部各部分的求值次序。从执行机制来看,三元运算符并不是首先运行的代码,数据源的迭代与过滤始终发生在值计算之前。
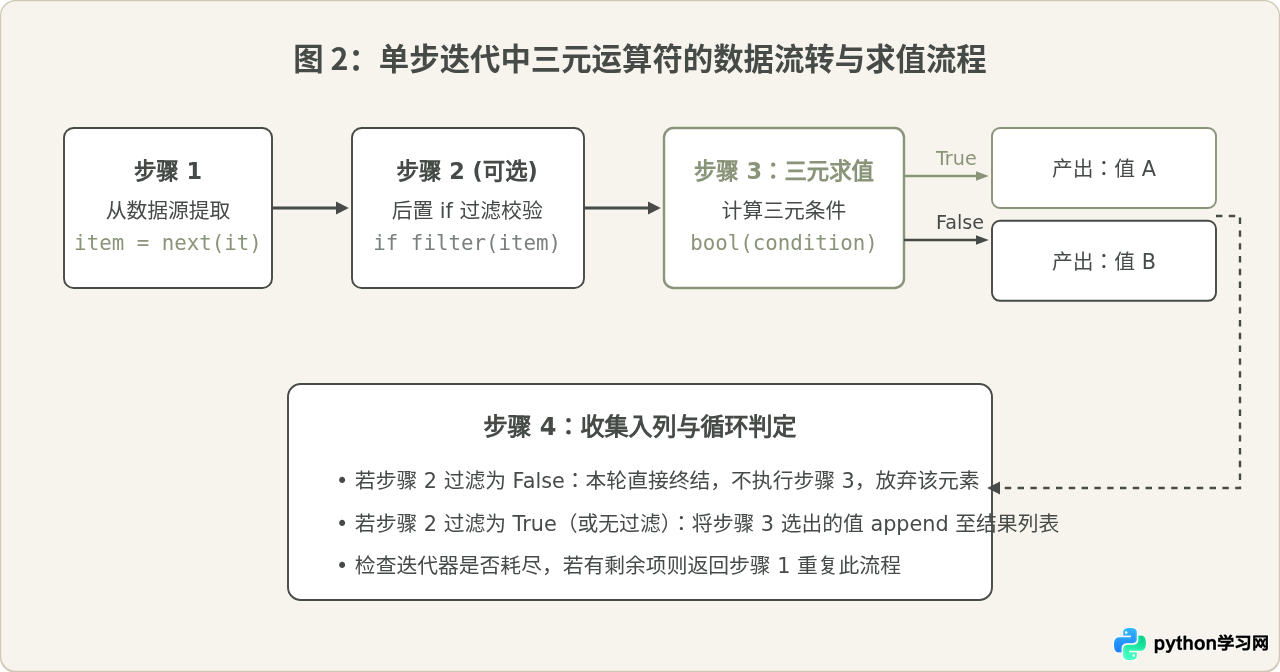
通过该流程可以清晰看出,整个运算周期分工明确:
- 数据源迭代:通过
for item in iterable提取待处理项。 - 前置三元运算评估:仅在元素通过可能存在的筛选后,才会对三元表达式中的条件进行判定。无论条件走向真还是假,都必须有一个确定的返回值被推导式捕获。
- 装配产物:新列表的元素总数,由通过筛选的元素个数严格决定,三元运算符本身绝不增删元素个数,只负责内容替换。
三、核心辨析:前置三元运算符 vs 后置过滤条件
在编写包含条件的列表推导式时,最容易出现的错误就是将“值映射”的 if...else 与“元素过滤”的 if 混为一谈。初学者常写出类似如下的代码并遭遇报错:
# 错误示例:试图在末尾过滤语句中使用 else
numbers = [10, -5, 20, -1]
# 下行代码将直接触发 SyntaxError: invalid syntax
# result = [x for x in numbers if x > 0 else 0]
要彻底避免此类语法错误,需要理解两者在 Python 语法树中的根本差异:
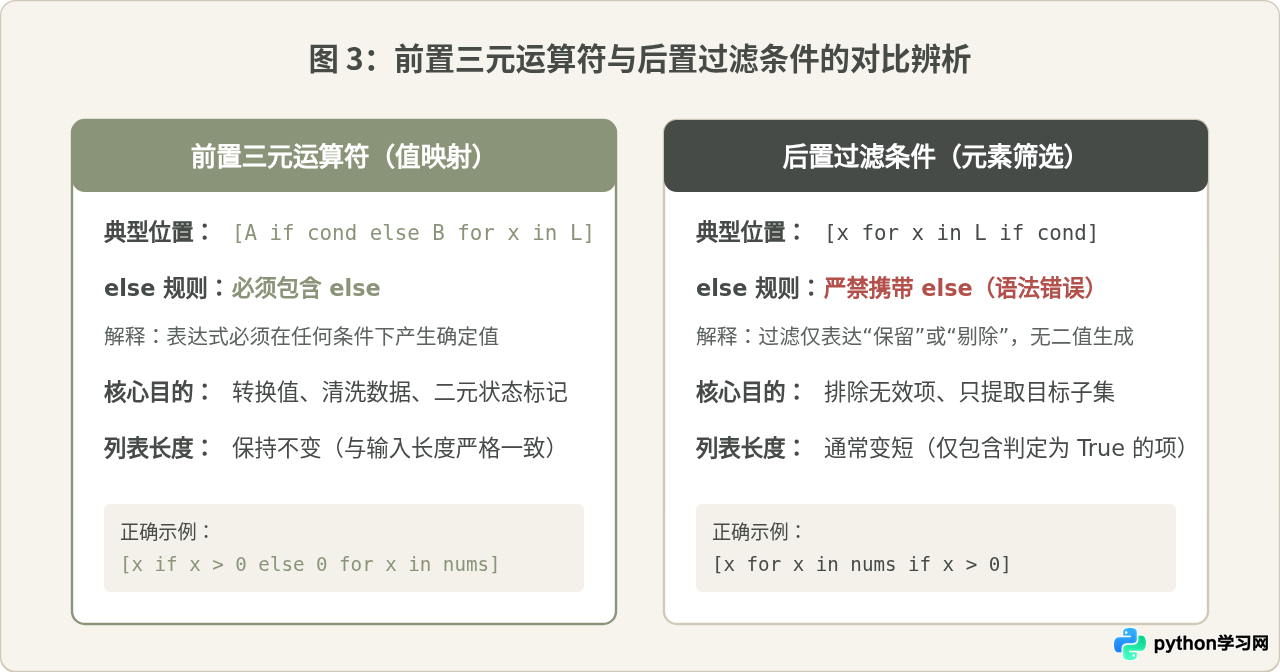
从上表与图示中可以清晰看到:
- 如果你希望输出列表与输入列表等长,只是部分元素按照特定规则进行数值替换或标记,必须使用前置三元运算符。
- 如果你希望输出列表中剔除某些不符合条件的元素,必须使用后置 if 过滤。
两者结合使用的高级场景
在真实业务中,我们经常遇到既需要过滤脏数据,又需要对留存数据执行分支转换的情况。此时两者可以完全结合使用:
raw_scores = [85, None, 42, 90, None, 60]

# 业务需求:
# 1. 过滤掉所有缺失的 None 值(后置 if)
# 2. 对有效分数按是否及格转换为 "Pass" 或 "Fail"(前置三元运算)
grades = ["Pass" if score >= 60 else "Fail" for score in raw_scores if score is not None]

print(grades)
# 示例输出:['Pass', 'Fail', 'Pass', 'Pass']
四、复杂条件与嵌套三元运算的边界与规范
Python 允许三元运算符进行链式嵌套,例如实现多级评定:
scores = [95, 82, 67, 54]

# 多分支三元嵌套(相当于 if...elif...else)
status = [
    "优秀" if s >= 90 else ("良好" if s >= 80 else ("及格" if s >= 60 else "不及格"))
    for s in scores
]

print(status)
# 示例输出:['优秀', '良好', '及格', '不及格']虽然语法上支持将三元运算符无限嵌套,但当嵌套层级超过 1 层时,代码的可读性和维护性会急剧恶化。遇到多于 2 个分支的场景时,强烈建议将分支逻辑提取为普通辅助函数,或者直接改写为显式的 for 循环结构。
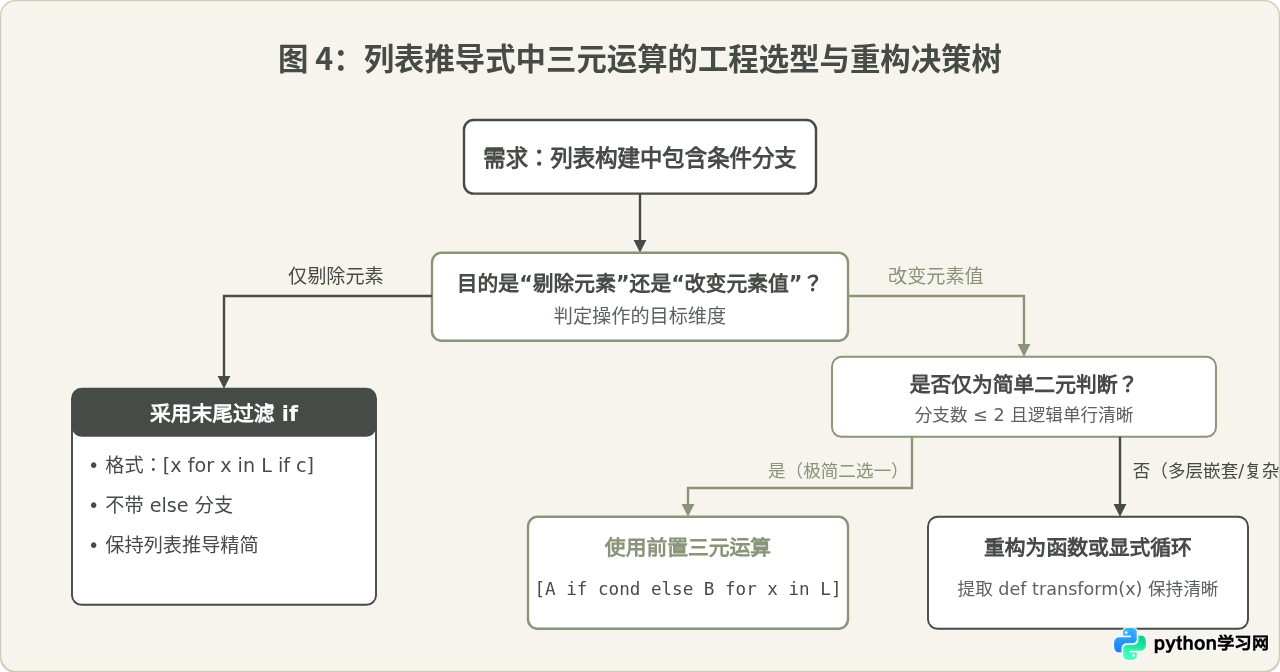
对多分支逻辑进行函数重构的代码示范如下:
# 推荐的工程化写法:将多重判断封装进独立函数
def evaluate_grade(score):
    if score >= 90:
        return "优秀"
    if score >= 80:
        return "良好"
    if score >= 60:
        return "及格"
    return "不及格"

scores = [95, 82, 67, 54]
# 列表推导式重新恢复清爽与极高可读性
status = [evaluate_grade(s) for s in scores]

print(status)
# 示例输出:['优秀', '良好', '及格', '不及格']
五、常见问题与注意事项总结
- 为什么在推导式开头不能只写
if而省略else?
因为位于开头的表达式负责给列表产出具体的元素。如果不写else,当条件为False时,Python 解释器无法得知该位置应当赋予什么对象,从而破坏表达式的确定性,因此语言规范强制要求在此位置必须包含else。 - 三元运算中的短路求值特性:
与普通if-else语句相同,三元运算符具有短路特性。如果condition为True,则只有左侧表达式会被计算,右侧else后的表达式完全不会被执行。这在避免除以零或调用可能报错的函数时非常实用。例如:data = [10, 0, 5, 0, 2] # 即使包含 0 也不会触发 ZeroDivisionError,因为为 0 时右侧未执行 inverted = [100 / x if x != 0 else 0 for x in data] - 代码行长度与格式化:
如果三元运算符与列表推导式组合后单行字符较长,可以利用 Python 的括号隐式换行特性,将推导式拆分为多行排版,增强团队协作中的可维护性:clean_data = [ item.strip().upper() if isinstance(item, str) else "" for item in raw_list if item is not None ]
六、核心要点总结口诀
掌握列表推导式与条件结合的逻辑,可以总结为以下两句话:
- “前值映射带 else,二选一值不改长”:放在
for前面的条件表达式是三元运算,必须带else,输出与输入数量一致。 - “后过滤筛选无 else,真留假弃列表短”:放在
for后面的条件语句是过滤子句,绝不能带else,用于筛选目标元素。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















