


Python读取.xls和.xlsx文件指定单元格该选哪个库
针对Python读取.xls与.xlsx文件中指定单元格的选库问题,详细对比openpyxl、xlrd、pandas与calamine的适用场景、坐标定位方式、只读优化及避坑指南。
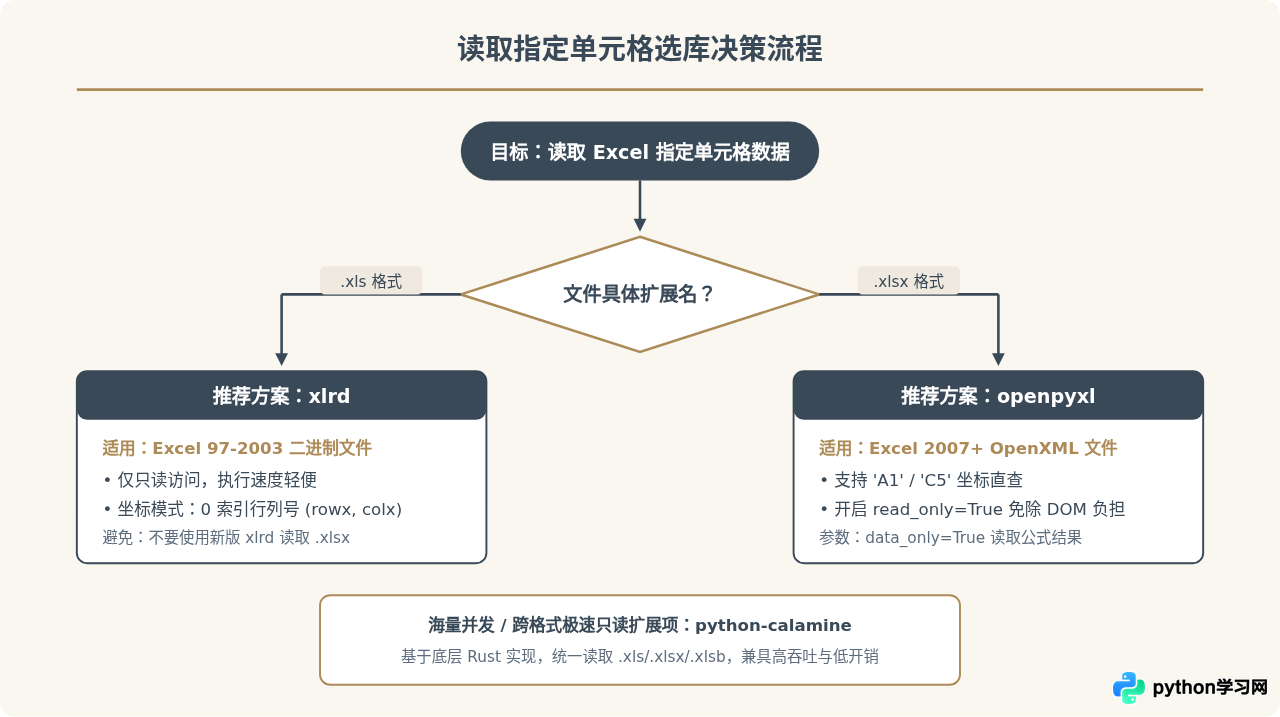
如果需要在 Python 中精确读取 Excel 文件的某几个指定单元格,最直接的选择原则是按文件格式进行分流:针对现代格式 .xlsx 文件,首选 openpyxl,它原生支持按单元格坐标直接获取数据,配合只读模式可以避免加载全表;针对老旧格式 .xls 文件,应当选择 xlrd(且版本锁定在仅读模式),它是读取二进制 Excel 97-2003 格式最轻量的纯 Python 方案。如果是只提取极少数几个单元格的数据,尽量不要选择 pandas,因为 pandas 底层会全量解析数据表并构建 DataFrame,在内存占用和解析耗时上都有不必要的开销。
一、为什么一种库难以同时兼顾 .xls 与 .xlsx?
许多初学者容易将 .xls 和 .xlsx 视为同一类文件的不同版本后缀,但在技术底层,二者有着本质差异。.xls 是微软在 Excel 97 至 2003 期间采用的专用复合二进制文档格式(BIFF8),所有表格数据、格式和元信息均以紧凑的字节流序列存储。要解析它,解析器必须完整实现 BIFF 二进制规范。
.xlsx 则是自 Excel 2007 引入的 OpenXML 标准。其实质是一个包含多个 XML 文本及元信息清单的 ZIP 压缩包,单元格数据分散存储在工作表 XML 与全局共享字符串池(sharedStrings.xml)中。由于两者的数据结构与解码逻辑截然不同,Python 生态中的库往往各专其长。
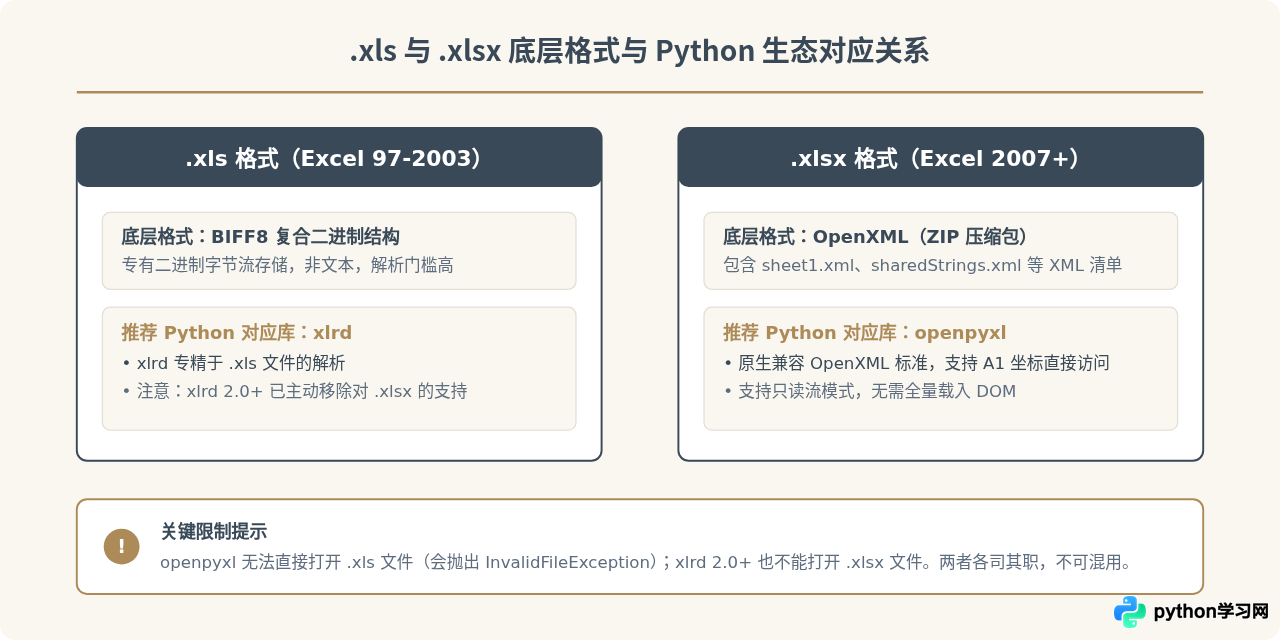
曾有相当长一段时间,开发者习惯用 xlrd 同时读取两种格式。但从 2020 年发布的 xlrd 2.0.1 开始,官方正式移除了对 .xlsx 的支持代码,主要原因在于 OpenXML 规范极其庞大,继续维护极易引入安全隐患与兼容性漏洞。因此,处理双格式任务时,针对不同扩展名分流处理已经成为标准实践。
二、各核心库的定位能力与代码示例
1. 读取 .xlsx 的首选工具:openpyxl
openpyxl 是目前 Python 处理 .xlsx 文件的事实标准。当目标是获取指定单元格时,openpyxl 提供了符合人类阅读习惯的语法(如 sheet['B3'])以及按行号、列号数值定位的语法(sheet.cell(row=3, column=2))。
若文件较大且仅提取少量单元格,务必开启 read_only=True 模式。默认模式下 openpyxl 会将整张表的 XML 节点全部构建为内存对象,内存消耗会翻数十倍;而 read_only=True 采用流式解析器,在读完指定单元格后直接关闭即可。
import openpyxl

def read_xlsx_cell(file_path, sheet_name, cell_coord):
    # read_only=True 加快大文件加载,data_only=True 确保读取公式的计算结果而非公式字面量
    wb = openpyxl.load_workbook(file_path, read_only=True, data_only=True)
    try:
        sheet = wb[sheet_name]
        # 支持 'A1'、'C5' 等标准坐标字符串
        val = sheet[cell_coord].value
        return val
    finally:
        wb.close()

# 示例调用
target_val = read_xlsx_cell("report.xlsx", "Sheet1", "C5")
print(f"单元格 C5 的数据为: {target_val}")
2. 读取 .xls 的可靠工具:xlrd
对于早期的 .xls 格式,在只读场景下 xlrd 依然是最稳定、轻便的选择。使用 xlrd 时需要注意两点:第一,单元格坐标采用从 0 开始计数的行列数值(例如第 1 行第 1 列对应 rowx=0, colx=0);第二,如果单元格存放的是日期,xlrd 会将其读取为浮点数,需要借助 xldate_as_datetime 进行转换。
import xlrd

def read_xls_cell(file_path, sheet_name, row_idx, col_idx):
    # 打开工作簿,仅读模式开销小
    book = xlrd.open_workbook(file_path)
    sheet = book.sheet_by_name(sheet_name)

    # 获取单元格对象并提取真实值(row_idx 和 col_idx 均为 0 索引)
    cell = sheet.cell(row_idx, col_idx)
    return cell.value

# 示例调用:获取第 3 行第 2 列(对应 Excel 中的 B3 单元格,索引为 2, 1)
target_val = read_xls_cell("history.xls", "Summary", 2, 1)
print(f"单元格 (row=2, col=1) 的数据为: {target_val}")
3. 为什么不建议用 pandas 读取指定单元格?
在数据分析工作中,pandas.read_excel() 是非常高频的函数。然而对于“仅读取指定单元格”这一需求,pandas 并不是合适的选择。原因包括:
- 全表解析开销:pandas 底层也是调用 openpyxl 或 xlrd,但它会将整张工作表完整遍历、转换为二维 NumPy 数组并推断每一列的类型,即便只想读 A1 单元格,也必须承受整表解析的耗时。
- 内存占用膨胀:对于几十兆的大型 Excel 文件,pandas 会在内存中分配数百兆的 DataFrame 结构,处理效率较低。
- 坐标转换繁琐:DataFrame 会根据表头和索引重排结构,直接按 Excel 的物理坐标(如 C5)去索引 DataFrame 容易因为表头偏移出现行号错位。
4. 追求极致性能的双格式新选择:calamine
如果业务系统需要处理成千上万个 Excel 文件,且格式既有 .xls 又有 .xlsx,可以关注 python-calamine。它是基于 Rust 核心库 calamine 封装的 Python 绑定,专门针对 Excel 的只读解析进行底层优化,支持 .xls、.xlsx、.xlsb 多种格式,解析速度比纯 Python 库快 3 到 5 倍。不过如果仅是普通脚本或读取单个文件,安装标准的 openpyxl 和 xlrd 足以满足需求。
三、操作步骤与核心注意事项
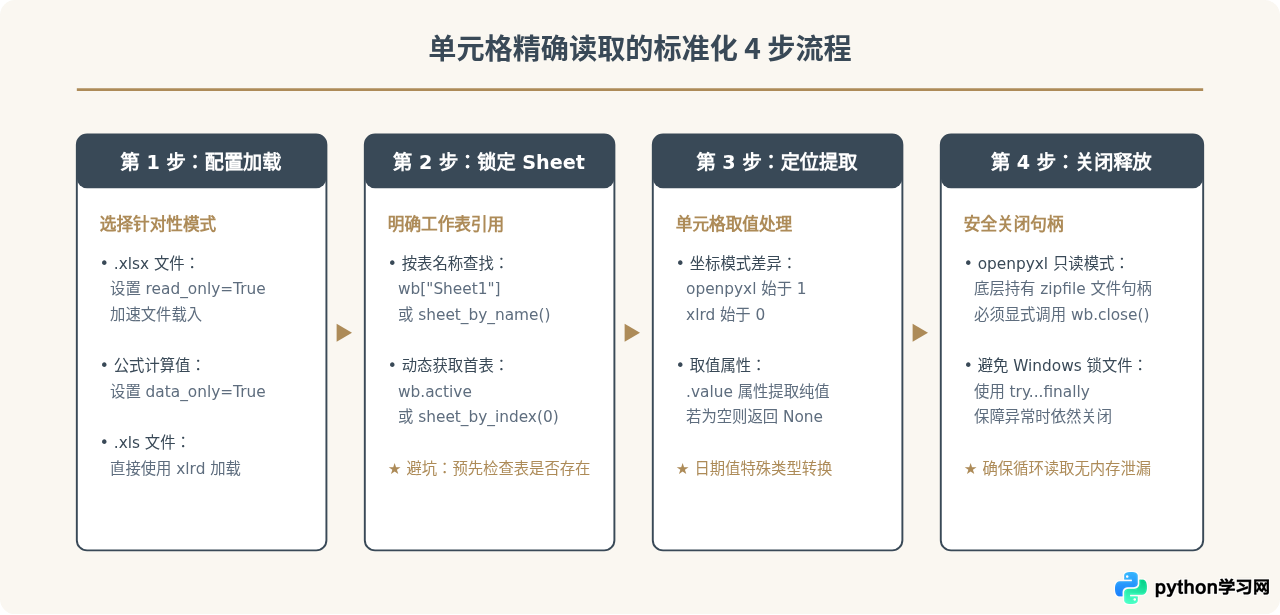
为了保证程序运行的健壮性与准确度,在编写代码提取指定单元格时,应遵循规范的操作步骤,并规避常见的解析陷阱。
1. 坐标体系的差异(1-based 与 0-based)
这是混用不同库时最常踩的坑。Excel 界面中的列是以字母呈现(A、B、C……),行是以数字从 1 开始呈现。
- openpyxl:采用符合常规感知的 1 索引。使用
cell(row=1, column=1)代表 A1;使用['B3']代表第 3 行第 2 列。 - xlrd:完全采用程序员习惯的 0 索引。
sheet.cell(0, 0)对应 A1 单元格;Excel 里的 B3 单元格在 xlrd 中必须写成sheet.cell(2, 1)。
2. 公式单元格的处理:公式字符串 vs 计算结果
Excel 中的某个单元格可能是形如 =SUM(A1:A10) 的公式。Python 库在默认情况下只会解析 XML 中的公式文本,因此如果直接访问,拿到的会是字符串 "=SUM(A1:A10)",而不是求和后的数值。
注意:在 openpyxl 中,若要读取上次保存时的实际数值,需在加载时传入 data_only=True。如果该 Excel 文件是由第三方系统直接生成且从未在 Excel 软件中打开并重新保存过,公式对应的缓存计算值可能为空,此时 data_only=True 会直接返回 None。
3. 只读模式下必须显式关闭工作簿
在 openpyxl 开启 read_only=True 后,内部会保持对底层 ZIP 归档文件的打开状态。如果在一个高频遍历的循环中只读取单元格而不调用 wb.close(),在 Windows 平台上会导致该文件被持续占用锁定,在 Linux 平台上则可能触发系统的“Too many open files”文件描述符耗尽异常。
四、多方案综合对比与最终选型建议
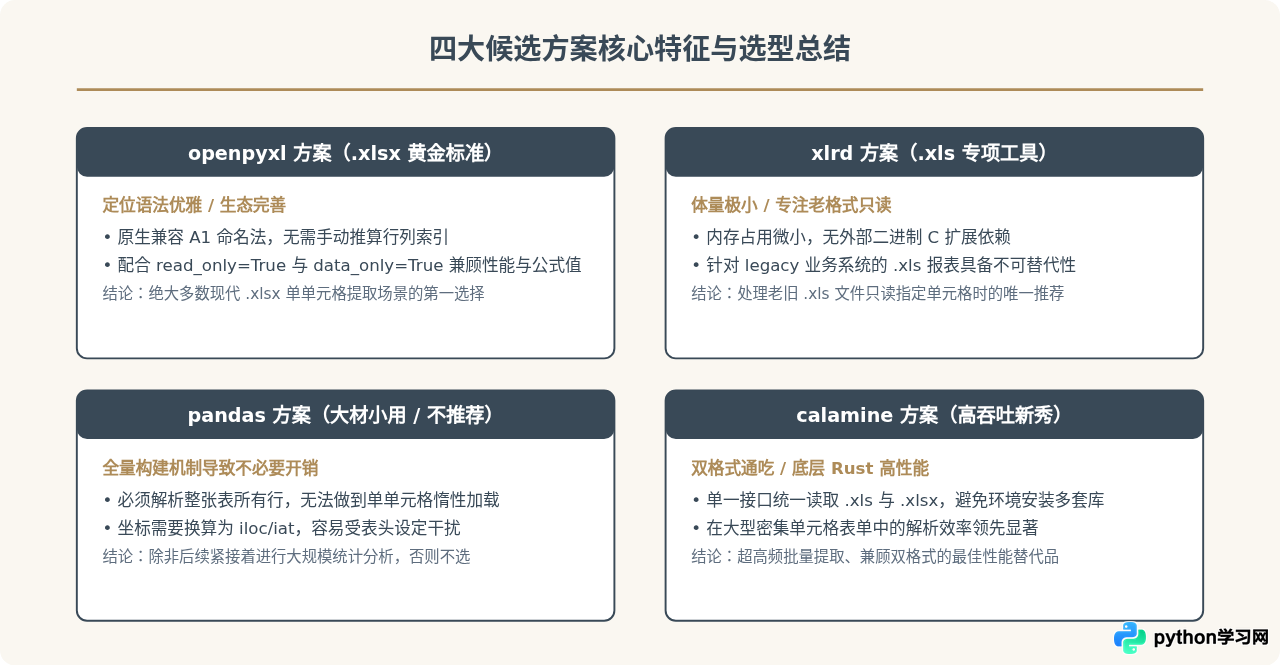
为了帮助在不同业务场景中做出最合适的工程决策,以下将主流候选方案在支持格式、定位便捷性、依赖体积和读取性能等维度进行横向归纳:
| 库名称 | 主要适用格式 | 指定单元格语法 | 内存与读取性能 | 最适场景 |
|---|---|---|---|---|
| openpyxl | .xlsx | ws['B3'] 或 ws.cell(3,2) |
轻量(开启 read_only=True) | 现代 Excel 单个或离散少量单元格直接读取 |
| xlrd | .xls | sheet.cell(2, 1) |
极低开销,速度快 | 老旧系统导出的 .xls 文件快速提取字段 |
| python-calamine | .xls / .xlsx / .xlsb | sheet.get_data()[row][col] |
极高(Rust 多核优化) | 海量双格式批量只读任务,追求极致吞吐 |
| pandas | 两者均可(调底层) | df.iat[row, col] |
偏重(全表建表、类型推断) | 后续需要对整表做清洗、透视与复杂分析时 |
五、结语与工程落地方案
回到最初的问题“Python读取.xls和.xlsx文件指定单元格该选哪个库”:在常规工程实践中,答案应当是按后缀组合分流。如果只处理 .xlsx,直接使用 openpyxl 配合 read_only=True 即可获得最清晰的坐标表达与优异的性能;如果只处理 .xls,选择 xlrd(0 索引定位)最为轻便;如果需要同时兼容两者,建议根据扩展名封装一个简易的分发函数,在 .xlsx 下分发至 openpyxl,在 .xls 下分发至 xlrd,既保持了各自底层的高兼容性,又避免了全表载入的性能损耗。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















