


python必背源代码split和join字符串处理代码
本文详解Python字符串处理中最基础且核心的split与join方法。包含核心语法、默认空白处理机制、maxsplit截断控制、非字符串元素转换以及高频避坑源代码示例。
在 Python 文本处理中,最基础、调用频率最高的操作就是字符串的“拆分”与“组合”。split() 负责将单一的整体字符串依据指定分隔符切割为独立的列表元素;而 join() 则负责将列表等序列中的多个字符串元素粘合为一个崭新的整串。两者互为逆操作,掌握它们的基础语法、参数边界、性能差异以及类型限制,是写出稳健且高效文本处理代码的核心前提。
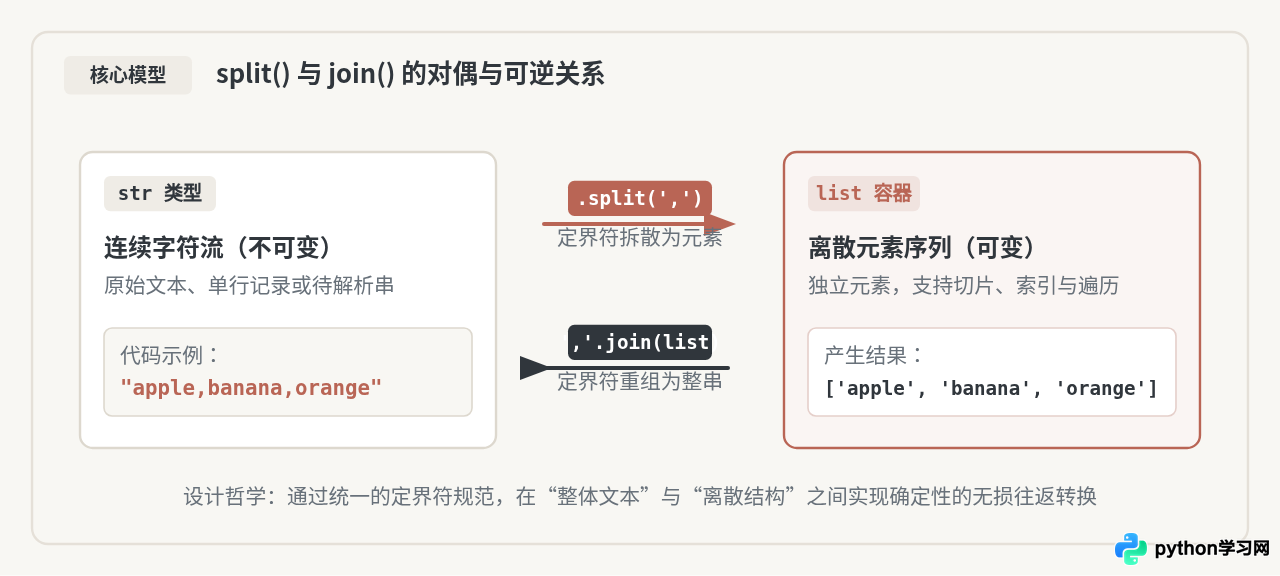
一、str.split():核心语法与必背基础代码
str.split() 是 Python 字符串内置的拆分方法。它的完整函数签名如下:
str.split(sep=None, maxsplit=-1)该方法接收两个可选参数:sep 表示定界符(分隔依据);maxsplit 规定最大切分次数,默认值为 -1,表示无限制切分直到字符串末尾。返回结果永远是一个 list 类型。
1. 必背代码 1:指定定界符拆分数据
当处理 CSV、日志行或路径等规则格式时,直接传入明确的单字符或多字符分隔符:
# 场景:解析逗号分隔的字段与连字符格式
record = "2026-11-17,GET,/api/v1/users,200,OK"
fields = record.split(",")

# 示例输出:
# ['2026-11-17', 'GET', '/api/v1/users', '200', 'OK']
print(fields)
2. 必背代码 2:利用默认参数处理杂乱空白(极高频)
当 sep 不传或为 None 时,split() 具备一种极其智能的机制:它会将任意连续的空白符(包括连续空格、制表符 、换行符
)统一视作单一分隔符,并且会自动忽略字符串首尾的全部空白。
# 场景:清洗排版参差不齐的自然语言句子
raw_text = "   Python    is  	  fast
  and  clean!   "
words = raw_text.split()

# 示例输出:
# ['Python', 'is', 'fast', 'and', 'clean!']
print(words)
二、进阶控制:maxsplit 截断与 rsplit 逆向拆分
日常开发中常常遇到“只切前面几次,后半部分内容保持原样”的业务需求(例如提取键值对、提取命令前缀等)。此时 maxsplit 参数能够避免破坏数据内部的结构。
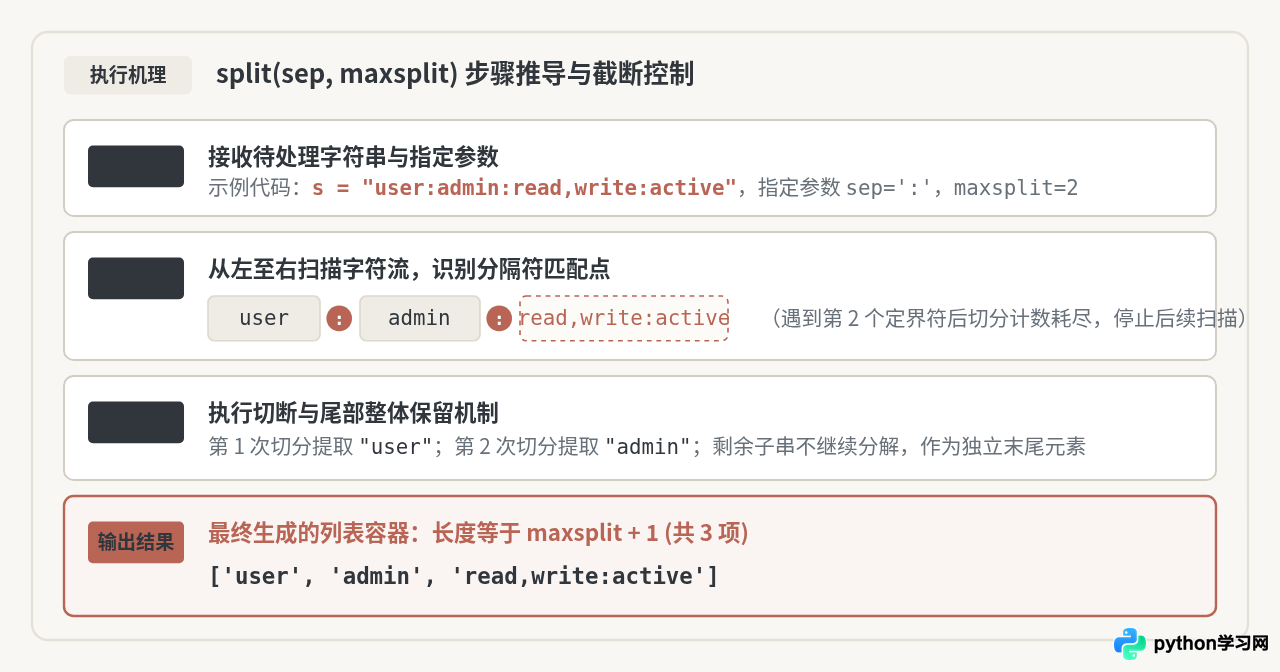
1. 必背代码 3:maxsplit 限制切分次数
例如解析含有冒号的配置行,只提取键与类别,而保留值中包含的完整冒号内容:
# 场景:解析结构形如 "key:type:content:with:colons"
config_line = "payload:json:{'status': 200, 'msg': 'ok'}"

# 仅从左向右切断 2 次
parts = config_line.split(":", maxsplit=2)

# 示例输出:
# ['payload', 'json', "{'status': 200, 'msg': 'ok'}"]
print(parts)
print("剩余部分保持完整:", parts[2])
2. 必背代码 4:rsplit 从右向左定向切分
如果目标提取物位于字符串尾部(例如获取文件名中的扩展名、提取 URL 路径的最底层目录),使用 rsplit() 结合 maxsplit 更加直接:
# 场景:提取文件后缀名,避免文件名中多个点被多余切分
filename = "backup.2026.final.tar.gz"
name, ext = filename.rsplit(".", maxsplit=1)

# 示例输出:
# 基础名: backup.2026.final.tar | 后缀: gz
print(f"基础名: {name} | 后缀: {ext}")
三、关键陷阱:sep=None 与 sep=' ' 的本质差异
初学者极易混淆无参数的 s.split() 与显式传单空格的 s.split(' ')。表面上看两者都在找空格,但两者的处理逻辑存在根本分歧:
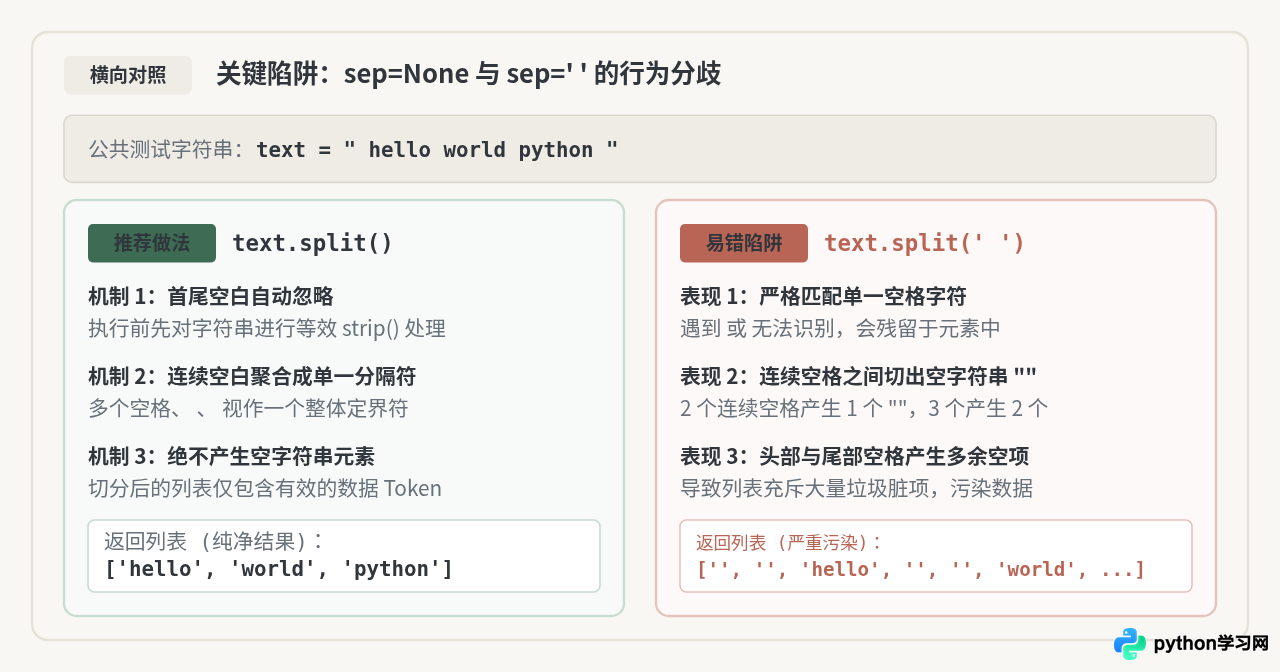
sep=None:激活算法预清洗,两端空白被消除,任意长度的连续空白集(包含 、
等)当作单次分隔,绝不会在结果列表中产生空字符串 ""。
sep=' ':执行严格字面匹配。每个物理空格都被视作一处切分刀口;两个相邻空格之间因为没有实际字符,必定切出一个空字符串 "";字符串开头或结尾的空格同样会在两端留下 ""。
sample = "  apple   banana  "

# 模式 A:默认行为
res_none = sample.split()
# 示例输出:['apple', 'banana']

# 模式 B:显式单空格
res_space = sample.split(" ")
# 示例输出:['', '', 'apple', '', '', 'banana', '', '']

print("split():", res_none)
print("split(' '):", res_space)
四、str.join():高效拼接字符串的必背范式
与 split() 相对应,join() 用于将序列中的各元素黏合成单个字符串。其基本语法为:
separator.join(iterable)初次接触该语法的开发者常有疑问:为什么不是 list.join(separator)? 原因在于 Python 的正交性设计:只要传入的对象是可迭代的(如 list、tuple、set、生成器等),都能使用字符串定界符进行连接;若将 join 定义在 list 上,则其他序列类型就必须重复实现该方法。
1. 必背代码 5:基础序列拼接
tags = ["python", "backend", "developer"]

# 逗号连接
tag_str = ", ".join(tags)
# 示例输出:"python, backend, developer"

# 换行连接(常用于组装输出报告)
report_lines = ["Header: Status Report", "Total: 100", "Success: 100"]
full_report = "
".join(report_lines)
2. 必背代码 6:非字符串元素的转换拼接(防 TypeError 踩坑)
join() 存在严格的类型约束:待拼接的 iterable 中每一个元素必须全部是 str 类型。如果列表中包含数字 int、浮点数或 None,直接调用会立刻触发 TypeError: sequence item 0: expected str instance, int found。
numbers = [101, 202, 303, 404]

# 错误写法(抛出 TypeError 异常):
# result = "-".join(numbers)

# 正确方案 A:使用 map(str, ...) 惰性转换
result_a = "-".join(map(str, numbers))

# 正确方案 B:使用列表推导式
result_b = "-".join(str(n) for n in numbers)

# 示例输出:
# "101-202-303-404"
print(result_a)Python 中的 str 是不可变对象。每次通过 s += item 拼接时,系统都必须重新开辟一块全新内存,把旧字符串内容与新字符逐一复制过去。循环 N 次的时间复杂度退化为 $O(N^2)$。
而 join() 算法会预先遍历一次序列,精确计算出最终字符串的总字节长度并一次性分配内存,随后单次填充完成,时间复杂度仅为 $O(N)$。在处理上万级文本元素时,两者性能差距可达百倍以上。
五、组合实战:文本清洗与规范化重组的标准流水线
在实际工程场景中,split() 与 join() 很少孤立出现,它们通常紧密配合,构成“拆分 -> 清洗/过滤 -> 重组”的标准数据清洗流水线。
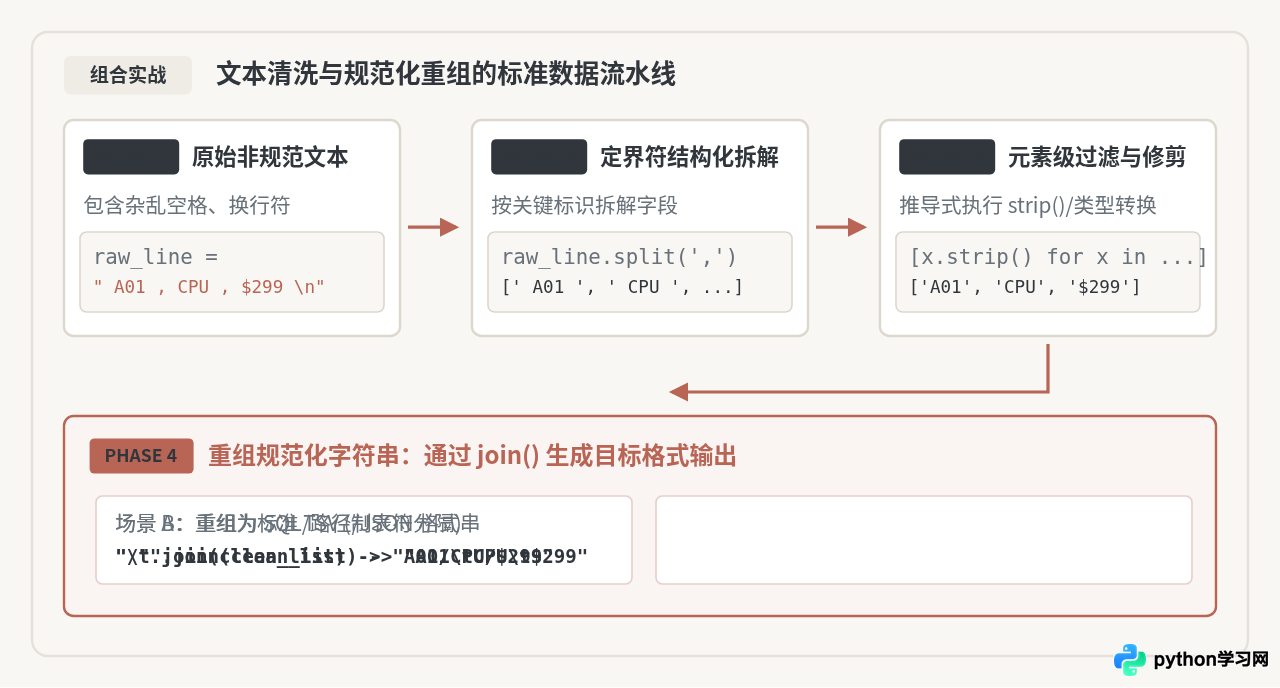
必背代码 7:多空格压缩与标点规范化
快速将一段夹杂各种制表符、连续多空格的杂乱排版缩减为单一空格规范句:
dirty_sentence = "Data   Science    requires  	 clean
  datasets."

# 经典一行流:无参 split 聚合空白,再用单空格 join
clean_sentence = " ".join(dirty_sentence.split())

# 示例输出:
# "Data Science requires clean datasets."
print(clean_sentence)
必背代码 8:脏 CSV 数据行字段规范化转 TSV
raw_row = "  ID_99201 ,  Mechanical Keyboard  ,  159.00  ,  In Stock
"

# 1. 拆分字段并去除各个字段两端的无效空格
cleaned_fields = [item.strip() for item in raw_row.split(",")]

# 2. 转换为标准制表符分隔行 (TSV)
tsv_row = "	".join(cleaned_fields)

# 示例输出:
# "ID_99201	Mechanical Keyboard	159.00	In Stock"
print(repr(tsv_row))
六、知识总结与避坑速查
掌握 split 与 join 的关键在于记住它们的输入输出契约、参数行为与错误规避方法。
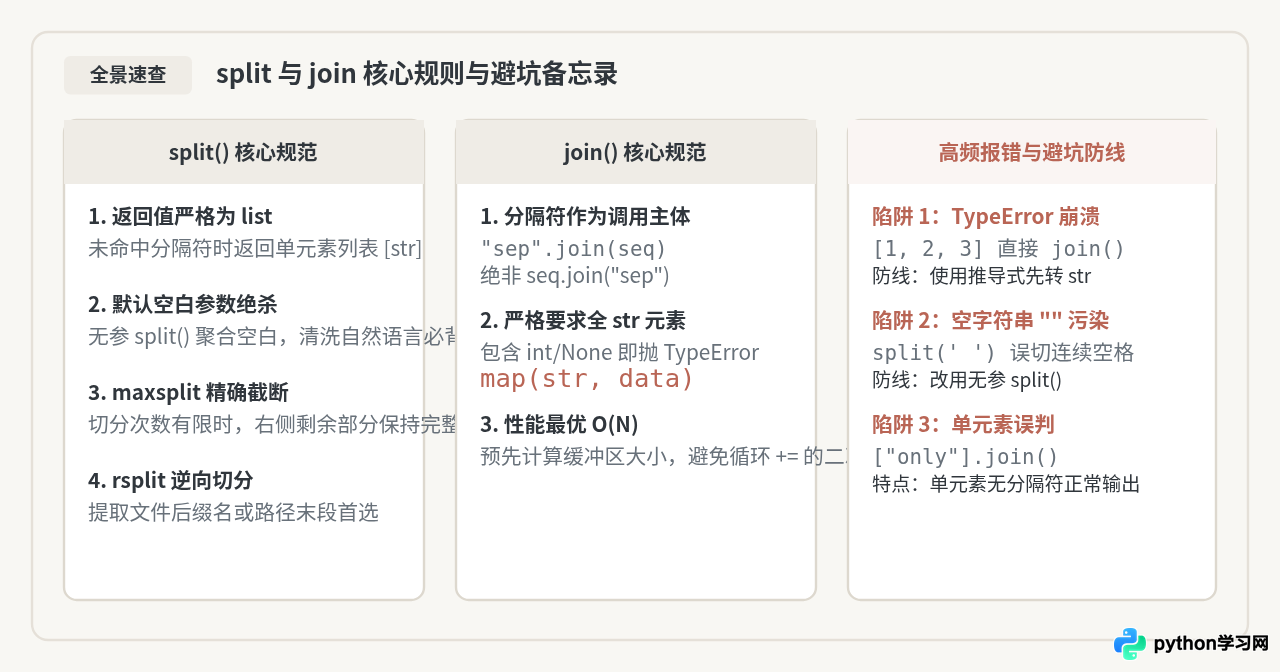
| 方法名称 | 调用主体 | 核心入参 | 返回值类型 | 高频踩坑点 |
|---|---|---|---|---|
str.split() |
目标字符串 (str) | sep=None, maxsplit=-1 |
list[str] |
显式传 ' ' 导致连续空格产生大量 "" 空项 |
str.rsplit() |
目标字符串 (str) | sep=None, maxsplit=-1 |
list[str] |
从右向左切分,在需提取尾部后缀时配合 maxsplit=1 最有效 |
str.join() |
定界符字符串 (str) | 可迭代序列 iterable |
str |
若列表中混入 int 等非 str 元素,抛出 TypeError 崩溃 |
常见疑问解答 (FAQ)
- 问:如果被 split 的字符串中根本不存在该定界符,会抛错吗?
答:不会报错。方法会返回一个仅包含原字符串本身的单元素列表,如"hello".split(",")的结果为['hello']。 - 问:待 join 的列表只有一个元素,定界符会加在末尾吗?
答:不会。定界符只插入在元素“之间”。当列表仅有 1 个元素时,join直接返回该元素原样字符串;列表为空时返回空字符串""。 - 问:为什么不能写
["a", "b"].join(",")?
答:因为join是属于字符串类型str的方法,定界符才是调用对象(例如",".join(...))。这是 Python 为了让join能够支持所有迭代器而采取的设计。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















