


Python文件读写操作练习题:CSV与JSON数据处理实战解析
针对Python初学者与数据处理学习者精选的CSV与JSON文件读写练习题解析,涵盖csv.reader、DictWriter、json.load、嵌套数据清洗及双向互转实战,配备详尽步骤图解与避坑指南。
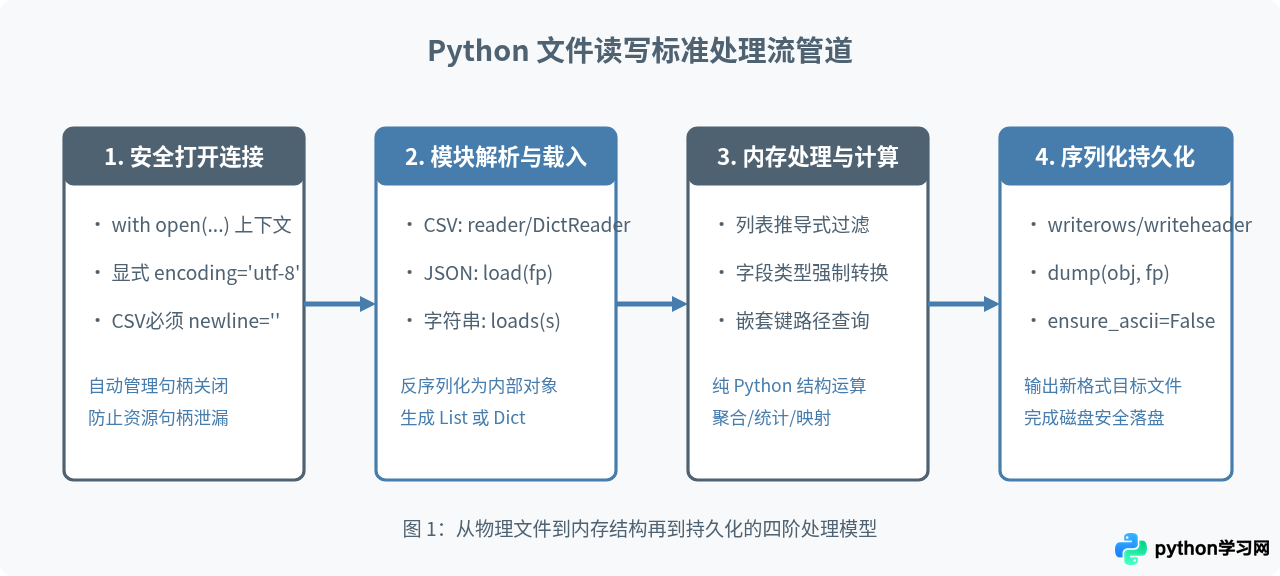
在日常数据清洗与后端接口开发中,绝大多数离线数据与结构化文本均以 CSV 和 JSON 格式存在。很多开发者在初学时能记住 open() 的基本用法,但在面对真实场景中的多列过滤、字段类型推导、多层嵌套提取以及跨格式转换时,常遇到编码乱码、多余空行、特殊类型无法序列化等棘手问题。掌握 Python 标准库中的 csv 与 json 模块,是夯实工程基础的关键一步。本文通过四个典型实战练习题,深入解析从物理文件读取、内存结构清洗到规范化持久化的全流程操作。
练习题一:CSV 文件基础读写与数值清洗过滤
【题目情景】 现有一个名为 scores.csv 的班级成绩单文件,内容包含学生学号、姓名、科目和成绩四列。请编写 Python 脚本,筛选出成绩大于等于 80 分的所有记录,并在每行末尾追加等级标记(成绩 ≥ 90 为 "A",80 ≤ 成绩 < 90 为 "B"),最后将处理结果保存至 qualified_scores.csv 中。
解题思路与完整代码
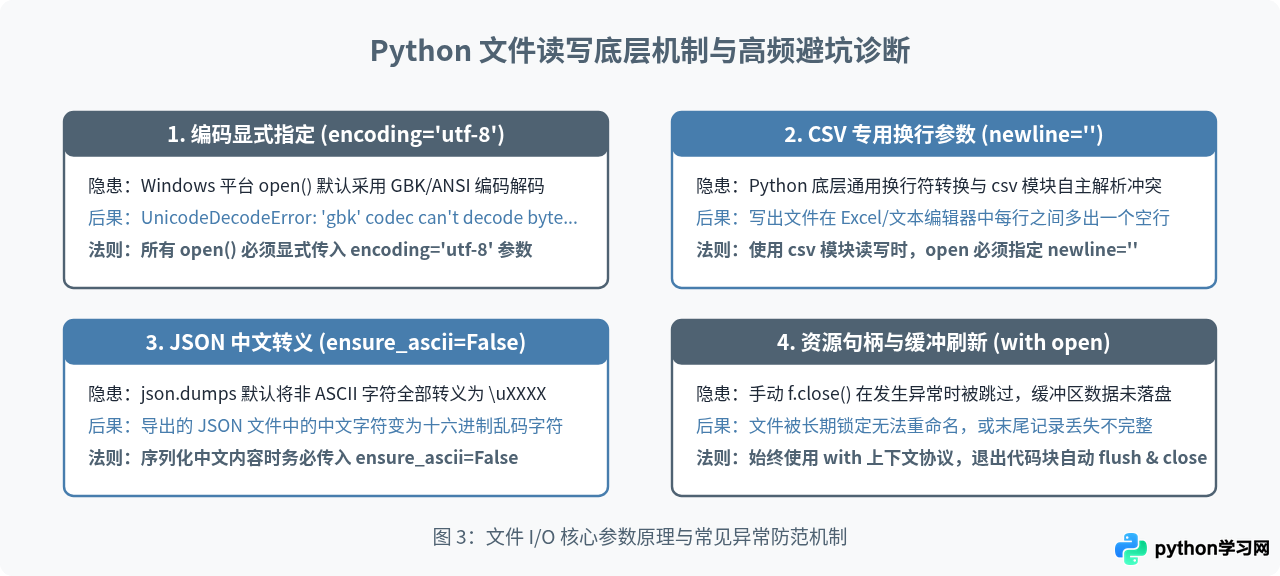
使用 csv.reader 处理按行分隔的表格数据。由于从 CSV 中读取的每一项默认都是字符串,进行数值大小比较前必须使用 float() 或 int() 显式转换。此外,写入文件时必须指定 newline='',否则在 Windows 操作系统中会因平台默认换行机制产生交替空行。
import csv

def filter_and_grade_scores(input_path, output_path):
    # 步骤 1:以 utf-8 编码打开输入文件,使用 newline='' 遵循 csv 规范
    with open(input_path, mode='r', encoding='utf-8', newline='') as infile:
        reader = csv.reader(infile)
        header = next(reader)  # 提取表头

        # 新表头追加等级列
        new_header = header + ['grade']
        qualified_rows = []

        # 步骤 2:逐行迭代处理数据
        for row in reader:
            if not row:
                continue
            student_id, name, subject, score_str = row
            score = float(score_str)

            # 过滤与等级划分
            if score >= 80:
                grade = 'A' if score >= 90 else 'B'
                qualified_rows.append([student_id, name, subject, score_str, grade])

    # 步骤 3:写出目标 CSV
    with open(output_path, mode='w', encoding='utf-8', newline='') as outfile:
        writer = csv.writer(outfile)
        writer.writerow(new_header)
        writer.writerows(qualified_rows)

# 执行示例
if __name__ == '__main__':
    filter_and_grade_scores('scores.csv', 'qualified_scores.csv')
    print("成绩清洗与评级处理完毕!")
示例输入与输出展示
输入文件 scores.csv:
id,name,subject,score
101,张伟,Python,85
102,王芳,Python,76
103,李强,Python,94
104,赵敏,Python,68
运行后生成的 qualified_scores.csv:
id,name,subject,score,grade
101,张伟,Python,85,B
103,李强,Python,94,A
练习题二:使用 DictReader 与 DictWriter 优雅处理带表头数据
【题目情景】 在生产环境中,CSV 的列顺序往往会随着业务变更而调整。使用下标索引(如 row[3])容易导致代码脆弱、难以维护。某公司需要统计员工年终奖金明细,输入文件 employees.csv 包含 emp_id,name,department,base_salary,performance_score。请计算员工实际发放奖金(bonus = base_salary * performance_score * 0.1),输出包含 emp_id,name,bonus 的新文件 bonus_summary.csv。
核心代码实现
csv.DictReader 会将第一行自动解析为字典键,每行记录表现为一个映射对象;而 csv.DictWriter 需要显式声明 fieldnames 参数,通过 writeheader() 自动输出表头,并通过传递字典列表写入内容,容错率极高。
import csv

def calculate_bonus(input_file, output_file):
    processed_records = []

    with open(input_file, mode='r', encoding='utf-8', newline='') as f_in:
        reader = csv.DictReader(f_in)

        for row in reader:
            base_salary = float(row['base_salary'])
            perf_score = float(row['performance_score'])
            bonus = round(base_salary * perf_score * 0.1, 2)

            # 只提取输出所需的核心键
            processed_records.append({
                'emp_id': row['emp_id'],
                'name': row['name'],
                'bonus': bonus
            })

    # 输出目标字典结构
    fieldnames = ['emp_id', 'name', 'bonus']
    with open(output_file, mode='w', encoding='utf-8', newline='') as f_out:
        writer = csv.DictWriter(f_out, fieldnames=fieldnames)
        writer.writeheader()  # 写入首行表头
        writer.writerows(processed_records)

# 运行提示
# bonus_summary.csv 将精准保留目标列,即使源文件列顺序打乱亦不受影响
练习题三:JSON 嵌套数据解析、提取与结构重组
【题目情景】 从后端接口调取并缓存的本地文件 order_response.json 包含了客户订单的详细信息,其内部存在多层嵌套。请提取所有状态为 "COMPLETED" 的订单,并统计其购买商品的总件数及总金额,输出一个精简的统计报告文件 order_summary.json,要求具备清晰缩进且保留中文字符。
实战代码解析
对于文件流使用 json.load(),对于内存字符串使用 json.loads()。在序列化输出时,json.dump() 默认会启用 ensure_ascii=True,这会导致所有中文变成形如 \u4e2d\u6587 的 Unicode 转义字符。必须设置 ensure_ascii=False 才能正常输出中文字符;同时设置 indent=2 以便于人类阅读。
import json

def process_order_data(json_file_path, output_json_path):
    # 步骤 1:安全加载原始 JSON 文件
    with open(json_file_path, mode='r', encoding='utf-8') as f:
        raw_data = json.load(f)

    orders = raw_data.get('data', {}).get('orders', [])
    summary_list = []

    # 步骤 2:解构多层嵌套数据
    for order in orders:
        if order.get('status') == 'COMPLETED':
            order_id = order['order_id']
            user_info = order.get('user', {})
            buyer_name = user_info.get('username', '匿名用户')

            items = order.get('items', [])
            total_quantity = sum(item.get('quantity', 0) for item in items)
            total_amount = sum(item.get('price', 0.0) * item.get('quantity', 0) for item in items)

            summary_list.append({
                'order_id': order_id,
                'buyer': buyer_name,
                'item_count': total_quantity,
                'total_amount': round(total_amount, 2),
                'city': user_info.get('address', {}).get('city', '未知')
            })

    # 步骤 3:重组结果并美化保存
    output_payload = {
        'total_completed_orders': len(summary_list),
        'results': summary_list
    }

    with open(output_json_path, mode='w', encoding='utf-8') as f:
        # indent=2 控制缩进,ensure_ascii=False 确保中文字符不被转义
        json.dump(output_payload, f, ensure_ascii=False, indent=2)

# 示例输入 order_response.json 结构片段:
# {
#   "code": 200,
#   "data": {
#     "orders": [
#       {
#         "order_id": "ORD-2026-001",
#         "status": "COMPLETED",
#         "user": {"username": "李晨", "address": {"city": "上海"}},
#         "items": [{"name": "键盘", "price": 299.0, "quantity": 1}]
#       }
#     ]
#   }
# }
练习题四:综合实战——CSV 与 JSON 格式双向互转与结构转换
【题目情景】 数据分析团队通常接收到业务方导出的 users.csv,但前端展示系统需要层级结构的 users.json;同时,需要支持逆向操作,把扁平化的 JSON 日志还原为 CSV 供财务报表导出。请实现一个通用的双向格式转换工具函数。
通用双向转换模块实现
import csv
import json

class FormatConverter:
    @staticmethod
    def csv_to_json(csv_path, json_path, indent=2):
        """将 CSV 文件转换为树状结构或对象列表 JSON"""
        data = []
        with open(csv_path, mode='r', encoding='utf-8', newline='') as f:
            reader = csv.DictReader(f)
            for row in reader:
                # 尝试对数值型字符串进行自动类型推导
                cleaned_row = {}
                for k, v in row.items():
                    if v.isdigit():
                        cleaned_row[k] = int(v)
                    else:
                        try:
                            cleaned_row[k] = float(v)
                        except ValueError:
                            cleaned_row[k] = v
                data.append(cleaned_row)

        with open(json_path, mode='w', encoding='utf-8') as f:
            json.dump(data, f, ensure_ascii=False, indent=indent)

    @staticmethod
    def json_to_csv(json_path, csv_path):
        """将字典列表类型的 JSON 文件转换为扁平表格 CSV"""
        with open(json_path, mode='r', encoding='utf-8') as f:
            data = json.load(f)

        if not data or not isinstance(data, list):
            raise ValueError("输入的 JSON 数据必须为非空的对象列表!")

        # 动态提取所有可能出现的键作为表头,保持字段完备
        fieldnames = list(data[0].keys())

        with open(csv_path, mode='w', encoding='utf-8', newline='') as f:
            writer = csv.DictWriter(f, fieldnames=fieldnames)
            writer.writeheader()
            writer.writerows(data)

# 测试双向互转
if __name__ == '__main__':
    # 模拟数据并验证
    print("双向互转适配器加载就绪。")
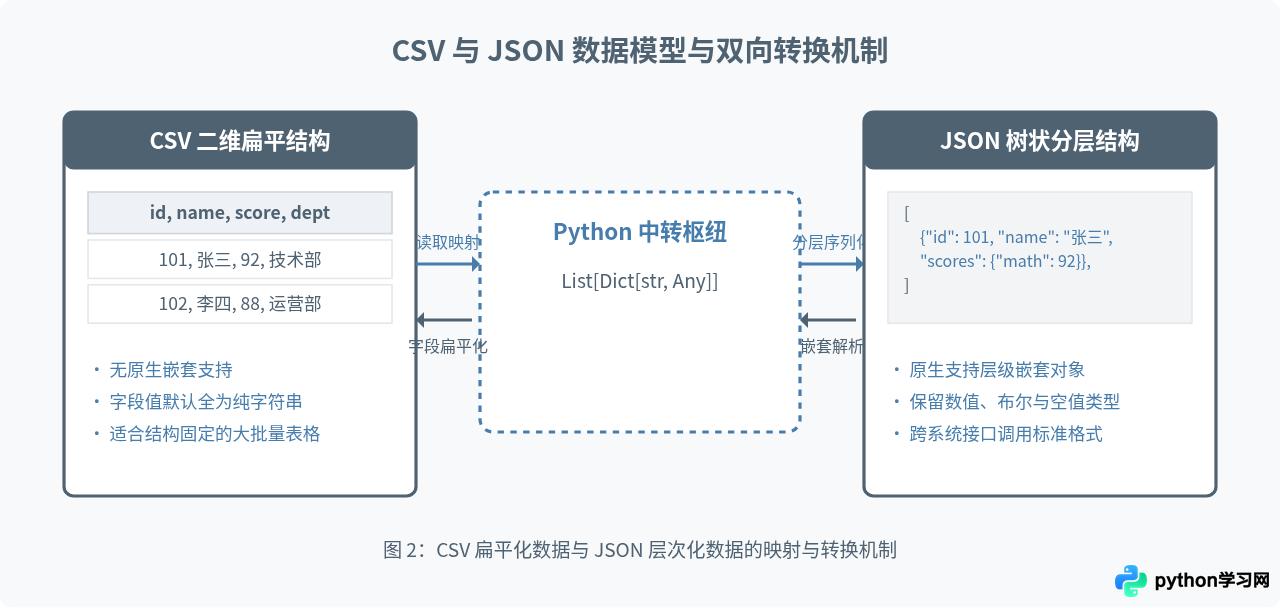
JSON 能够区分整型、浮点型、布尔值与 null,但 CSV 中的所有数据在读取时均为字符串。当从 CSV 转换为 JSON 时,建议进行必要的类型推导(如通过 isdigit() 转换整型)。反过来,如果待序列化的 Python 字典包含 datetime、UUID 或 set,json.dump() 会抛出 TypeError: Object of type ... is not JSON serializable。此时可以通过向 json.dump() 传入 default=str 参数将特殊对象平滑转为字符串。
核心知识点与操作速查总结
在面对不同数据格式与工程需求时,快速选定正确的方法与避坑参数是高效开发的基础。下表系统归纳了 CSV 与 JSON 模块的核心特征:
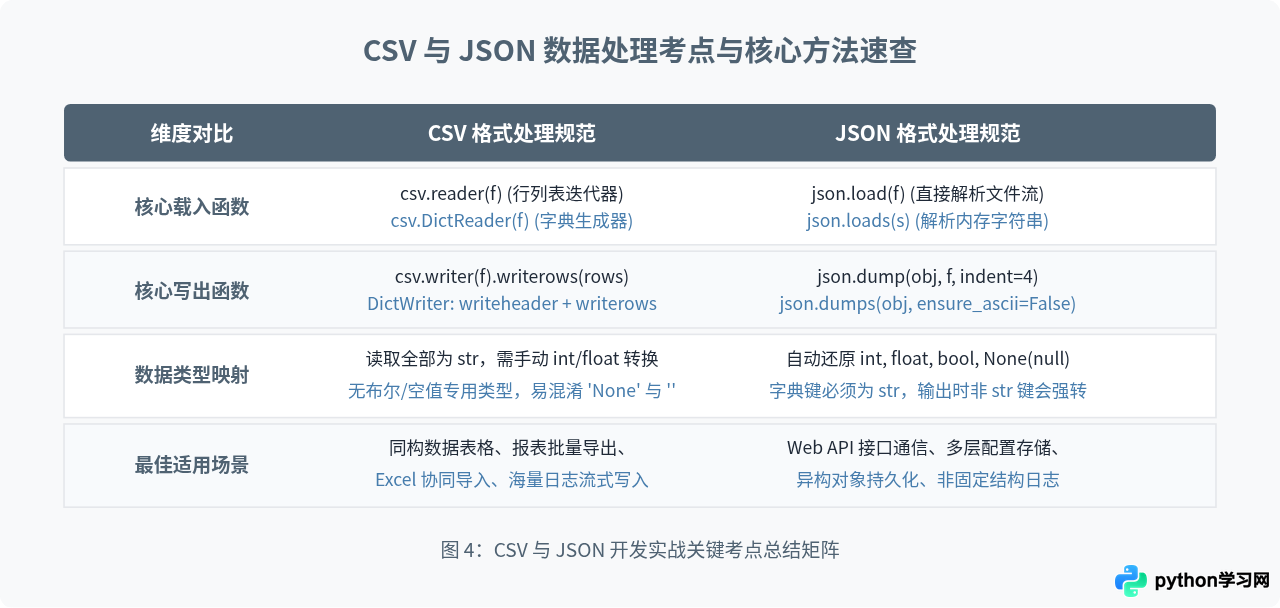
掌握 with open() 上下文协议、严格指定 encoding='utf-8' 与 newline='',并熟练运用 DictReader/DictWriter 以及 json.load()/json.dump() 的进阶参数,能够大幅提升代码在跨平台环境中的稳定性与容错能力。通过上述四个练习题的推导与练习,能够建立清晰的数据读写与清洗工程思维。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















