


Python读写文本文件时怎么处理\n换行和\t缩进
详细讲解Python在读写文本文件时处理\n换行符与\t制表缩进的核心机制、操作方法、常见陷阱与最佳实践。
\n(换行符,ASCII 10)与 \t(制表符,ASCII 9)是最常见的两个转义控制字符。处理换行时的核心要点在于读取时区分通用换行符与去除末尾冗余,以及写入时明确追加时机与平台格式;处理制表缩进的核心要点在于区分对齐展示(空格展开)与结构化数据解析(TSV 字段拆分)。
一、基本认知:字符串转义与文件存储
在 Python 内部,\n 代表换行(Line Feed,LF),\t 代表水平制表符(Horizontal Tabulation)。当我们在代码中编写字符串字面量时,反斜杠后跟特定字母会被解释器解析为单个不可见控制字符:
len("\n")的计算结果是1,而不是 2;它占用一个字节的内存空间。len("\t")的计算结果也是1。- 如果希望字符串保留字面含义的“反斜杠和字母 n”,需要写成
r"\n"(原始字符串)或"\\n"(双反斜杠转义)。
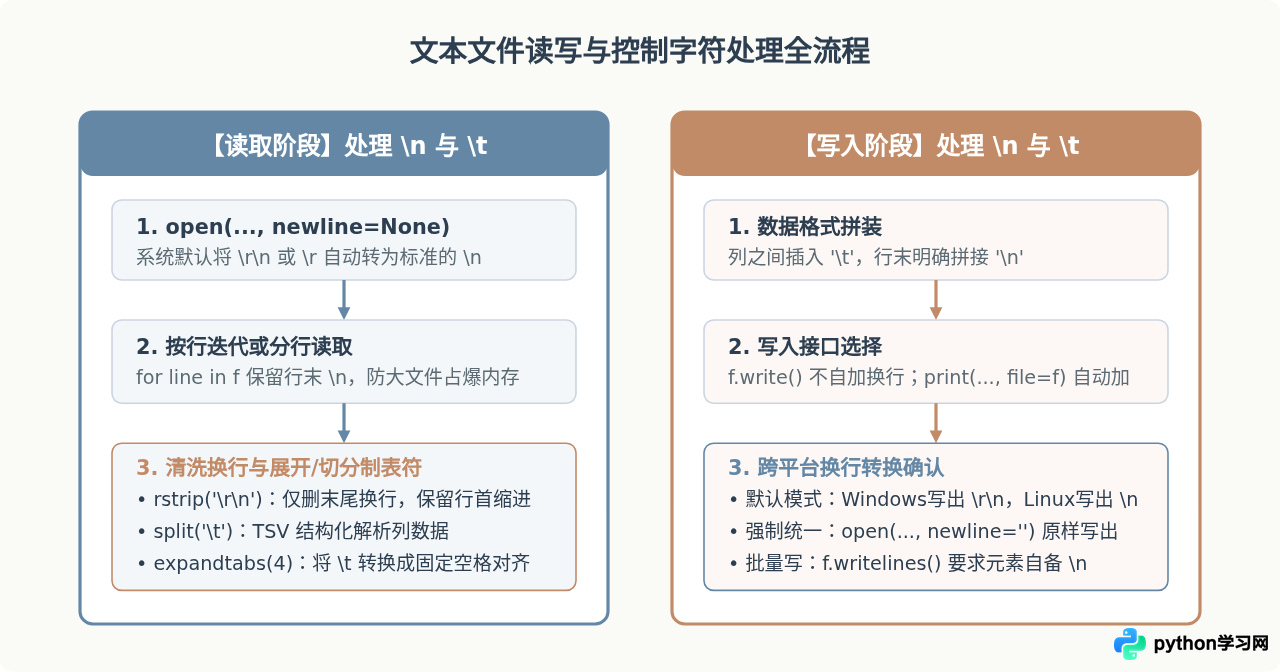
在跨平台操作中,Windows 系统的文本换行标准通常是 \r\n(回车换行,CRLF),而 Linux 与 macOS 系统标准是 \n(LF)。Python 3 默认内置了“通用换行模式”(Universal Newlines),在文本模式读取时会自动将各类系统的换行统统转换映射为内存中的 \n,极大地减轻了开发者的跨平台负担。
二、读取文本文件时处理 \n 换行符
在 Python 中读取文本文件时,最容易遇到的问题是:为什么从文件中读取的每一行打印出来后,中间都多了一个空行?
这是因为无论是调用 f.readline()、f.readlines(),还是使用 for line in f: 逐行遍历,Python 都完整保留了文本行尾部的 \n。而内置函数 print() 默认的 end 参数也是 \n。两个换行相叠加,终端就会呈现出空行效果。
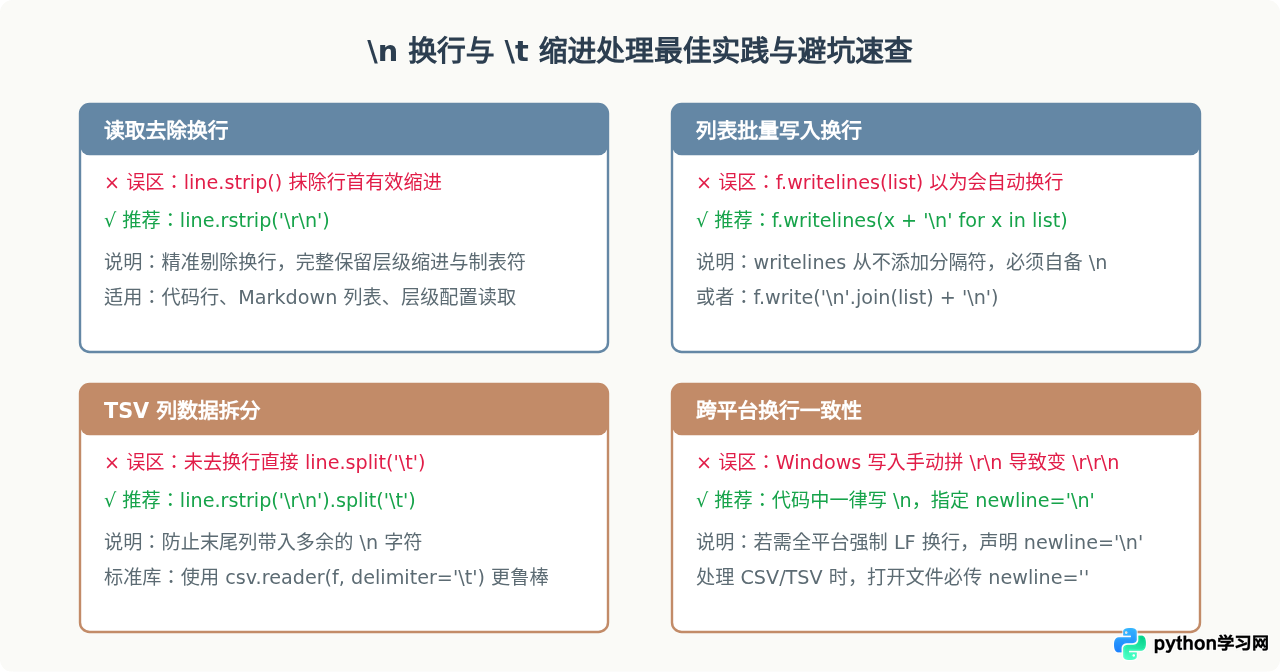
1. 为什么推荐 rstrip('\r\n') 而不是 strip()
许多初学者习惯直接使用 line.strip()。然而在许多应用场景中(例如读取带层级结构的配置文件、代码文件或 Markdown 文件),行首往往包含用于缩进的空格或 \t 制表符。如果调用 strip(),会把行首的前导空白和制表符一并抹除,从而破坏原有格式。
规范的做法是只移除行尾的换行符:
# 正确的做法:只剔除末尾的换行符,完整保留行首的缩进(包含空格或 \t)
with open("data.txt", "r", encoding="utf-8") as f:
    for line in f:
        # 去除行末可能出现的 \r 和 \n
        clean_line = line.rstrip("\r\n")
        print(clean_line)
2. open() 的 newline 参数机制
Python 的内置 open() 函数具有一个关键参数 newline。在读取模式('r')下,它的取值不同会导致不同的转换行为:
newline=None(默认值):启用通用换行模式。输入文件中的\n、\r\n或单独的\r均被转换为内存中的标准\n。newline=''(空字符串):通用换行模式依然生效,但换行符不被替换,而是原样返回给调用者(例如保留 Windows 原生的\r\n)。在配合标准库csv模块使用时,官方文档明确要求传入newline='',以防解析混乱。newline='\n':仅将\n视为行结束符,其他的\r将被当作普通字符读入。
三、写入文本文件时控制 \n 换行符
在向文件写入内容时,开发者需要明确不同写入方法对换行符的处理差异:
1. f.write() 与 print(..., file=f) 的对比
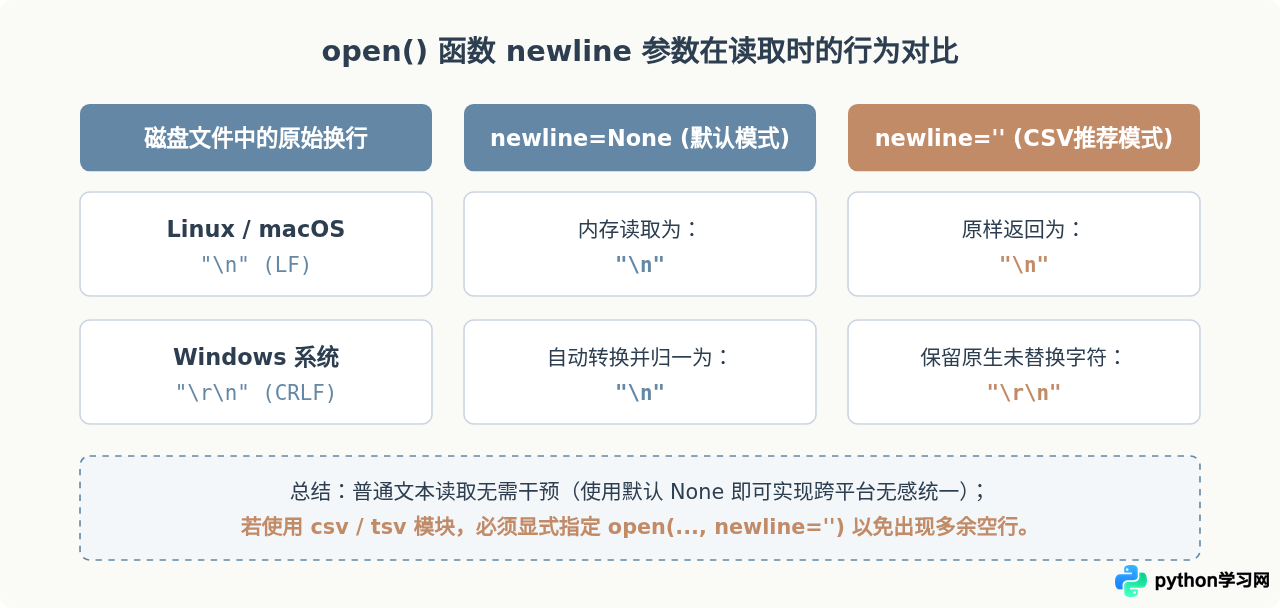
f.write(string):最底层的写入方法,不会自动在结尾添加任何换行。如果希望换行,必须显式在字符串结尾加上\n。print(..., file=f):默认会像在终端打印一样,在内容尾部追加\n(由默认参数end='\n'控制)。如果不需要追加换行,需显式声明end=''。
lines_to_write = ["第一行内容", "第二行内容", "第三行内容"]

# 方式 A:使用 f.write(),必须主动拼接 \n
with open("output_a.txt", "w", encoding="utf-8") as f:
    for item in lines_to_write:
        f.write(item + "\n")

# 方式 B:使用 print(),自动追加换行
with open("output_b.txt", "w", encoding="utf-8") as f:
    for item in lines_to_write:
        print(item, file=f)
2. f.writelines() 的常见误区
很多开发者根据方法名误以为 f.writelines(list) 会在列表的每个元素后自动追加换行,这是极其常见的误解。实际上,writelines() 只是连续将可迭代对象中的字符串写入文件,不会插入任何换行符。如果列表中的元素末尾没有 \n,写出的所有内容将连成一整行。
items = ["apple", "banana", "cherry"]

# 错误写法:写出的文件内容为 "applebananacherry"
with open("wrong.txt", "w", encoding="utf-8") as f:
    f.writelines(items)

# 正确写法 1:预先在列表中添加换行
with open("correct_1.txt", "w", encoding="utf-8") as f:
    f.writelines(item + "\n" for item in items)

# 正确写法 2:使用 join 拼接(适合中小规模数据)
with open("correct_2.txt", "w", encoding="utf-8") as f:
f.write("\n".join(items) + "\n")'w' 模式写入且未指定 newline 时,Python 会自动将你写入的 \n 转换为 \r\n。如果你希望无论在哪个操作系统下写出的文本文件都保持标准的 LF 换行(\n),只需在打开文件时显式声明 open("filename.txt", "w", encoding="utf-8", newline="\n")。
四、处理制表符 \t:展开对齐与 TSV 数据解析
制表符 \t 具有双重身份:在排版和代码中,它代表水平对齐或缩进;在数据处理中,它作为字段分隔符(Tab-Separated Values,TSV)。针对不同的场景,Python 提供了不同的处理方式。
1. 场景一:将制表缩进展开为空格(expandtabs)
不同文本编辑器对制表符的显示宽度存在差异(有的默认 8 空格,有的默认 4 空格),直接使用 \t 容易导致在不同工具中打开时对齐错乱。若需生成视觉上对齐一致的纯文本,可以使用 Python 字符串内置的 expandtabs(tabsize) 方法,将 \t 展开为对应列宽的空格:
content = "Name\tAge\tCity\nAlice\t24\tBeijing\nBob\t30\tShanghai"

# 默认 tabsize=8,这里指定为 4 空格对齐
aligned_content = content.expandtabs(tabsize=4)

with open("aligned.txt", "w", encoding="utf-8") as f:
    f.write(aligned_content)
2. 场景二:解析与写入 TSV(制表符分隔)文件
制表符常用作轻量级表格数据的分隔符。处理此类文件时,可以采用直接拆分或使用标准库 csv 模块:
import csv

# 方式 1:逐行读取并使用 split('\t') 拆分
with open("dataset.tsv", "r", encoding="utf-8") as f:
    for line in f:
        # 先去掉行尾换行,再按制表符分割字段
        fields = line.rstrip("\r\n").split("\t")
        print("解析字段:", fields)

# 方式 2:使用标准库 csv 模块(推荐,能妥善处理带引号或含特殊符号的单元格)
with open("dataset.tsv", "r", encoding="utf-8", newline="") as f:
    reader = csv.reader(f, delimiter="\t")
    for row in reader:
        print("字段列表:", row)

# 写入 TSV 文件
records = [
    ["ID", "Item", "Price"],
    ["101", "Keyboard", "199"],
    ["102", "Mouse", "89"]
]
with open("output.tsv", "w", encoding="utf-8", newline="") as f:
    writer = csv.writer(f, delimiter="\t")
    writer.writerows(records)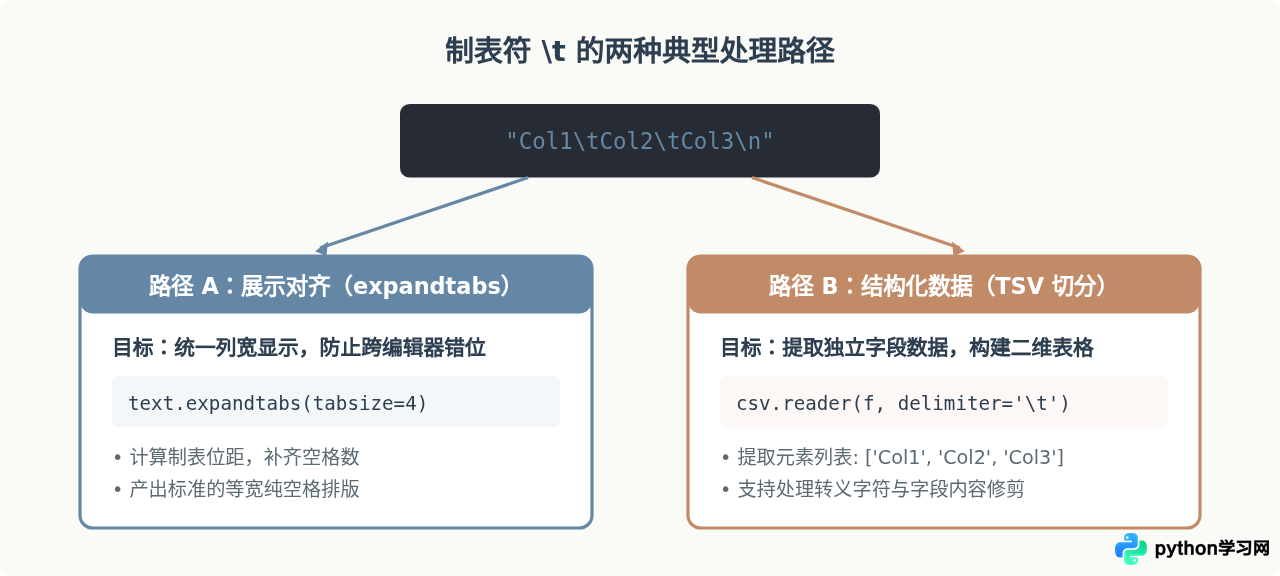
五、核心方法与常见陷阱速查
在实际编码中,处理换行与缩进需要注意以下典型边界情况:
- 严禁在保留层级结构的文本上滥用
strip():strip()会同时删掉行首和行尾的所有空白字符(包括空格和\t)。若文本内容是 Python 代码、YAML 配置或包含层级缩进的文档,行首缩进丢失会导致语法错误。应坚持使用rstrip("\r\n")。 - Windows 平台写文件的
\r\r\n现象:如果在 Windows 上以文本模式写入字符串时已经手动拼装了\r\n,且未设置newline='',Python 的文本包装器会把其中的\n再次转为\r\n,最终变成双回车\r\r\n。统一在内存中只使用\n拼接,交给open()自动转换即可避免此问题。 - 切分字段前必须先去行尾换行:如果直接对
line.split("\t"),最后一列字段会带有\n。务必执行line.rstrip("\r\n").split("\t")。
六、总结
处理 Python 文本文件中的 \n 与 \t,本质上是对字符流边界与显示规范的精确控制。只要遵循以下三条准则,就能彻底杜绝绝大多数相关 Bug:
- 读入时:依赖 Python 的通用换行特性,用
line.rstrip('\r\n')剥离行尾,妥善保护行首缩进。 - 写出时:清楚
write()与writelines()不会自动换行的特性,统一在内存中以\n表达换行,跨平台场景按需配置newline参数。 - 缩进与列对齐:展示排版使用
expandtabs()转为空格,结构化数据使用split('\t')或csv.reader(..., delimiter='\t')进行解析。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















