


Python requests响应内容encoding属性设置与手动解码最佳实践
深入解析Python requests库响应文本乱码的底层机制,详细介绍response.encoding属性显式设置、apparent_encoding推断与基于response.content手动解码的最佳实践。
requests 库请求网页或 API 接口时,中文内容出现乱码并非数据传输损坏,而是字符解码规则不匹配所致。解决这一问题的标准路径分为两类:一是直接为 response.encoding 赋值指定正确编码,让 response.text 内部完成准确转换;二是通过 response.content 提取未经改动的原始字节流,在外部进行可控的手动 decode()。本文将系统阐述其底层运作原理、两种方案的具体实现与工程落地时的选择标准。
一、requests 文本解码的底层运作机制
当执行 response = requests.get(url) 获取 HTTP 响应时,网络通道传回的本质上始终是未经加工的二进制数据(bytes)。requests 提供了两个核心属性来承接响应体:response.content 和 response.text。理解两者的分工是解决所有编码问题的前提。
response.content 存储的是原始字节流,类型为 Python 的 bytes。无论服务端发送的是图片、压缩包还是 HTML 页面,它都保持原样,没有任何转码损耗。
response.text 则是在调用时动态生成的 str 字符串。其内部逻辑相当于执行了 response.content.decode(response.encoding)。在未显式设置时,requests 会自动解析 HTTP 响应头中的 Content-Type 字段(例如 text/html; charset=utf-8)。如果头信息中明确指定了 charset,response.encoding 就会被赋予该字符集。
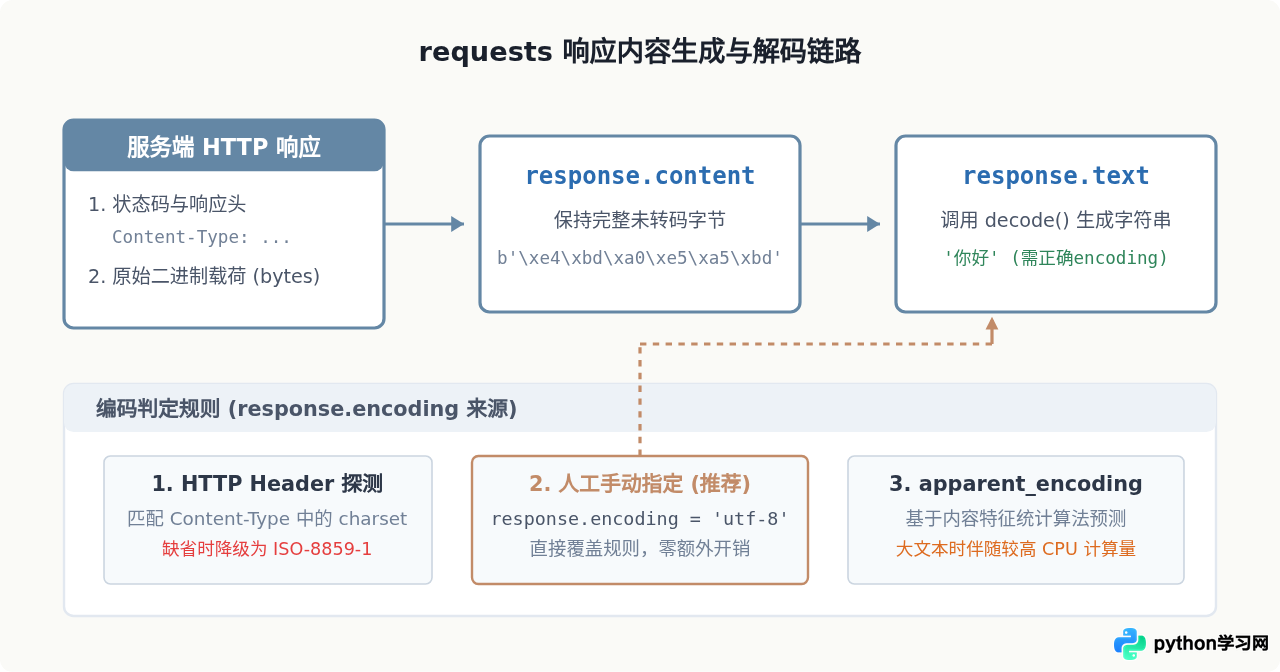
然而,如果响应头中只给出了 text/html 而缺少 charset 参数,requests 遵照早期的 HTTP/1.1 RFC 2616 规范,会默认将 response.encoding 回退设置为 ISO-8859-1(即 Latin-1 单字节编码)。而现代中文网页大多采用多字节的 UTF-8 或 GB18030 编码,用单字节编码强行解释多字节序列,便直接产生了形如 ä½ å¥½ 的典型乱码。
二、乱码成因:HTTP 响应头与文档内声明脱节
大部分中文爬虫开发者遇到的乱码问题,根源在于“协议层头信息”与“内容层标记”之间的信息脱节。
现代 Web 架构中,Web 服务器(如 Nginx、Apache)或 CDN 节点为了简化配置或统一静态资源策略,常将 Content-Type 响应头固定输出为 text/html,并不追加 charset 声明。网页真实的编码信息往往只存在于 HTML 文档头部的 <meta charset="utf-8"> 或 <meta http-equiv="Content-Type" content="text/html; charset=gbk"> 标签内。
作为通用 HTTP 请求客户端,requests 只负责与 HTTP 协议层交互,它既不会也不应该在底层内置一个 HTML 词法分析器去解析文档正文中的标签。因此,requests 只能按照规范将其视作无声明编码,并回退给默认的 ISO-8859-1。
三、方案一:设置 response.encoding 属性
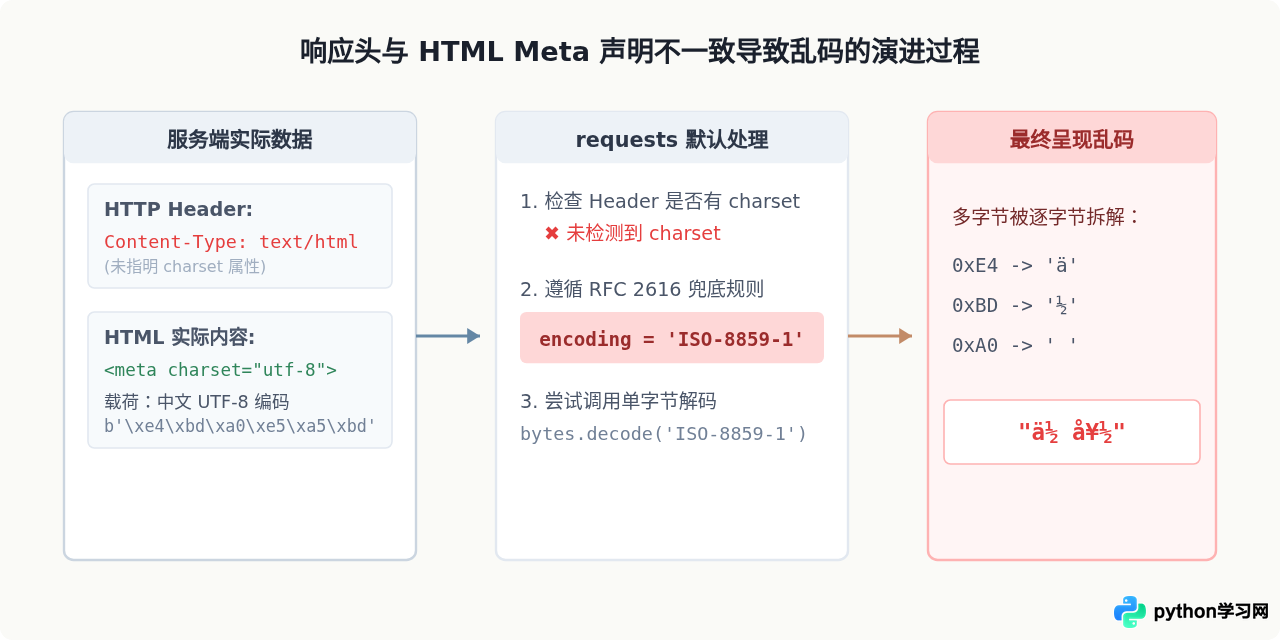
针对 requests 默认编码判定失效的情况,最直接、代码量最少的修复方案就是显式重设 response.encoding。
1. 显式指定已知编码
当明确知道目标站点或接口的编码规范时(绝大部分现代接口为 UTF-8,部分政府或金融传统站点为 GB18030/GBK),可以直接在访问 response.text 前完成赋值:
import requests

url = "https://example.com/chinese-page"
response = requests.get(url, timeout=10)

# 直接显式指定编码
response.encoding = 'utf-8'

# 此时访问 text 属性将按 utf-8 正确解码
print(response.text)gb18030,而非 gb2312 或 gbk。因为 gb18030 是国家强制标准,完全超集兼容 gb2312 与 gbk,能够避免因人名生僻字或繁体字导致的 UnicodeDecodeError。
2. 使用 response.apparent_encoding 自动推断
当抓取的目标网站编码不固定,或需要批量处理未知来源站点时,可以使用 requests 提供的 apparent_encoding 属性:
import requests

response = requests.get("https://unknown-domain.com", timeout=10)

# 利用 charset_normalizer/chardet 算法探测并赋值
response.encoding = response.apparent_encoding
print(response.text)
apparent_encoding 的工作原理是调用内置的字符探测库(在现代 requests 中通常是 charset_normalizer,早期版本为 chardet),扫描响应体的全部字节,根据字符组合的统计学特征推算最可能的编码。
尽管使用便捷,但在实际生产中需要注意其边界代价:
- CPU 性能开销:探测算法需要对字节流进行概率模型计算,如果响应体达到数兆字节(如大批量抓取或长列表页),频繁调用
apparent_encoding会显著降低处理吞吐量。 - 短文本误判风险:当正文中文较短、夹杂较多英文或数字时,特征统计样本不足可能导致误判(例如将
GBK误判为Big5或windows-1252)。
四、方案二:基于 response.content 手动解码
修改 response.encoding 依旧依赖 requests 内部的解码调用。如果需要对解码过程拥有更细粒度的控制(如捕获脏字节、动态解析 meta 标签、使用替代字符等),基于 response.content 原始字节进行手动解码是更为专业的选择。
1. 基础手动解码与容错处理
直接读取 response.content,并调用 Python 原生 bytes.decode() 方法,同时传入合理的 errors 参数来防御脏数据:
import requests

response = requests.get("https://example.com/api", timeout=10)
raw_bytes = response.content

# 方式 A:严格解码(遇到不符合规范的字节序列立即抛出异常)
try:
    content_str = raw_bytes.decode('utf-8')
except UnicodeDecodeError:
    # 降级尝试国内常用编码
    content_str = raw_bytes.decode('gb18030', errors='replace')

# 方式 B:容错替换(将无法识别的坏字节替换为 Unicode 问号字符)
safe_str = raw_bytes.decode('utf-8', errors='replace')
2. 动态提取 HTML Meta 标签编码
对于网页抓取任务,最鲁棒的实践是在原始二进制层提取 HTML 中实际声明的 charset,再使用该编码进行准确解码:
import re
import requests

response = requests.get("https://example.com/legacy-page", timeout=10)
raw_bytes = response.content

# 仅在前 2048 字节中匹配 meta 标签(meta 标签均位于 head 内,无需遍历全文)
head_bytes = raw_bytes[:2048]
meta_match = re.search(rb'<meta[^>]+charset=["\']?([a-zA-Z0-9_-]+)', head_bytes, re.IGNORECASE)

if meta_match:
    encoding = meta_match.group(1).decode('ascii', errors='ignore')
else:
    # 未找到 meta 标签时采用兜底策略
    encoding = response.apparent_encoding or 'utf-8'

# 执行解码
html_text = raw_bytes.decode(encoding, errors='replace')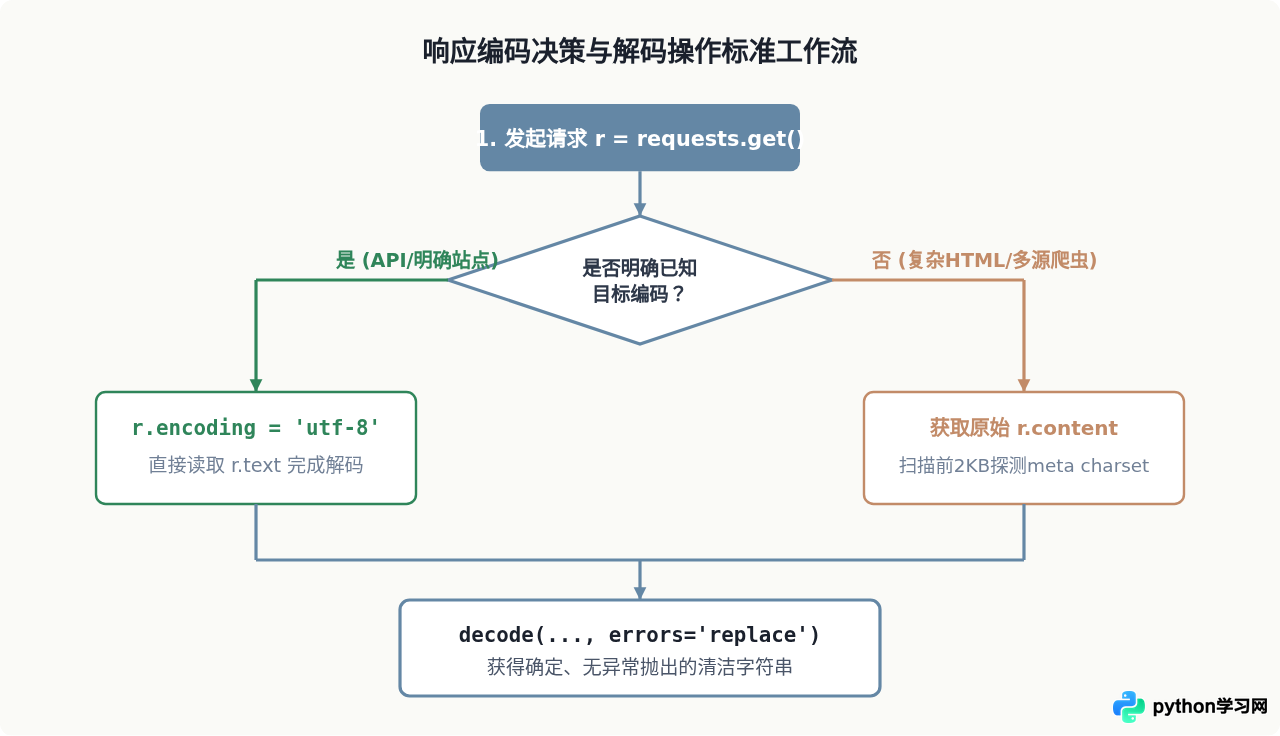
五、工程最佳实践与避坑对比
在实际工程开发与高可用网络数据处理中,应当根据应用类型选择对应策略,同时避开以下常见反模式。
1. 常见反模式:二次转码修复乱码
很多开发者在发现 response.text 乱码后,习惯尝试如下“补救”代码:
# 典型反模式:不要在已经乱码的字符串上做二次修复
bad_text = response.text
fixed_text = bad_text.encode('latin1').decode('utf-8')  # 极易崩溃或丢失字符
这种做法的原理是试图利用 Latin-1 编码将字符串“逆向还原”回原始字节,再重新以 UTF-8 解码。虽然在部分纯 ASCII 加标准扩展字符场景下能够奏效,但在复杂网络环境下极其危险:
- 如果默认解码采用的不是
ISO-8859-1而是某种带有映射替换的编码,原字节在第一次解码时就已经被破坏,不可逆转。 - 字符串可能包含某些在
latin1映射表中不存在的控制字符或未分配码位,直接抛出UnicodeEncodeError。 - 正确做法:只要发现乱码,直接回退到
response.content重新解码,绝不在已损坏的text上做二次编码转换。
2. 与解析库集成时的边界划分
在使用 BeautifulSoup 或 lxml 提取 HTML 数据时,很多代码习惯传入 response.text。这是另一个常见误区。
成熟的 HTML 解析库均内置了基于文档树和 meta 标签的强大编码探测机制。如果将 response.text(已被 requests 按默认编码转过一次)传给 BeautifulSoup,解析库便失去了接触原始字节的机会。
from bs4 import BeautifulSoup
import requests

response = requests.get("https://example.com", timeout=10)

# 正确姿势:直接传入 response.content 二进制字节
# 让 BeautifulSoup 的 UnicodeDammit 机制自动完成最高精度的编码判定
soup = BeautifulSoup(response.content, 'html.parser')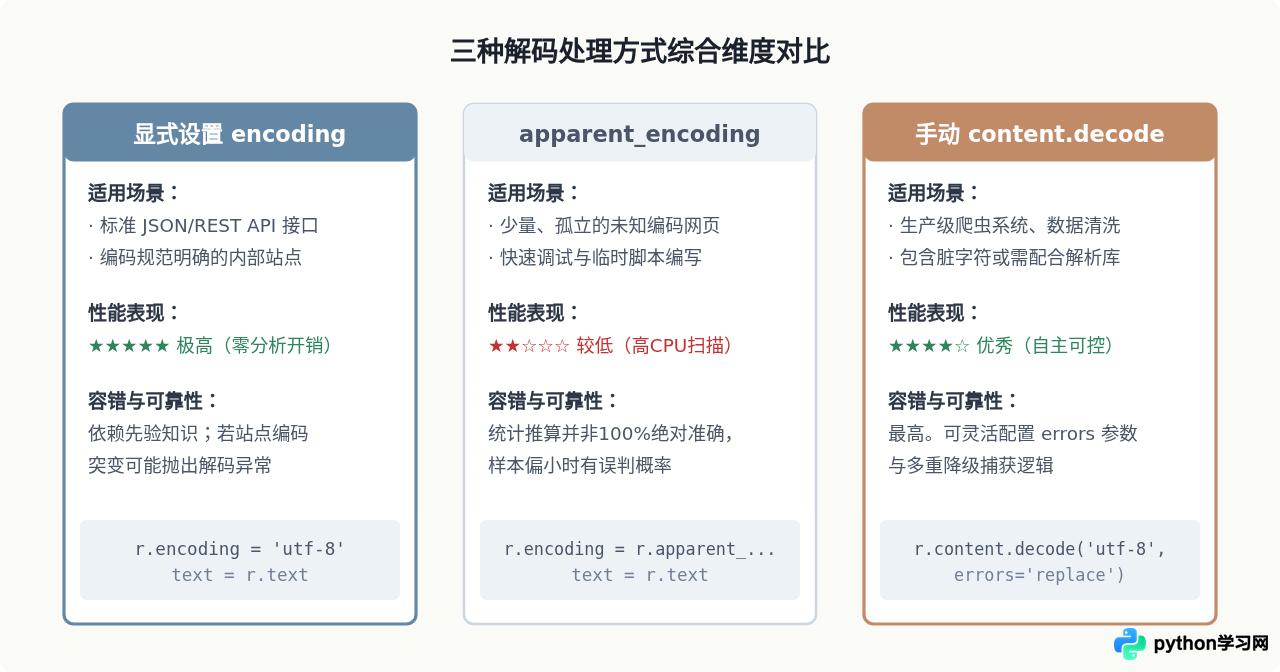
六、总结与实操速查
在实际项目中处理 requests 响应文本时,遵循以下三条准则可确保编码处理兼顾性能与健壮性:
- 已知编码优先指定:针对绝大多数标准 Web API 与现代服务端,请求完成后直接显式执行
response.encoding = 'utf-8',这是性能开销最低且最可信赖的方式。 - 页面抓取直传字节:如果后续使用
BeautifulSoup或lxml进行 HTML 解析,直接向解析器传递response.content,不要提前读取response.text,让解析器内部的成熟机制完成编码探测与转换。 - 未知编码精细控制:需要独立提取文本且面对复杂未知编码时,通过
response.content提取头部字节正则匹配 meta 标签,配合decode(encoding, errors='replace')保证数据管道不会因个别脏字节而中断。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















