


Python enumerate和zip函数怎么配合使用?遍历技巧分享
深入解析 Python 中 enumerate 与 zip 函数配合使用的核心语法、元组解包技巧、常见报错排查及长短序列对齐方案,提供详尽的代码示例与图解。
在 Python 开发中,若需要在同一个循环里同时同步遍历多个列表,并记录当前的迭代序号,将 enumerate() 与 zip() 嵌套使用是最直接、最优雅的实现方式。其核心写法为 for idx, (val1, val2) in enumerate(zip(list1, list2)):。掌握好括号内的元组解包规则与边界截断机制,便能高效应对多序列对齐输出与带编号比对等日常场景。
一、核心机制剖析:两个内置函数各自负责什么?
为了理解两者的配合逻辑,首先需要看清它们各自返回的数据结构:
-
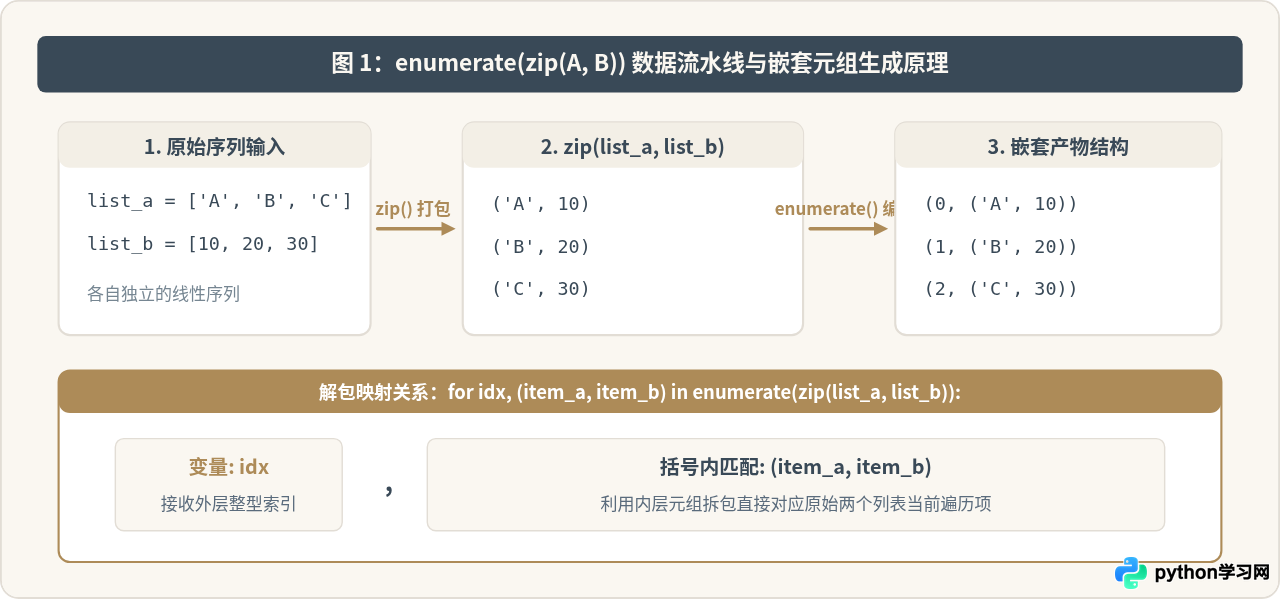
zip(*iterables):接收两个或多个可迭代对象,将其对应位置的元素打包成一个个元组。遍历zip(names, scores)时,每一次循环产出的都是一个两元组(name, score)。 -
enumerate(iterable, start=0):接收一个可迭代对象,将其每个元素与一个递增整数计数器组合,产出形如(index, item)的二元元组。
当把 zip() 的生成结果作为参数传递给 enumerate() 时,enumerate 将 zip 产生的整个子元组视为单一元素 item。因此,最终外层结构输出的是一个嵌套元组:(index, (item_a, item_b, ...))。
二、实操语法与元组拆包防错指南
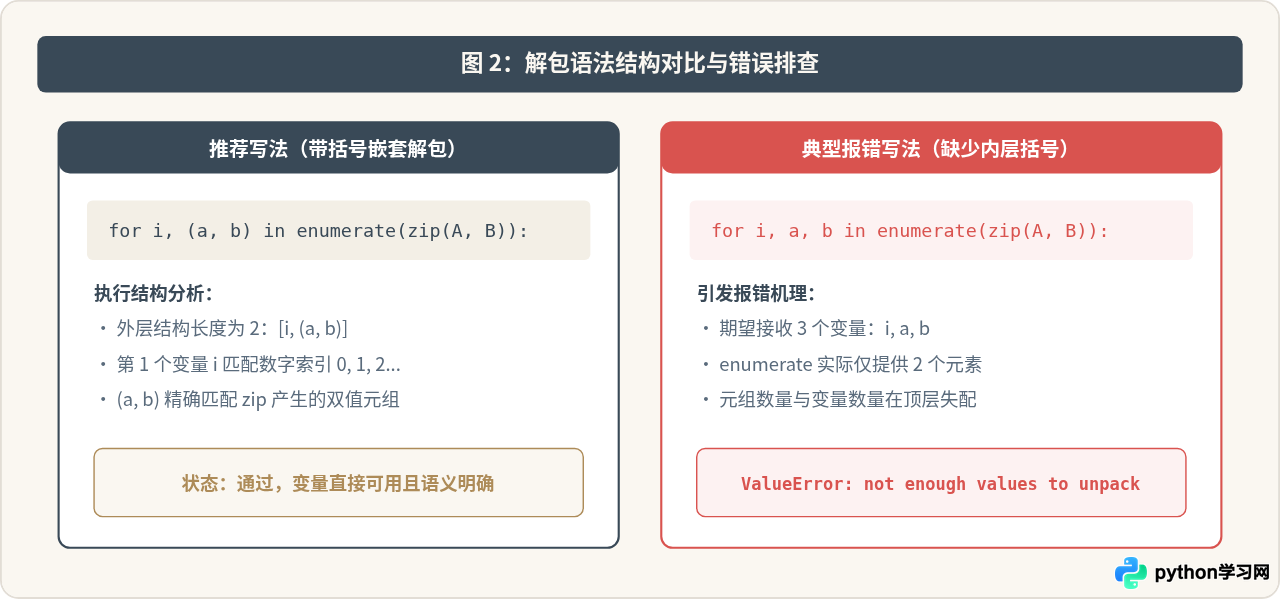
在写 for 循环时,初学者最容易遇到的错误是忘记在内层变量外添加小括号。这是 Python 语法层面的元组解包(Tuple Unpacking)规则决定的。
1. 正确写法:嵌套元组解包
names = ["小明", "小红", "小刚"]
scores = [92, 85, 98]

for i, (name, score) in enumerate(zip(names, scores), start=1):
    print(f"序号 {i}: {name} 的成绩是 {score} 分")
示例输出:
序号 1: 小明 的成绩是 92 分
序号 2: 小红 的成绩是 85 分
序号 3: 小刚 的成绩是 98 分
2. 常见报错:缺少括号引起的解包错误
如果写成 for i, name, score in enumerate(zip(names, scores)):,Python 解释器会尝试用 3 个变量去接收 enumerate 返回的 2 个顶层元素(索引以及由 zip 生成的元组)。此时系统会抛出明确的异常:
ValueError: not enough values to unpack (expected 3, got 2)
反之,若写成 for i, data in enumerate(zip(names, scores)):,程序虽然可以正常运行,但此时 data 会保留为元组 (name, score),后续需要通过 data[0]、data[1] 访问,牺牲了代码的可读性。
三、经典业务场景与代码模式
在实际项目中,enumerate 与 zip 的组合不仅用于输出编号,还在日志对齐、数据一致性校验以及批量生成格式化文本中频繁出现。
场景 1:生成带序列号的对齐报表
products = ["机械键盘", "4K显示器", "人体工学椅"]
prices = [499, 1899, 1200]
stocks = [15, 8, 20]

print(f"{'序号':<6}{'商品名称':<12}{'单价(元)':<10}{'库存':<6}")
print("-" * 34)

# 传入 3 个序列进行多路打包
for idx, (item, price, stock) in enumerate(zip(products, prices, stocks), start=1):
    print(f"{idx:<8}{item:<14}{price:<12}{stock:<6}")
示例输出:
序号    商品名称        单价(元)    库存
----------------------------------
1       机械键盘          499         15
2       4K显示器         1899        8
3       人体工学椅        1200        20
场景 2:数据比对与错误行快速定位
当校验实际预测结果与真实标签时,需要打印出发生预测错误的具体样本序号:
ground_truth = ["cat", "dog", "dog", "bird", "cat"]
predictions  = ["cat", "dog", "cat", "bird", "cat"]

for row_idx, (y_true, y_pred) in enumerate(zip(ground_truth, predictions), start=1):
    if y_true != y_pred:
        print(f"[警告] 第 {row_idx} 行预测不符: 实际为 '{y_true}',模型预测为 '{y_pred}'")
示例输出:
[警告] 第 3 行预测不符: 实际为 'dog',模型预测为 'cat'四、序列不等长处理:zip 截断 vs zip_longest 补齐
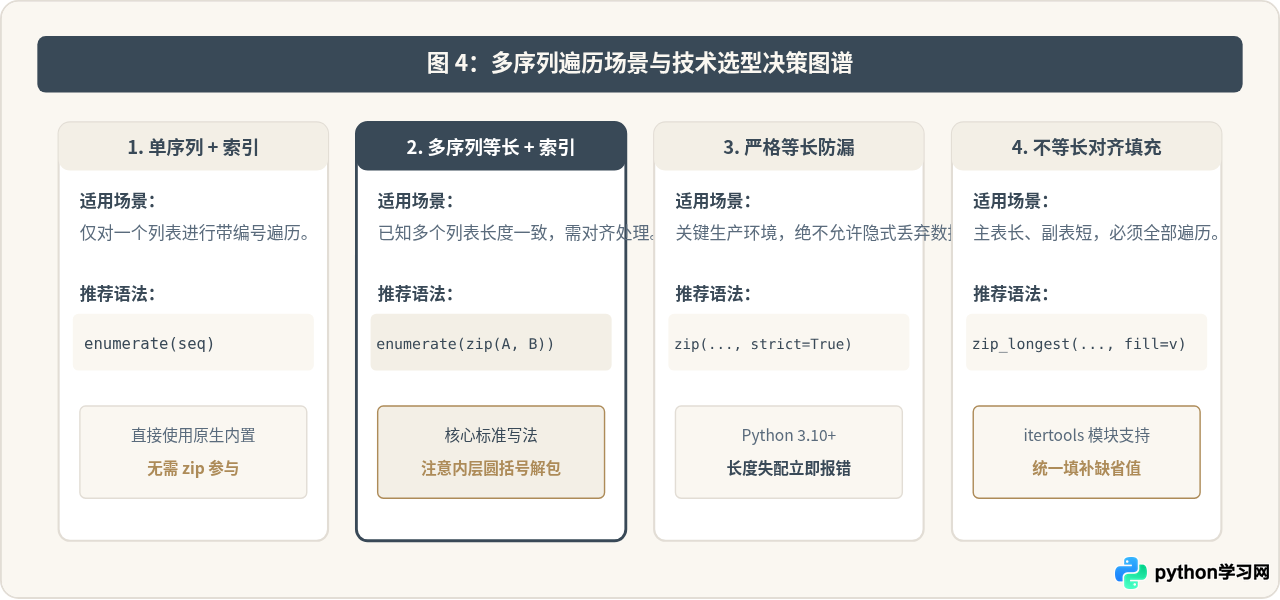
当多个序列长度不一致时,标准的 zip() 函数具有短路截断机制:它会以最短的序列为基准,一旦最短序列耗尽便立即停止循环,超出的元素会被隐式忽略。
zip() 添加参数 strict=True。如果序列长度不匹配,将主动抛出 ValueError。
如果业务需求必须遍历到最长序列,则应引入 itertools.zip_longest,并指定填充缺省值 fillvalue:
from itertools import zip_longest

users = ["Alice", "Bob", "Charlie", "David"]
roles = ["Admin", "Editor"]  # 长度只有 2

for idx, (user, role) in enumerate(zip_longest(users, roles, fillvalue="普通访客"), start=1):
    print(f"用户 #{idx}: {user} - 权限: {role}")
示例输出:
用户 #1: Alice - 权限: Admin
用户 #2: Bob - 权限: Editor
用户 #3: Charlie - 权限: 普通访客
用户 #4: David - 权限: 普通访客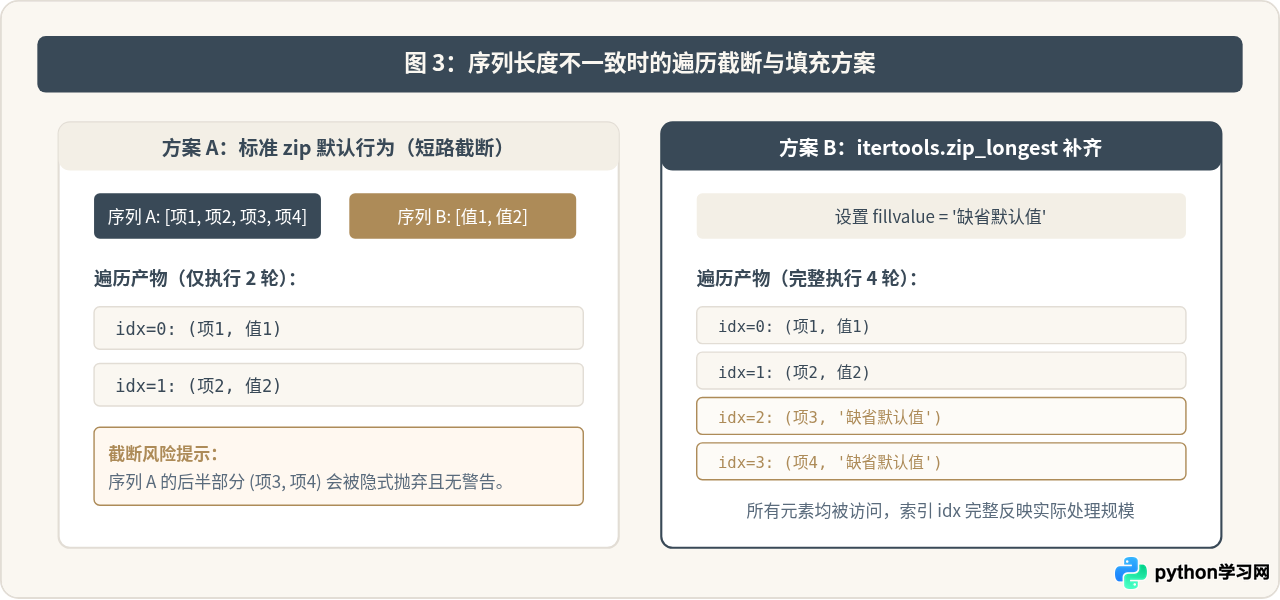
五、技术选型与最佳实践决策
为了在不同场景下写出性能最高、可读性最好的代码,以下流程图梳理了遍历多个序列时的常见技术选型依据:
六、总结与日常编码自查清单
enumerate 和 zip 的搭配使用是 Pythonic 风格的代表性写法,既避免了通过 range(len(...)) 频繁按下标寻址的繁琐与低效,又保证了内存级别的惰性求值特性(两者在迭代过程中均不会一次性生成所有元组到内存中)。
| 检查维度 | 常规做法 | 避坑点与建议 |
|---|---|---|
| 解包语法 | for i, (a, b) in enumerate(zip(A, B)): |
切记内层小括号不可遗漏,否则引发 ValueError。 |
| 起始序号 | enumerate(..., start=1) |
面对需要直观向用户呈现 1-based 编号时,优先使用 start 参数,避免在循环体内额外执行 i + 1。 |
| 序列截断 | 评估源数据是否可能长度不一 | 若要求严格一致可使用 zip(..., strict=True);若需全量保留则使用 zip_longest。 |
| 内存性能 | 直接遍历生成器 | 在海量数据流中,避免在循环前对 zip(...) 显式调用 list(),以充分享受迭代器的常数级空间优势。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















