


新手怎么构建Python数据分析技术栈:核心模块学习路径推荐

针对Python数据分析新手,系统梳理从交互环境Jupyter、数值计算NumPy、表格清洗核心Pandas,到统计可视化Matplotlib与Seaborn的核心模块学习路径与避坑指南。
一、技术栈全景:模块分工与数据流转关系
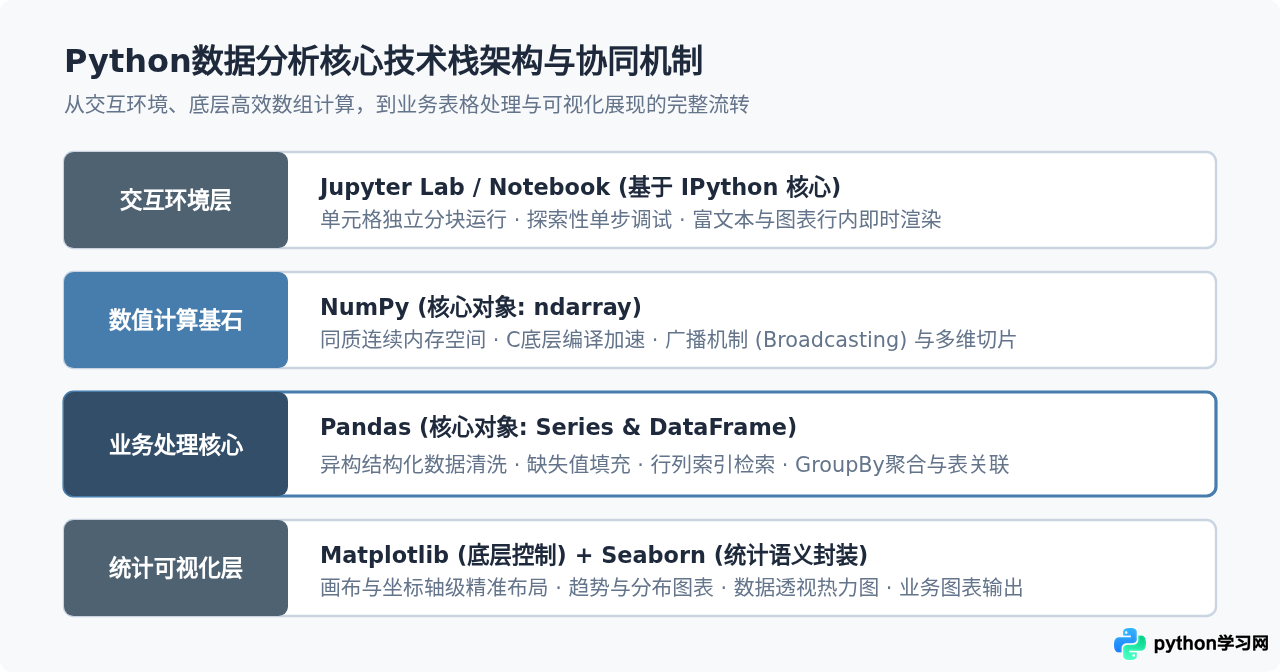
很多初学者在刚接触Python时,容易混淆每个库的具体职责,甚至在不需要的时候引入过重的工具。在真实的数据分析业务场景中,绝大多数任务都是围绕结构化表格展开的。整个技术栈由下至上分为四个清晰的层次:交互环境层、数值计算基石、表格处理核心以及统计可视化展示层。
各模块之间不是孤立存在的,而是遵循着严格的数据依赖与协同机制:Pandas构建在NumPy之上,底层数组运算直接继承了NumPy的高性能;而Matplotlib为Seaborn提供了画布和底层坐标轴对象,Seaborn则直接接收Pandas的DataFrame并完成高阶统计聚合图形的绘制。
二、第一阶段:环境与基础数值计算(Jupyter + NumPy)
开始编写代码前,必须先建立正确的开发习惯。传统后端开发倾向于使用PyCharm或VS Code运行完整的脚本文件,但在数据分析中,每次修改代码如果都要重新读取几百兆甚至几个G的数据文件,会极大地浪费时间。因此,基于单元格运行的Jupyter Lab或Jupyter Notebook是入门的最佳选择。
1. 为什么必须先理解NumPy
NumPy的核心贡献是引入了ndarray(N维数组)。新手常问:既然Python本身有list,为什么还要学NumPy?根本原因在于内存组织与计算效率。Python列表内部存储的是对象的引用指针,各元素在内存中离散分布;而NumPy数组存储的是相同数据类型的连续内存块,并且底层的数学计算由C语言实现,支持SIMD指令加速。
更重要的是,NumPy让开发者摆脱显式的for循环,转而使用“向量化操作(Vectorization)”。例如对一万个数值求平方,向量化语法不仅代码简洁,执行速度通常也是纯Python循环的数十倍到上百倍。
import numpy as np

# 示例:创建数组与向量化广播计算
sales_arr = np.array([120, 240, 310, 180, 520])

# 向量化加税计算(无需写循环遍历)
sales_with_tax = sales_arr * 1.13

# 布尔索引筛选大于200的订单
high_sales = sales_with_tax[sales_with_tax > 250]
print("高额订单(含税):", high_sales)reshape)、切片与布尔掩码检索、以及基本聚合统计函数(mean, std, sum, argmax)。
三、第二阶段:核心工作流与表格清洗主力(Pandas)
如果说NumPy是底层的引擎齿轮,那么Pandas就是数据分析师每天直接打交道的控制台。实际业务中的数据往往是充满缺失值、类型错误和重复项的“脏数据”,Pandas专门为此类结构化二维表格设计。
1. Pandas的两大核心数据结构
- Series:带标签的一维同构数组。可以看作由一组数值与一组对应的索引(Index)绑定的结构。
- DataFrame:带行索引和列标签的二维异构表格。每一列都是一个独立的Series,支持不同列具有不同的数据类型(如字符串、整数、浮点数、时间日期等)。
2. 核心语法模式:数据聚合与指标计算
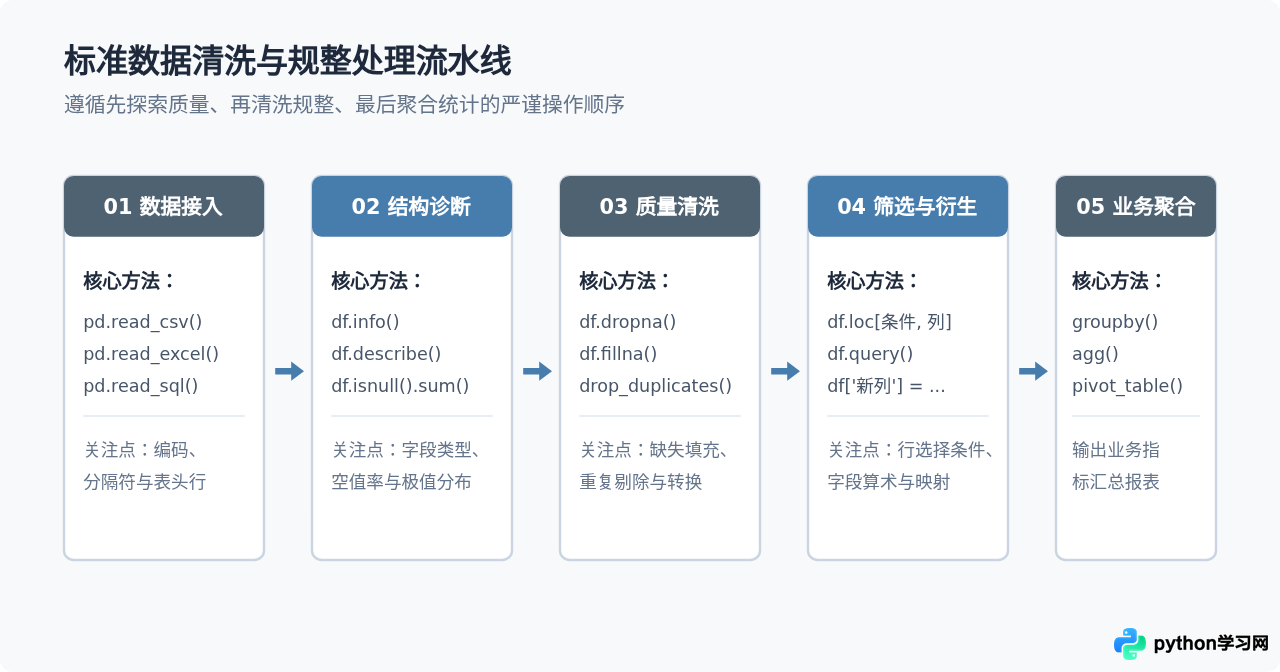
在日常工作中,超过70%的数据统计任务都可以归结为“拆分-应用-合并(Split-Apply-Combine)”模式。在Pandas中,这是通过groupby和agg函数实现的。熟练掌握这一模式,能够直接替代传统电子表格中繁琐的透视表操作:
import pandas as pd

# 读取数据并剔除关键列缺失的无效行
df = pd.read_csv("order_data.csv")
df_clean = df.dropna(subset=["user_id", "pay_amount"]).copy()

# 类型纠偏:将日期字符串转为标准datetime
df_clean["order_date"] = pd.to_datetime(df_clean["order_date"])

# 业务聚合:按地区分组统计销售总额、订单量与客单价
region_summary = df_clean.groupby("region").agg(
    total_sales=("pay_amount", "sum"),
    order_count=("order_id", "nunique"),
    avg_order_value=("pay_amount", "mean")
).reset_index()

print(region_summary)SettingWithCopyWarning警告。这是因为该操作对切片视图还是独立副本存在歧义。解决方法是在切片筛选后明确追加.copy(),显式声明创建独立内存副本,确保后续修改安全。
四、第三阶段:业务探索与统计可视化(Matplotlib + Seaborn)
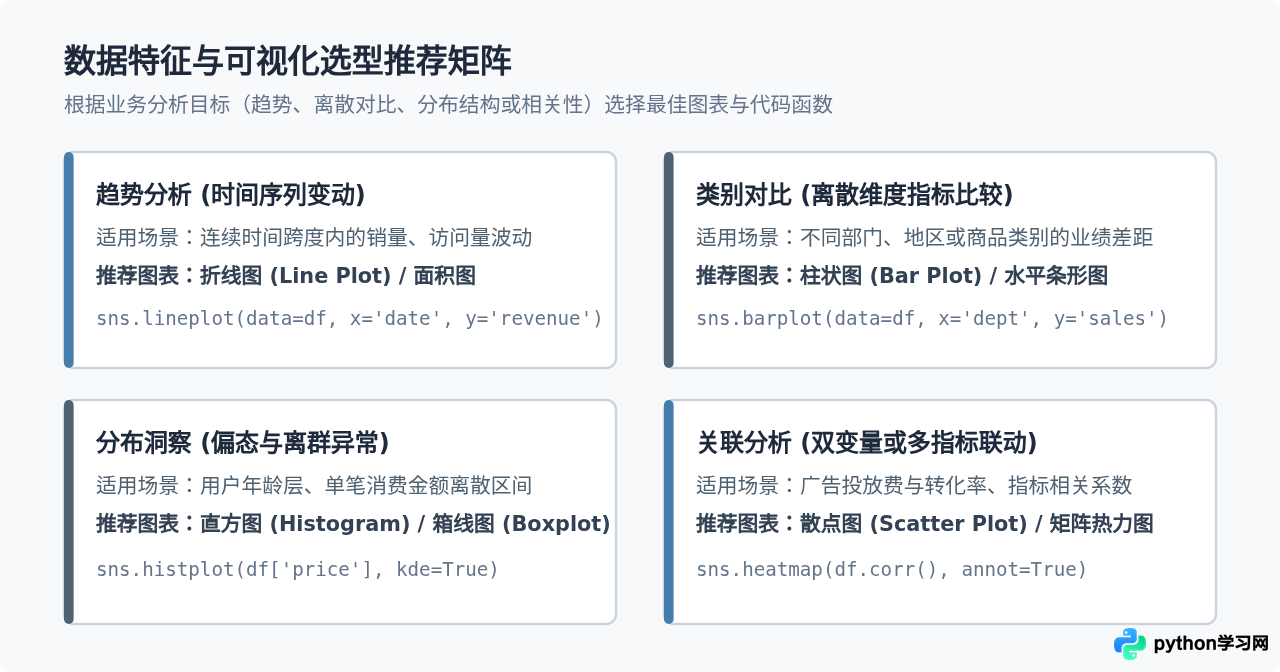
数据清洗完毕后,单纯面对成千上万行的数字表格很难直接发现业务规律。可视化承担着两个核心任务:在分析阶段帮助分析师探索数据分布与异常(EDA),在交付阶段将分析结论直观呈现给业务决策方。
1. 底层控制与高层封装的分工
初学者常常困惑到底学Matplotlib还是Seaborn。结论很明确:以Seaborn做统计表达,以Matplotlib做画布修饰。
- Matplotlib:是Python生态的绘图底层标准。采用面向对象API,由Figure(画布)与Axes(子图坐标轴)构成。它的优势在于像素级的控制能力——每一个刻度标签、边框、文字注释都可以精准调整,但直接手绘统计图形代码冗长。
- Seaborn:建立在Matplotlib之上,对Pandas的DataFrame做了深度语义绑定。你只需要指定
data=df、x='category'、y='sales',它会自动计算均值、置信区间或频率直方。
五、第四阶段:学习进阶路径与能力自测清单
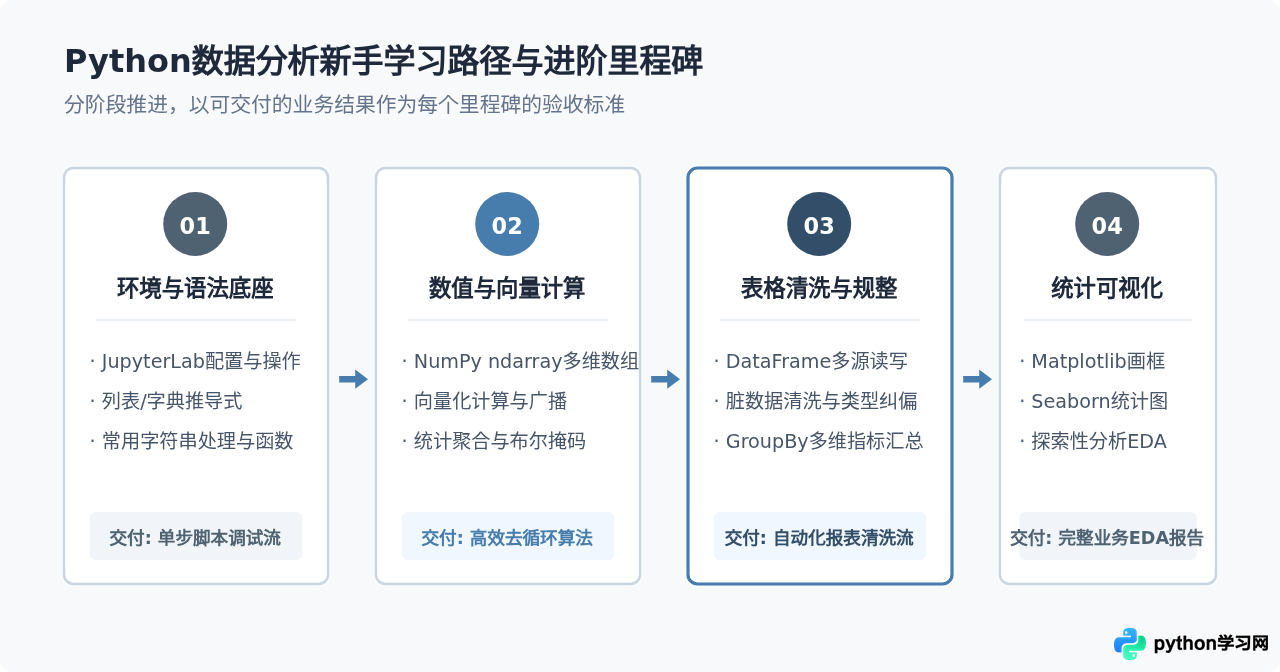
构建技术栈最忌讳“平均用力”。数据分析的本质是解决业务问题,而不是把每一个库的冷门语法全部背下来。建议按照四个阶段循序渐进,每个阶段设立明确的交付物来检验掌握情况。
| 学习阶段 | 核心模块 | 建议周期 | 核心考核输出物 |
|---|---|---|---|
| 阶段一:环境与语法基础 | Jupyter + Python 容器 | 1 - 2 周 | 熟练运用列表/字典推导式,在Jupyter中完成单步排查与快捷键操作 |
| 阶段二:底层数组与思维转换 | NumPy (ndarray) | 1 周 | 用向量化切片与广播代替显式for循环,理解多维数组变形与统计 |
| 阶段三:业务表格清洗主力 | Pandas (Series/DF) | 2 - 3 周 | 能够独立读取脏数据,完成空值填充、字段变换与多条件GroupBy统计 |
| 阶段四:可视化与EDA闭环 | Matplotlib + Seaborn | 1 - 2 周 | 结合真实业务数据集产出一份图文并茂的探索性数据分析(EDA)报告 |
六、新手应避免的技术栈扩展陷阱
很多新手在核心四件套尚未熟练时,容易急于涉足高级主题,导致精力分散、挫败感强烈。在技术栈成型阶段,明确“什么暂时不用学”与“学什么”同样重要:
- 不要过早扎入复杂的机器学习算法库(如Scikit-Learn或PyTorch):在真实的商业分析中,80%以上的业务需求靠准确的数据清洗、合理的指标定义和清晰的统计对比即可解决。过早把精力放在调参或黑盒模型上,往往会忽略最基础的数据质量问题。
- 暂缓分布式大数据框架(如PySpark):单机环境下的Pandas可以轻松承载数百万行以内的数据。在没有触及内存瓶颈或真实分布式集群环境之前,不必过早增加学习分布式调优的认知负荷。
- 先掌握静态图表,再考虑交互式可视化库(如Plotly/ECharts):交互图表虽然效果酷炫,但代码配置复杂度较高。先用Matplotlib与Seaborn理清坐标轴、图例与统计语义,建立良好的图表表达习惯,之后迁移到任何交互库都会轻而易举。
坚持以真实业务数据集为驱动,遵循“加载数据 -> 探索与清洗 -> 指标聚合 -> 业务图表输出”的正向闭环,才能在最短的时间内建立扎实且具备实战价值的Python数据分析技术栈。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















