


Python数据分析入门:零基础学习路径与核心库概览
针对零基础学习者的Python数据分析入门指南,提供清晰的四阶段学习路径,并深入解析NumPy、Pandas、Matplotlib及Seaborn等核心库的功能、核心对象与协作工作流。
零基础学习Python数据分析,核心在于避开“先精通全部Python语法再做分析”的误区,直接聚焦数据处理所需的语法子集与四大核心库。本文梳理了一条明确的四阶段学习路径,并深入解析NumPy、Pandas、Matplotlib与Seaborn的核心对象与协作工作流,帮助初学者建立扎实的数据分析技能体系。
一、零基础四阶段学习路径
数据分析的核心任务是提取数据价值、发现数据规律并支持业务决策,而不是编写高并发底层系统或大型桌面程序。因此,零基础学习者的精力应当精准分配在与数据流转直接相关的环节上。
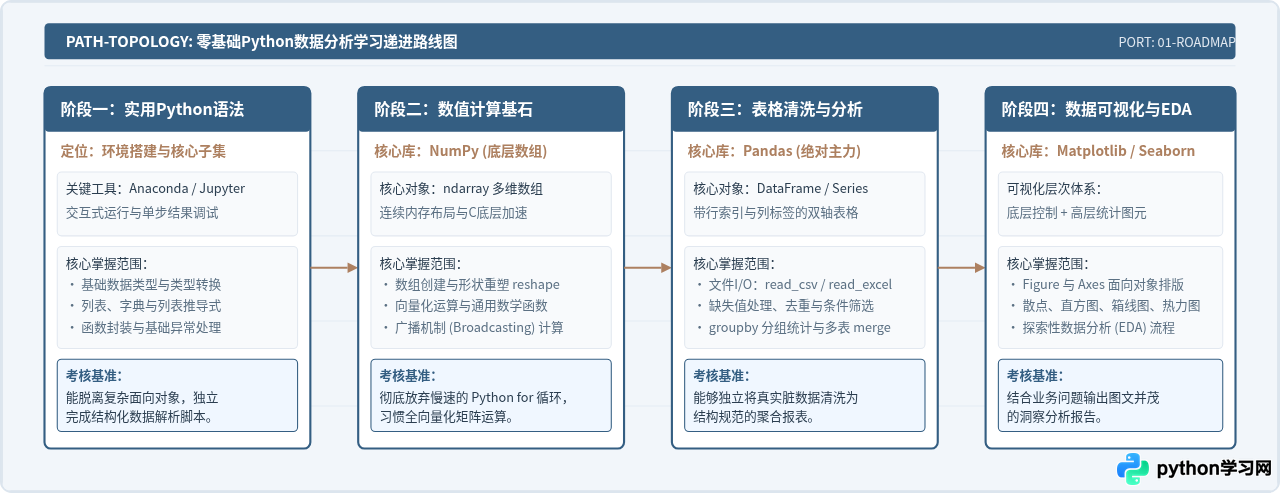
学习各阶段的具体任务和要求如下:
- 阶段一:实用Python语法子集
安装集成发行版 Anaconda,使用 Jupyter Notebook 或 JupyterLab 作为主力开发环境。初学者无需深入元类、装饰器、多线程并发等复杂工程语法,重点掌握:数字与字符串操作、列表与字典的增删改查、列表推导式、函数的定义与参数传递,以及try...except异常捕获机制。 - 阶段二:数值计算与数组思维(NumPy)
建立同构多维数组(ndarray)的概念。理解为什么连续存储能带来百倍于原生列表的执行速度,掌握切片与掩码索引(Boolean Indexing),并熟练运用广播机制消除不必要的循环嵌套。 - 阶段三:表格数据清洗与结构化分析(Pandas)
这是数据分析工作中使用频率最高的一环。熟练使用Series(单维带索引序列)和DataFrame(二维表格),掌握缺失值识别与填充、列类型修正、分组聚合(groupby)和关联多表合并(merge)。 - 阶段四:数据可视化与探索性分析(Matplotlib & Seaborn)
掌握“图表是数据分析思考的外显形式”这一认知。理解 Matplotlib 的画布与坐标轴结构,使用 Seaborn 快速绘制单变量分布、双变量相关性矩阵以及分类对比箱线图,掌握完整的探索性数据分析(EDA)方法。
二、核心库协作架构与职责划分
Python数据分析生态并非单打独斗,而是建立在分工明确的分层架构之上。了解各个库在技术栈中所处的位置,有助于在遇到具体问题时准确挑选最合适的工具。
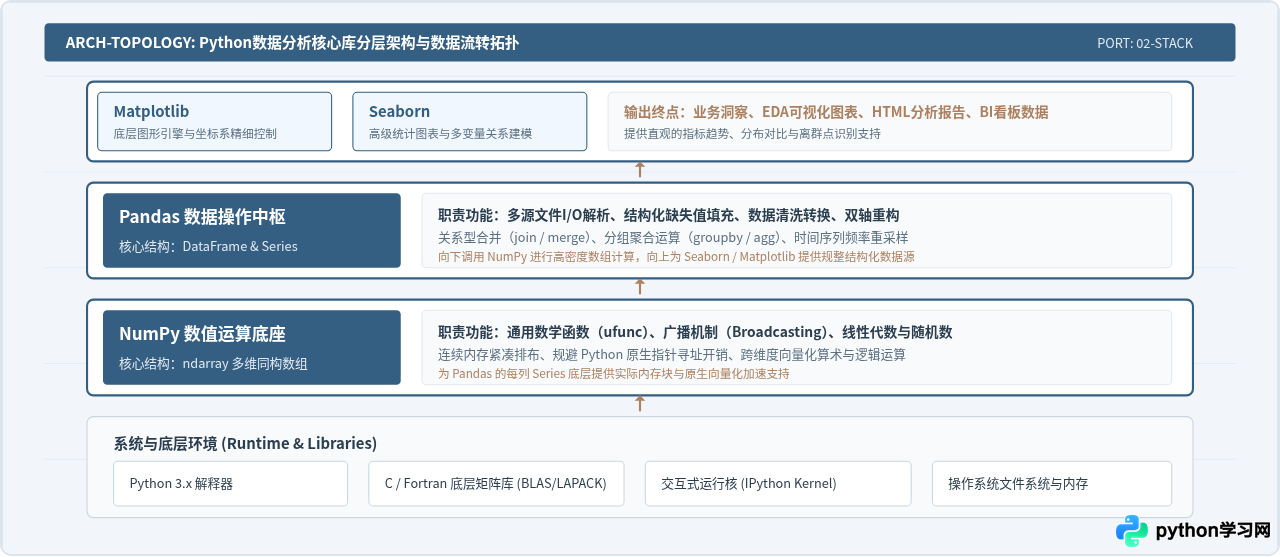
从架构图可以看出,各库之间的协作关系非常清晰:
- NumPy是底层数值计算基石:它通过 C 语言编写的高性能底层代码,管理连续内存块,让高维度矩阵计算免于原生 Python 循环的性能拖累。
- Pandas是业务数据处理中心:它以 NumPy 的
ndarray为底层支撑,在其上封装了带有索引和列名的二维表格DataFrame,负责异构字段管理、数据清洗、多表连接与透视统计。 - Matplotlib与Seaborn是表现层:Matplotlib 负责图表的底图构建、轴刻度调整与细粒度渲染,Seaborn 则在 Matplotlib 基础之上进一步简化统计图表(如相关性热力图、分布图)的生成代码。
三、核心库基础概念与典型实操示例
1. NumPy:多维数组与向量化操作
在原生Python中处理大批量数值时,使用 for 循环逐个计算效率极低。NumPy 通过 ndarray 对象实现同类型数据的紧凑存储,并引入向量化运算机制,让公式直接作用于整个数组。
import numpy as np

# 1. 创建一维与二维 ndarray 数组
arr_1d = np.array([10, 20, 30, 40, 50])
matrix = np.array([[1, 2, 3], [4, 5, 6]])

# 2. 向量化运算(无需遍历,直接进行标量与矩阵算术运算)
normalized_matrix = (matrix - np.mean(matrix)) / np.std(matrix)

# 3. 布尔索引切片(筛选符合特定条件的元素)
mask = arr_1d > 25
filtered_result = arr_1d[mask]

print("布尔过滤结果示例:", filtered_result)
# 示例输出: [30 40 50]当两个数组的形状不同时,NumPy 会根据特定规则在虚拟维度上“扩展”较小的数组,使其与较大数组的维度兼容,而无需在内存中实际复制数据。这使得矩阵与标量、矩阵与列向量之间的加减乘除能够以极高速度直接执行。
2. Pandas:结构化数据清洗与统计分析
Pandas 为真实世界中带有表头、不同列数据类型(如数字、文本、日期)的异构数据提供了最理想的数据容器:DataFrame。日常数据分析工作中超过 70% 的时间都在使用 Pandas 处理数据。
import pandas as pd

# 1. 构建示例分析数据集
data = {
    'user_id': [1001, 1002, 1003, 1004, 1005],
    'city': ['北京', '上海', '北京', '深圳', '上海'],
    'order_amount': [120.5, 340.0, None, 210.0, 580.5],
    'order_count': [2, 5, 1, 3, 6]
}
df = pd.DataFrame(data)

# 2. 数据清洗:识别并填充缺失值
df['order_amount'] = df['order_amount'].fillna(df['order_amount'].median())

# 3. 特征衍生:计算客单价
df['avg_price'] = df['order_amount'] / df['order_count']

# 4. 分组聚合统计:统计每个城市的订单总量与平均客单价
city_summary = df.groupby('city').agg(
    total_revenue=('order_amount', 'sum'),
    mean_avg_price=('avg_price', 'mean')
).reset_index()

print("城市分组聚合报表示例:")
print(city_summary)
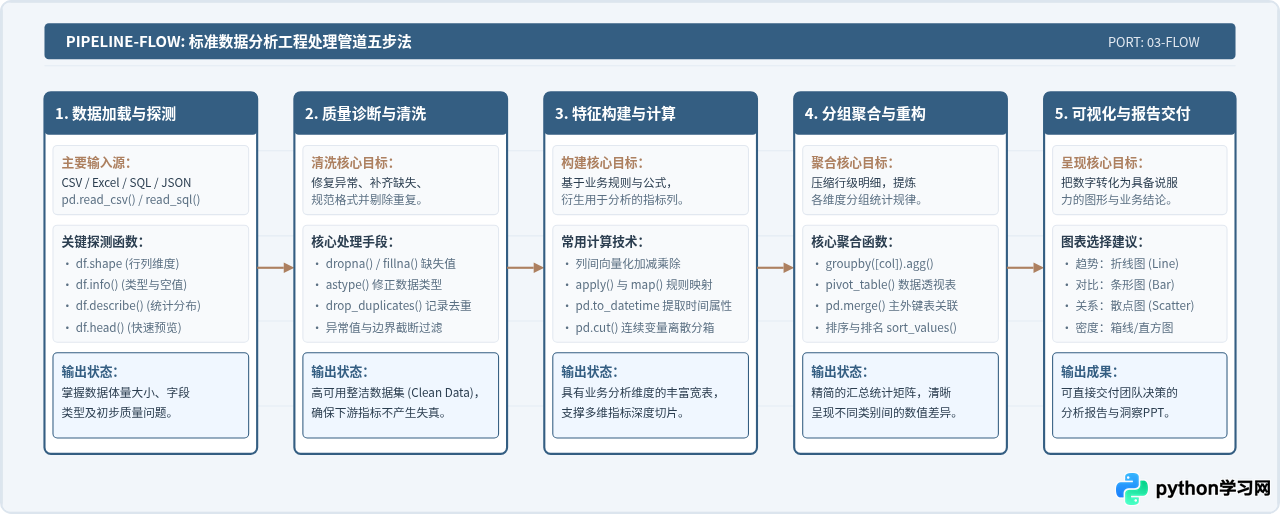
3. 数据分析标准处理管道(Data Pipeline)
将 NumPy 与 Pandas 结合后,常规的数据分析工作流程可以高度抽象为一个五步连贯的处理管道:
4. Matplotlib 与 Seaborn:面向对象绘图与统计表现
Matplotlib 提供了极具控制力的绘图接口,而 Seaborn 则针对统计场景做了高级封装。推荐零基础学员从一开始就使用面向对象接口(Object-Oriented API),避免在复杂的图表排版中混淆状态。
import matplotlib.pyplot as plt
import seaborn as sns

# 推荐规范:明确创建 Figure 画布与 Axes 坐标轴
fig, ax = plt.subplots(figsize=(8, 4.5), dpi=100)

# 使用 Seaborn 绑定数据源并在指定的 ax 上渲染图表
sns.barplot(
    data=city_summary,
    x='city',
    y='total_revenue',
    palette='Blues_d',
    ax=ax
)

# 通过 Axes 对象精确配置细节
ax.set_title('各城市订单总销售额分布', fontsize=14, fontweight='bold', pad=12)
ax.set_xlabel('城市划分', fontsize=12)
ax.set_ylabel('销售总额 (元)', fontsize=12)
ax.grid(axis='y', linestyle='--', alpha=0.7)

# 调整布局并导出高清图表
plt.tight_layout()
# plt.savefig('sales_distribution.png')
plt.show()
四、核心库选型速查与易错规避
在面对具体需求时,选择哪个库、使用哪种数据对象最为高效?以下矩阵对比了各个核心库的关键特性与适用场景:
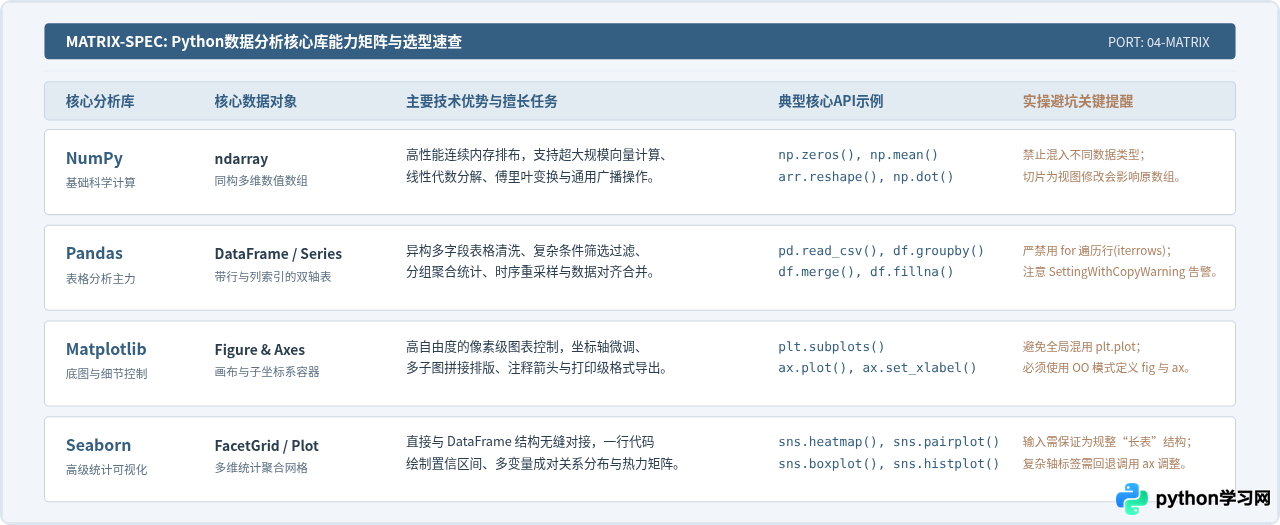
初学阶段三大高频误区及规避方案
- 误区一:试图背诵所有库的所有参数
解决方式:掌握核心概念(切片、索引、分组、聚合)比死记 API 更重要。实际工作中,熟练运用df.info()、Jupyter 的Shift + Tab自动提示以及官方 Cheatsheet 快速查阅才是正确的常态。 - 误区二:在 Pandas 中使用
for循环按行迭代
解决方式:在处理数十万行数据时,使用for row in df.iterrows()会比内置向量化运算慢几十倍甚至上百倍。应优先使用列间运算符,或者采用df['col'].map()与np.select()实现条件赋值。 - 误区三:忽略数据类型(dtypes)导致计算偏差
解决方式:从 CSV 文件导入数据后,务必先通过df.dtypes检查字段类型。日期若被当作纯字符串处理将无法进行时序重采样,带有货币符号的数字字段需要先清洗并转为浮点数(astype(float)),否则会导致聚合求和变为字符串拼接。
五、入门总结与后续实战建议
Python数据分析的学习绝不是死记硬背语法,而是一个“带着问题寻找数据,通过清洗还原真实,借助图表验证推论”的实践过程。
完成四阶段的学习后,建议初学者不要停留在书本示例上,而是直接挑选一个感兴趣的公开数据集(例如经典电商销售流水、城市共享单车骑行记录或公开气象监测数据),从零开始执行“数据导入 → 质量探测 → 缺失清洗 → 指标聚合 → 绘制图表”的完整闭环。在实战中加深对 NumPy 数组计算、Pandas 表格变换以及 Matplotlib/Seaborn 图表呈现的理解,快速成长为能够独立解决实际业务问题的数据分析者。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















