


自学Python三个月能达到什么水平
客观分析自学Python三个月通常能达到的技术水平与能力边界,包含知识掌握程度、能够独立完成的实际项目、常见瓶颈及后续进阶建议。
如果每天保持1.5至2小时的规律学习与动手练习,自学Python三个月(累计有效投入约120至150小时),绝大多数人能够掌握语言的核心基础语法与常用数据结构,并能熟练调用常用第三方库编写100到300行左右的实用脚本。在具体应用上,你可以独立实现日常文件的批量整理、Excel表格数据自动汇总清洗、公开静态网页信息的采集,以及轻量级业务小工具的开发。但从专业技术标准来看,这一阶段通常难以达到全职软件开发工程师、复杂高并发后端架构师或专业算法工程师的任职水平。三个月的关键蜕变在于突破了“看懂语法却写不出代码”的门槛,具备了使用代码解决日常现实问题的实践能力。
一、三个月能力画像:能做什么与难以企及的边界
评估自学三个月的成果,首要前提是厘清“脚本工具开发”与“工业级软件工程”的差异。在三个月周期内,自学者构建的多为单文件、单一目标的自动化脚本,这类程序注重解决具体的输入与输出问题。而在软件公司中,企业级项目涉及数据库事务管理、微服务架构、容器化部署、自动化测试和团队协同规范,这些内容无法在百余小时内全面掌握。
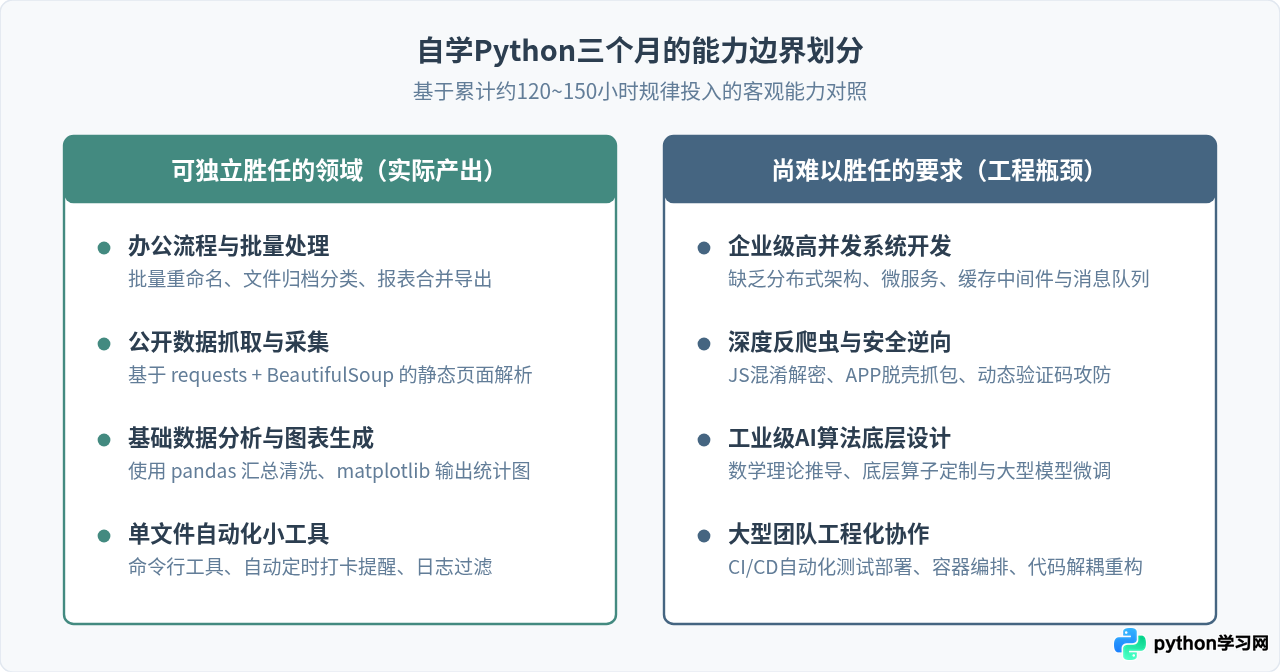
具体而言,三个月自学者所具备的真实能力与尚未达到的专业边界如下:
- 日常办公与文件自动化(完全胜任):能够使用内置模块
os、pathlib遍历磁盘目录,根据命名规则批量重命名文件;使用openpyxl或pandas读取多个杂乱的表格文件,按条件筛选数据后生成统一的汇总报表;或者将格式规整的文本自动写入文档,免除繁琐的手工重复劳动。 - 轻量级网络数据采集(基本胜任):能够使用
requests发起HTTP请求获取网页源码,结合BeautifulSoup或正则表达式提取公开列表中的文本、价格或链接,并将数据存为CSV或JSON文件。对于无复杂验证码、无严格反爬机制的公开数据源,能够独立编写爬虫脚本。 - 基础数据清洗与可视化(基本胜任):掌握
pandas的常用操作(缺失值填充、分组求和、数据透视表构建),并能结合matplotlib绘制清晰的折线图、柱状图或散点图,直观展示业务数据走势。 - 专业软件开发工程(尚未具备):缺乏大型Web框架(如Django、FastAPI)的深层机制理解,不熟悉异步I/O(
asyncio)、数据库连接池配置、高并发锁机制、缓存中间件(如Redis)及Docker容器化运维。 - 算法与机器学习研发(尚未具备):虽然能调用现成算法库运行模型,但对底层数学推导、特征工程调优以及大规模分布式计算缺乏深层积累,无法承担专业算法工程师的研发任务。
二、三个月的学习路径与阶段性里程碑
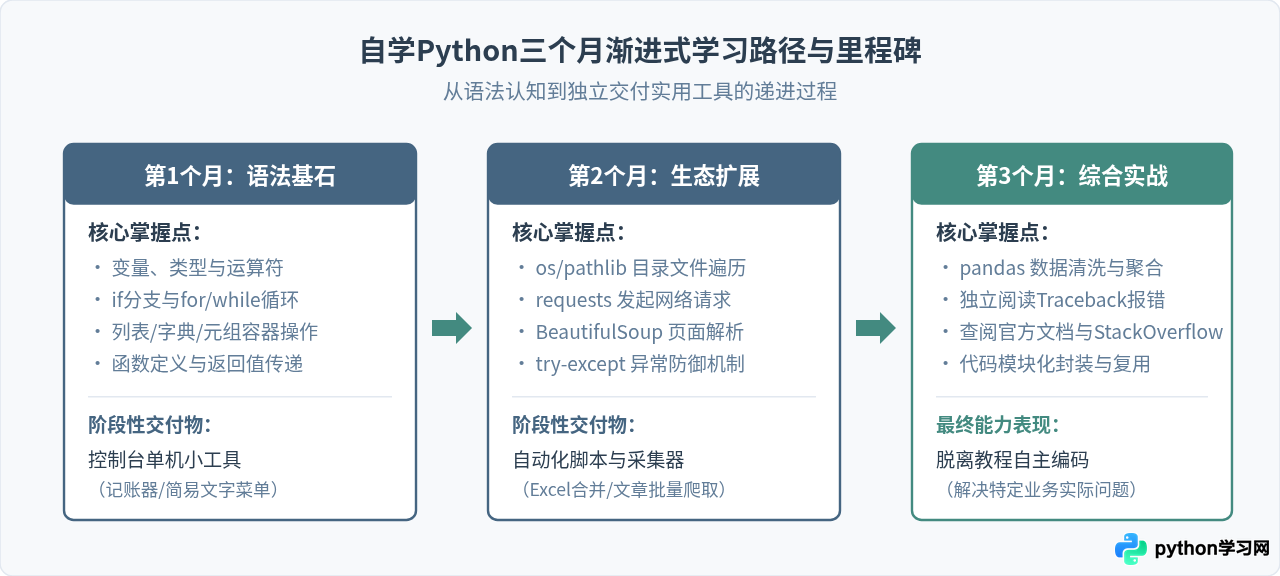
掌握Python的过程并非匀速上升,而是呈现明显的阶段阶梯。按照合理的规划,三个月通常可以拆分为基础语法期、模块应用期和综合实战期三个核心阶段:
第1个月:语法基石与编程思维建立(投入约40小时)
该阶段的核心目标是熟悉Python的基本表达机制,从读懂代码转变为能用变量与控制流表达现实逻辑。学习重点包括基本数据类型(整型、浮点型、字符串、布尔型)、控制流(if-else 条件判断、for 和 while 循环)、核心数据容器(列表 list、字典 dict、元组 tuple、集合 set)以及函数的定义与调用。
第一月末检验标准:能够脱离参考资料,独立写出一个基于控制台的简易学生成绩管理脚本,包含添加记录、根据条件查找、排序以及将数据保存到本地文本文件的功能。
第2个月:标准库与外部模块工具化(投入约40-50小时)
掌握语法后,学习重点转向如何利用Python丰富的生态解决实际问题。核心内容包括内置库 os、pathlib、datetime、math,以及三个方向的核心第三方库:处理Excel的 openpyxl、处理HTTP网络请求的 requests 和网页解析库 BeautifulSoup。同时,必须系统掌握异常处理机制(try-except),确保脚本在遇到文件不存在或网络波动时不会直接崩溃。
第二月末检验标准:能通过输入一个公开网页URL,完整抓取该页面的表格数据并正确转换为本地格式规范的Excel表格,遇到网络超时能给出友好报错提示。
第3个月:综合实战与独立工程能力(投入约40-50小时)
最后一个月不再盲目学习新语法,而是聚焦于代码的组织、排错与工程闭环。学习者开始接触 argparse 接收命令行参数、掌握 pandas 的基本数据筛选切片技巧,并学会使用虚拟环境(venv)管理项目依赖。更重要的是,能够熟练阅读Python解释器抛出的Traceback报错堆栈,通过定位行号和错误类型自主解决80%以上的语法与逻辑问题。
第三月末检验标准:能够独立构思并编写一个多步骤的综合小工具(代码量在150至300行之间),具备模块划分、清晰的函数注释与异常处理。
三、真实代码场景:三个月能写出什么样的代码
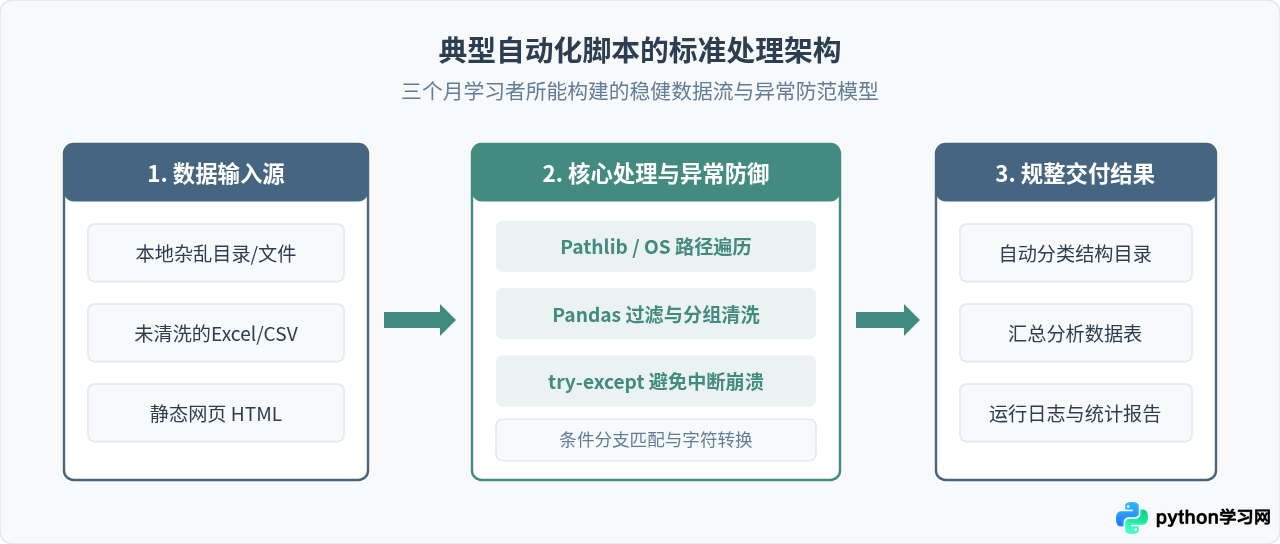
评判学习水平最直观的方式是看其产出的代码结构。学习三个月后,学习者应当脱离简单的单行交互代码,具备构建包含“输入检验”、“异常保护”、“业务处理”与“结果输出”的完整脚本能力。以下是三个月自学者完全能够独立实现的典型场景:
场景示例:自动扫描指定目录并按扩展名归档整理
在日常工作中,下载文件夹常堆积数百个各类文件。以下脚本展示了三个月学者应具备的编码规范:引入 pathlib 库面向对象处理路径、使用字典映射归档类别、运用 try-except 预防IO错误,并输出清晰的处理日志。
import os
from pathlib import Path

# 定义不同文件类型的存放子目录
FILE_CATEGORIES = {
    "文档": [".pdf", ".docx", ".xlsx", ".pptx", ".txt"],
    "图片": [".jpg", ".jpeg", ".png", ".gif", ".svg"],
    "代码": [".py", ".json", ".html", ".css", ".sql"],
    "压缩包": [".zip", ".tar", ".gz", ".rar"]
}

def organize_directory(target_path: str):
    source_dir = Path(target_path)
    if not source_dir.exists() or not source_dir.is_dir():
        print(f"错误:指定路径 '{target_path}' 不存在或非有效目录。")
        return

    processed_count = 0
    for file_path in source_dir.iterdir():
        # 仅处理普通文件,忽略文件夹
        if file_path.is_file():
            ext = file_path.suffix.lower()
            target_category = "其他"

            # 根据后缀匹配分类
            for category, extensions in FILE_CATEGORIES.items():
                if ext in extensions:
                    target_category = category
                    break

            dest_folder = source_dir / target_category
            dest_folder.mkdir(exist_ok=True)

            try:
                dest_file = dest_folder / file_path.name
                file_path.rename(dest_file)
                processed_count += 1
            except Exception as e:
                print(f"移动文件 {file_path.name} 失败: {e}")

    print(f"处理完成:共成功归档 {processed_count} 个文件。")

if __name__ == "__main__":
    # 执行目标路径(示例)
    organize_directory("./downloads_temp")
这段代码体现了三个月水平的核心标志:逻辑条理清晰、具备鲁棒性考虑(检查目标是否存在、捕获移动异常),并且能够通过模块化函数实现代码复用,而不是写成一串平铺直叙的面条代码。
四、拉开差距的三个分水岭
在同样投入三个月时间的前提下,学习者最终达到的水平往往差异巨大。有人只能勉强按照视频抄写代码,遇到微小变动便无从下手;而有人已经能独立编写出公司内部使用的报表工具。造成这种分化的核心原因并非天赋,而是是否跨过了以下三个关键节点:
避开“教程舒适区”陷阱:看懂视频不等于学会编程。视频教程中讲师已经规避了所有环境报错、版本差异和边界漏洞。只有自己关掉教学窗口、面对空白的编辑界面完整敲出逻辑并亲自排错,才算真正将知识内化。
1. 脱离教学视频后的独立抽象能力
初学者最大的挑战是“逻辑翻译能力”。例如面对一个业务需求:“从50个表格中找出上个月缺勤超过3天的员工”,未跨过门槛的人不知道该从何入手;而达标的学习者能迅速拆解步骤:① 遍历文件夹获取所有表格路径;② 循环读取每个表格;③ 用过滤条件筛选缺勤列;④ 存储符合条件的数据并导出。能否将模糊的自然语言需求拆解为有序的代码执行步骤,是三个月首要的分水岭。
2. 错误信息(Traceback)阅读与定位能力
初学者容易对控制台红色的错误报错产生恐惧感。高水平的自学者在第一行报错出现时,能够直接将视线拉到底部,识别核心错误类型:如 KeyError(字典不存在该键)、IndexError(列表越界)、AttributeError(变量类型与调用的方法不匹配)、FileNotFoundError(路径错误)。通过向上阅读调用堆栈定位具体报错文件与行号,并配合搜索引擎精准搜索报错关键字,而不是盲目求助他人。
3. 查阅官方文档与开源库更新说明
第三方库(例如 pandas、requests)频繁更新,网上教学视频中的部分语法往往已经弃用(如某些参数在新版本中变更)。达到合格水平的学习者不再依赖二手二手搬运教程,而是能够打开第三方库的官方Docs,直接在API Reference中查阅函数原型、参数类型与默认返回值,具备自给自足的信息获取能力。
五、自学三个月综合雷达评估与后续进阶建议
综合以上分析,我们可以从语法底座、工具库运用、排错与检索、工程化架构四个维度对自学三个月的综合表现进行量化概括:
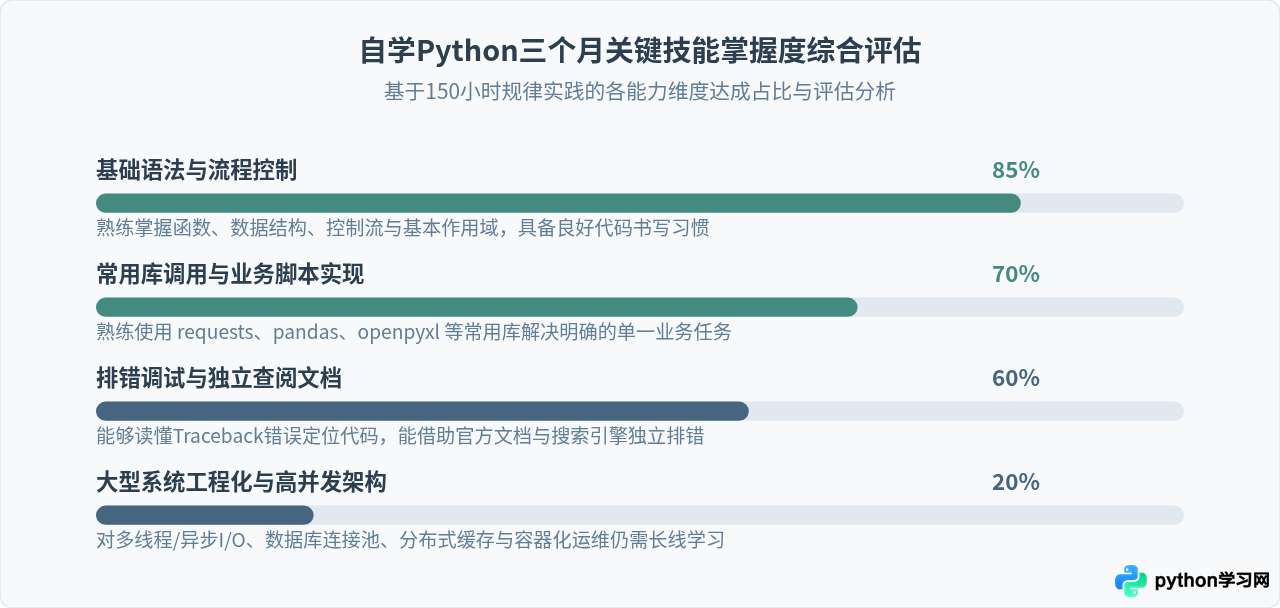
后续进阶规划建议
如果你已经度过了三个月的初学阶段并达到了上述标准,根据个人发展目标,可以采取以下进阶策略:
- 若定位为职场效率赋能(非专职程序员):无需深入研究复杂的底层算法和操作系统原理。建议深入专研
pandas高阶清洗技巧、学习sqlite3嵌入式数据库存储海量表格,以及使用Streamlit或Gradio快速将脚本包装为具有交互界面的Web小应用,直接在实际业务中创造可见价值。 - 若目标是转行全职开发人员:三个月仅是一个扎实的起点。接下来的学习路线应转向计算机基础科学与工程素养:系统学习关系型数据库(MySQL与SQL优化)、深入掌握一种主流Web后端框架(FastAPI或Django)、理解Git分支协同工作流、掌握基础数据结构与算法(LeetCode基础题练习),并深入理解Linux服务器操作与Docker容器部署。
总体而言,自学Python三个月所获得的不仅是几百行代码的编写技巧,更重要的是建立起一种严谨的计算思维:学会把混沌复杂的现实事务拆解为清晰的逻辑单元,并拥有利用程序工具解放双手的实际能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















