


Python面向对象入门:什么时候应该使用类来组织代码
深入解析Python面向对象编程中何时该使用类来组织代码。通过状态绑定、生命周期、反面模式对比与完整重构案例,帮助开发者清晰划分类、函数与模块的适用边界。
在学习 Python 时,许多初学者掌握了 class 的语法后,往往会产生一个典型困惑:既然用普通的函数和字典也能把程序跑通,为什么还要大费周折地定义类?反过来,有些开发者则走向另一个极端,把每个简单的计算逻辑都包进类中,导致代码繁琐冗余。判断什么时候该写一个类,核心标准非常明确:当一段逻辑中既有需要长期维护或变化的数据状态,又有专门针对这组状态的操作行为,且这组“状态 + 行为”需要在程序中存在多个独立副本时,就应该使用类。如果仅仅是一次性的数据计算、无状态的数据转换,或者简单的配置集合,普通的函数和基础数据结构反而更加清晰高效。
一、从散落的数据与函数,理解“类”的产生动机
为了直观感受类的价值,我们先看一段常见的无类代码。假设我们要开发一个简易的电商购物车系统,初学时很多人会这样写:
# 方案 A:使用字典和独立函数
cart_user_1 = {"user_id": 101, "items": [], "total_discount": 0.9}
cart_user_2 = {"user_id": 102, "items": [], "total_discount": 1.0}

def add_item(cart, name, price, quantity=1):
    cart["items"].append({"name": name, "price": price, "quantity": quantity})

def calculate_total(cart):
    subtotal = sum(i["price"] * i["quantity"] for i in cart["items"])
    return subtotal * cart["total_discount"]

# 业务调用
add_item(cart_user_1, "机械键盘", 399, 1)
print(f"用户1应付金额: {calculate_total(cart_user_1):.2f}")
这段代码完全能够运行,但在项目规模扩大时,会暴露出三个明显问题:
- 数据格式无保障:
cart_user_1只是一个普通字典。任何代码都能随时修改甚至删除它的键(比如意外执行了del cart_user_1["items"]),导致随后的calculate_total运行时抛出KeyError。 - 函数与数据绑定松散:开发者必须时刻记得把
cart字典作为第一个参数传递给各个函数。如果系统里还有order字典、user字典,参数一旦传错,只有运行到内部字段解析时才会崩溃。 - 状态校验逻辑到处复制:如果要求“折扣不能低于0.5”,在字典模式下,每次修改
cart["total_discount"]都要在调用方手动写一行校验。
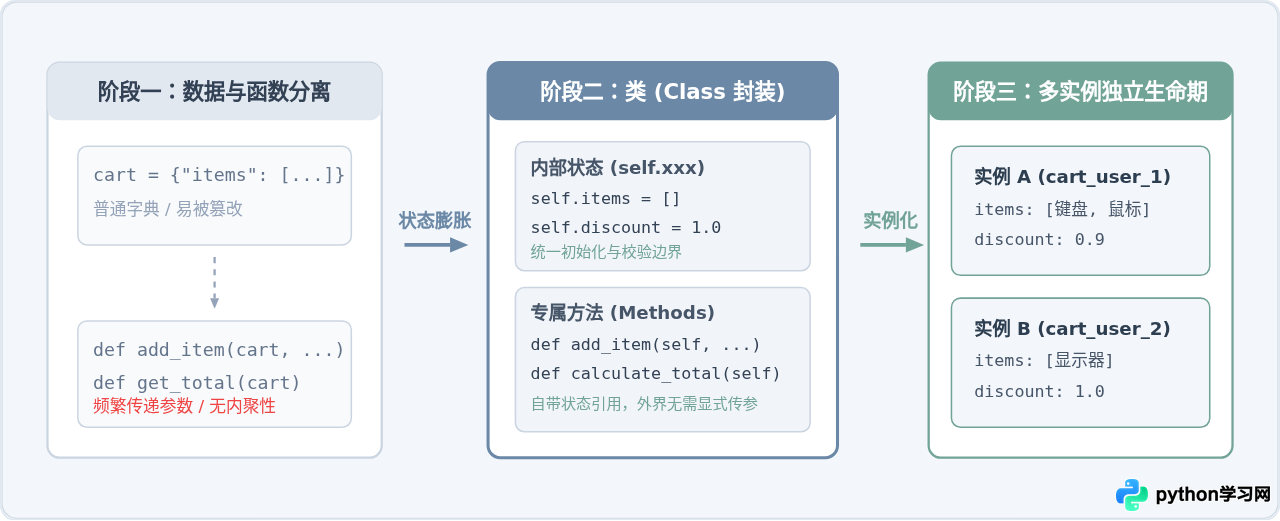
类(Class)正是为了将数据结构(属性)与对数据的合法操作(方法)捆绑在一起,形成一个不可分割的独立单元。下面这幅图展示了代码从松散结构向面向对象封装的演进过程:
二、使用类的四个核心信号(什么时候必须用类)
日常编写 Python 代码时,只要遇到以下四个典型特征之一,就应当果断使用类来组织代码:
1. 多个函数始终在操作同一组共享数据(状态与行为绑定)
如果你发现某一组函数总是把同一个数据字典或对象作为第一个参数传来传去,这通常是“代码需要一个类”的最强烈信号。改用类之后,数据保存在实例属性 self 中,所有方法都能直接访问,接口调用变得非常干净:
# 规范做法:将状态与行为封装进类
class ShoppingCart:
    def __init__(self, user_id: int, discount: float = 1.0):
        self.user_id = user_id
        self._items = []
        self._discount = min(max(discount, 0.5), 1.0)  # 在入口强制防御非法折扣

    def add_item(self, name: str, price: float, quantity: int = 1):
        if price <= 0 or quantity <= 0:
            raise ValueError("商品单价与数量必须大于 0")
        self._items.append({"name": name, "price": price, "quantity": quantity})

    def calculate_total(self) -> float:
        subtotal = sum(item["price"] * item["quantity"] for item in self._items)
        return subtotal * self._discount

# 外部调用完全聚焦在行为本身
cart = ShoppingCart(user_id=101, discount=0.9)
cart.add_item("机械键盘", 399)
print(f"实付金额: {cart.calculate_total():.2f}")
2. 系统中需要存在多个互不干扰的状态副本
如果业务中只需要处理一份固定状态(例如系统的全局配置读取),通常一个模块或少量函数足矣。但如果同样的逻辑需要同时为多个实体服务(例如连接多个不同的数据库、管理多个网络会话、或者追踪不同用户的上传进度),每个实体都有自己的连接状态、缓冲区或游标,使用类才能为每个对象分配独立的内存空间与生命周期。
3. 为了避免滥用 global 变量或长参数列表
在没有类的情况下,一些开发者为了让多个函数共享中间变量,会使用 global 关键字或者闭包变量;或者在函数间传递多达 6~8 个参数。这是极其脆弱的写法。将这些相关参数收敛为类的属性,不仅消除了全局命名空间污染,还让状态的变更点集中且可回溯。
4. 需要支持多态与统一接口协议
当你需要对不同的实现采取统一的调用方式时,类是最天然的选择。例如系统需要导出报告为 PDF、Excel 和 Markdown,你可以定义统一的 export(data) 方法:
class PDFExporter:
    def export(self, data):
        # 处理 PDF 字体、页面流并输出二进制
        return b"%PDF-1.4..."

class ExcelExporter:
    def export(self, data):
        # 组装 XML 工作簿并打包
        return b"PK\x03\x04..."

# 调用方无需关注细节,统一处理
def save_report(exporter, data, filename):
    content = exporter.export(data)
    with open(filename, "wb") as f:
        f.write(content)
三、决策指南:什么时候坚决不要写类
Python 是一门多范式语言,支持面向过程、函数式与面向对象。不要把 Java 或 C++ 的习惯直接搬到 Python 中。以下几种常见情况,坚决不建议使用类:
反面模式 1:类里只有一个方法
如果你写了一个类,除了 __init__ 之外只有一个 run() 或 execute(),而且实例化后只调用一次,这绝大多数情况下应该是一个普通函数,而不是类。
# 糟糕的过度设计:为了面向对象而写类
class GreetingFormatter:
    def __init__(self, prefix):
        self.prefix = prefix

    def greet(self, name):
        return f"{self.prefix}, {name}!"

# 正确优雅的 Python 做法:直接使用普通函数
def greet(name: str, prefix: str = "Hello") -> str:
    return f"{prefix}, {name}!"
反面模式 2:类全由静态方法组成,充当命名空间
很多初学者习惯创建一个 class StringUtils,里面堆放全是 @staticmethod 的工具函数。在 Python 中,一个 .py 文件本身就是一个顶级命名空间(模块)。直接将这些函数写在 string_utils.py 中,通过 import string_utils 调用,更加符合 Python 习惯。
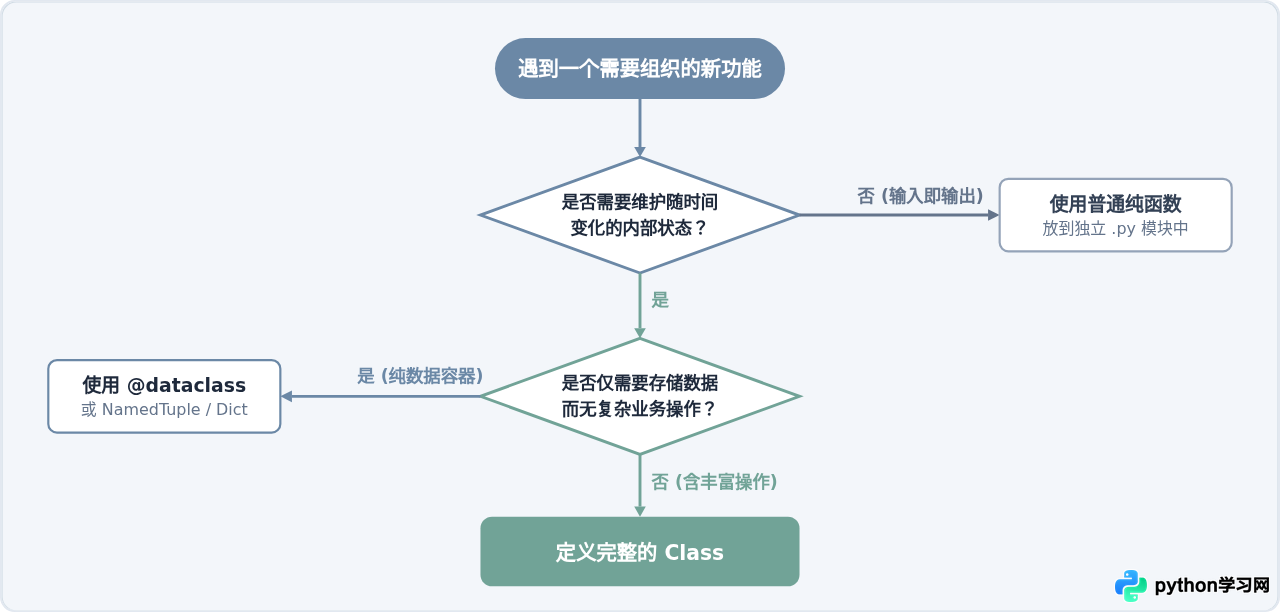
为了直观帮助你在实际编码中快速定夺,我们梳理了以下这张判断流程图:
四、代码架构的分层协同:模块、类、函数与数据结构
在高质量的 Python 工程中,类不是孤立存在的,它与其他代码组织单元协同工作。理解它们的分工边界,能帮你彻底告别“要么全是函数,要么全写成类”的极端架构:
| 代码层级 | 核心职责 | 状态特征 | 最佳使用场景 |
|---|---|---|---|
| 模块 (.py) | 高层逻辑划分、系统命名空间 | 通常全局无状态或单例 | 划分功能边界(如 db.py, utils.py) |
| 类 (Class) | 封装实体状态及其生命周期操作 | 维护动态私有状态 (self) |
连接池、状态机、多实例业务实体、图形控件 |
| 函数 (Function) | 明确的输入输出映射、特定运算步骤 | 无状态(纯函数优先) | 数据转换、过滤运算、脚本主流程管道 |
| 数据类 (@dataclass) | 结构化承载固定业务字段 | 静态或轻量可变数据 | API 响应体解析、配置项承载、DTO 数据传输 |
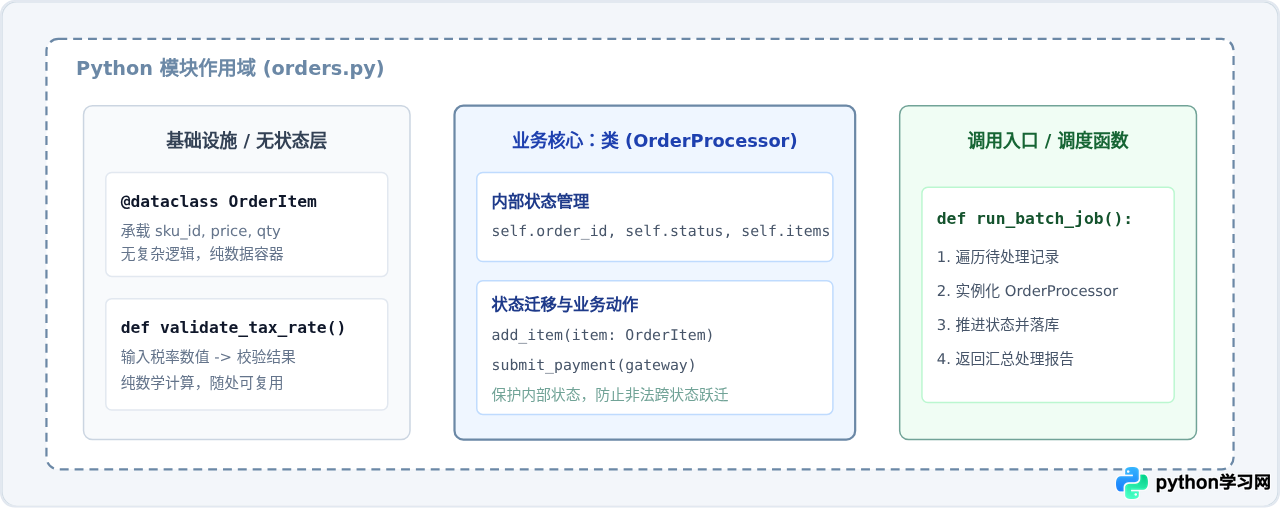
下图展示了一个标准业务模块中,这四种元素如何进行立体协作:
五、实战重构:从过程式脚本到清晰类设计的完整示例
为了加深理解,我们来看一个网络爬虫任务下载器的演进案例。初始版本由分散的全局变量和函数构成:
# 重构前:松散、依赖全局状态、无法并行支持多个不同任务
import time

download_queue = []
failed_records = []
max_retries = 3

def add_task(url):
    download_queue.append(url)

def process_tasks():
    global download_queue, failed_records
    while download_queue:
        url = download_queue.pop(0)
        success = False
        for attempt in range(max_retries):
            # 模拟网络请求
            print(f"下载 {url},尝试第 {attempt + 1} 次")
            success = True
            break
        if not success:
            failed_records.append(url)
如果现在系统要求同时运行两个不同优先级的下载队列,或者需要单独获取某个下载任务的进度统计,上述代码就彻底崩溃了——因为 download_queue 和 failed_records 只有一份。
我们用类对这段代码进行重构,将配置、状态队列与执行逻辑收拢:
# 重构后:封装良好的 TaskDownloader 类
from typing import List, Dict
import time

class TaskDownloader:
    def __init__(self, name: str, max_retries: int = 3):
        self.name = name
        self.max_retries = max_retries
        self._queue: List[str] = []
        self._failed: List[str] = []
        self._success_count: int = 0

    def add_task(self, url: str) -> None:
        if not url.startswith(("http://", "https://")):
            raise ValueError(f"非法 URL 协议: {url}")
        self._queue.append(url)

    def run(self) -> Dict[str, int]:
        while self._queue:
            url = self._queue.pop(0)
            if self._mock_fetch(url):
                self._success_count += 1
            else:
                self._failed.append(url)
        return self.get_summary()

    def _mock_fetch(self, url: str) -> bool:
        # 内部方法:模拟下载,不对外暴露
        return True

    def get_summary(self) -> Dict[str, int]:
        return {
            "downloader_name": self.name,
            "success": self._success_count,
            "failed": len(self._failed),
            "pending": len(self._queue)
        }

# 调用端:随时创建多个相互隔离的下载器实例
vip_downloader = TaskDownloader(name="VIP通道", max_retries=5)
general_downloader = TaskDownloader(name="普通通道", max_retries=2)

vip_downloader.add_task("https://example.com/asset1.png")
general_downloader.add_task("https://example.com/data.csv")

print(vip_downloader.run())
print(general_downloader.run())
重构带来的收益:重构后,不仅完全消除了全局变量,而且可以轻松实例化任意多个下载器,彼此的状态互不干扰;通过下划线开头的 _queue 和 _failed 实现了内部状态保护,外部只能通过规范的 add_task() 录入任务,杜绝了非法数据的混入。
六、总结与类设计自查速查表
在 Python 编程实践中,类的使用应当遵循“需要才引入,不过度包装”的原则。在下一次准备敲出 class 关键字前,不妨对照以下速查导图进行快速自检:
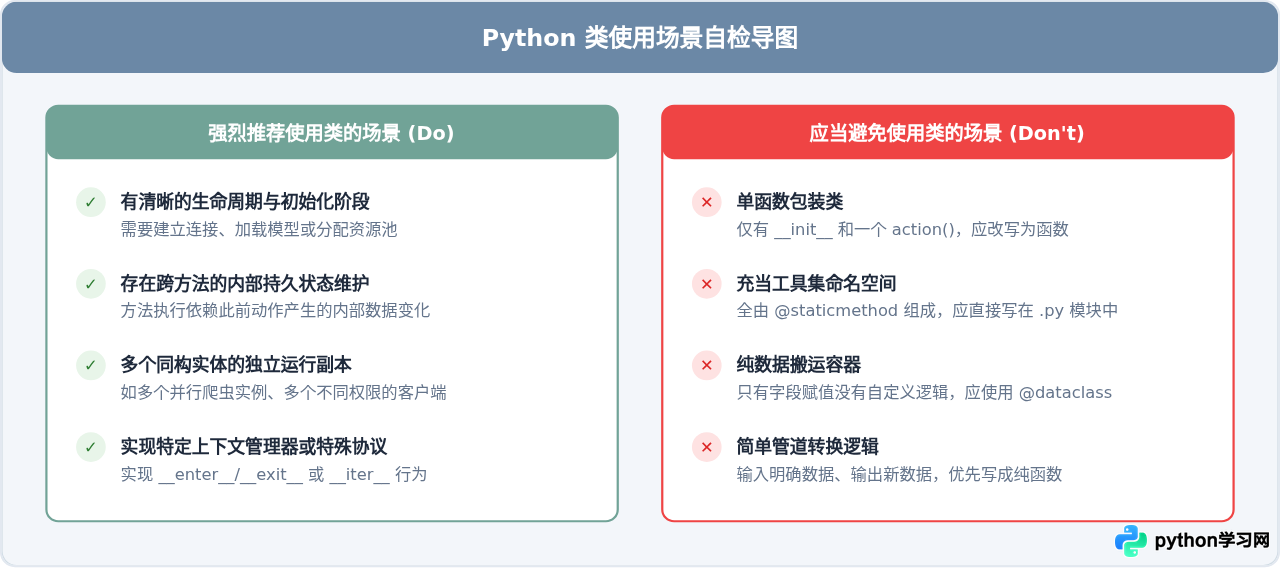
记住核心经验法则:“函数做动作,数据类承载事实,而类守护活生生的状态。” 把握好这一界限,编写出来的 Python 代码就能兼具表达力、整洁性与可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















