


python位置参数和关键字参数区别
全面解析Python位置参数和关键字参数区别,涵盖底层绑定机制、调用解析流水线、/与*语法边界控制、常见报错排查及工程最佳实践。
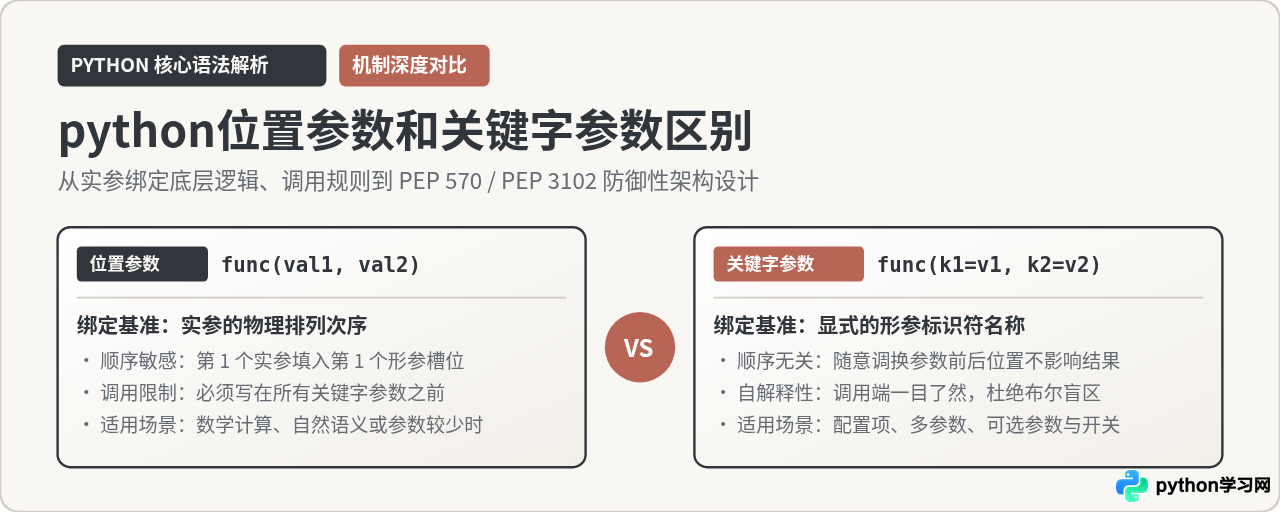
在 Python 函数调用中,位置参数(Positional Arguments)与关键字参数(Keyword Arguments)的根本区别在于实参绑定到形参的寻址基准不同:位置参数依靠实参在调用括号内的物理排列次序,由左至右按索引分配;关键字参数则显式采用“形参名=值”(name=value)的键值对形式,直接通过变量名寻址赋值。两者的差别贯穿了调用语法顺序、默认值匹配、代码可读性以及现代 Python(3.8+)的 / 与 * 防御性架构设计。
一、核心概念界定与绑定机制差异
要厘清两者的本质区别,首先需要区分“函数定义时的形参(Parameter)”与“函数调用时的实参(Argument)”。在普通函数定义中,形参本身通常并不死板规定自己必须是位置参数还是关键字参数,而是由调用方传入实参的方式决定其身份。
我们来看一个典型用户注册函数的声明与三种调用方式:
# 定义包含两个必填参数和一个默认值参数的函数
def register_user(username, age, role='member'):
    return f"用户: {username}, 年龄: {age}, 角色: {role}"

# 1. 位置参数调用:仅传实参值,完全靠顺序对应
res1 = register_user("Alice", 24)

# 2. 关键字参数调用:显式声明形参名,顺序颠倒依然准确
res2 = register_user(age=24, username="Alice")

# 3. 混合调用:位置参数在先,关键字参数在后
res3 = register_user("Alice", age=24, role="admin")
在这三种调用中,register_user("Alice", 24) 的 "Alice" 处于第 0 位,因此自动赋给第 0 个形参 username;24 处于第 1 位,赋给 age。而 register_user(age=24, username="Alice") 则完全脱离了位置索引,Python 解释器直接读取键名 age 和 username,分别填入对应槽位。
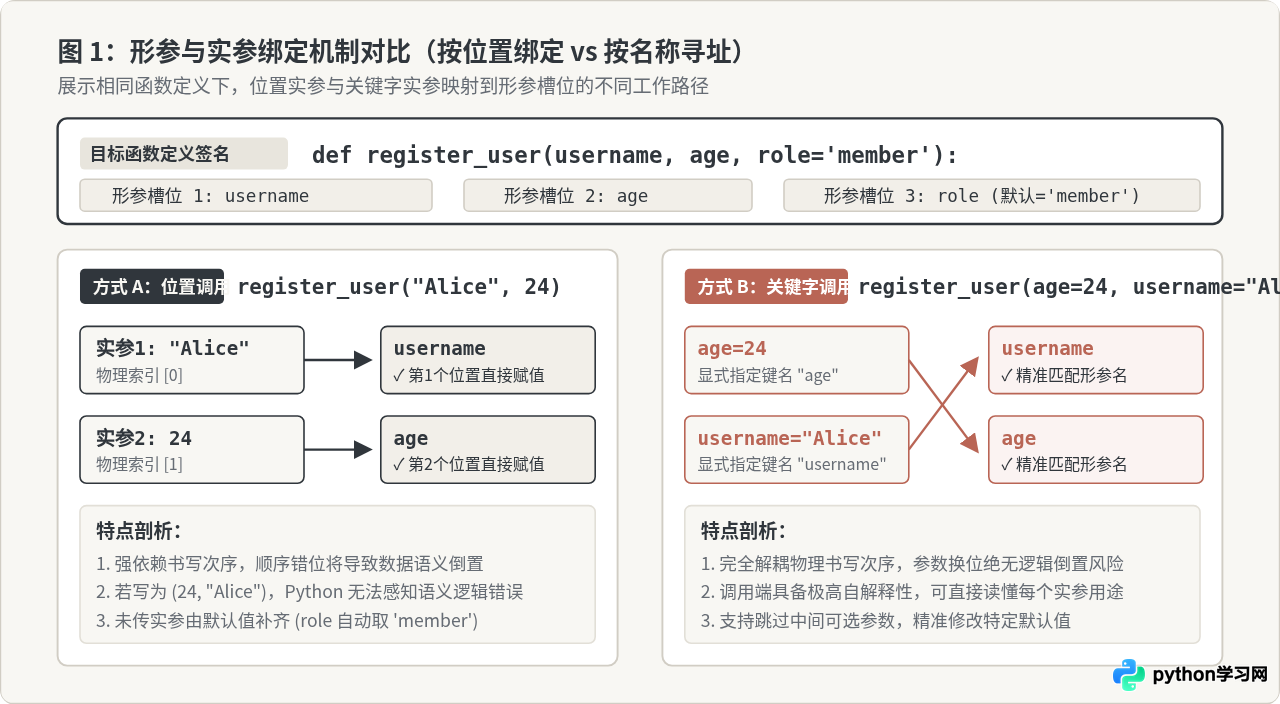
从底层数据流和开发体验上看,二者的主要维度对比如下:
| 对比维度 | 位置参数(Positional Arguments) | 关键字参数(Keyword Arguments) |
|---|---|---|
| 寻址依据 | 实参在调用括号中的先后物理次序 | 显式指定的形参标识符名称(name=value) |
| 顺序依赖性 | 强依赖。实参次序颠倒将导致数据传错槽位 | 完全无关。可按任意次序书写,不影响绑定目标 |
| 跳过默认参数 | 无法直接跳过。若想给第 3 个参数传值,必须先补齐前 2 个 | 极其灵活。直接指定目标参数名,无需提供中间参数 |
| 调用自解释性 | 较弱。如 draw(10, 20, 100, 200, True) 难以直观理解 |
极强。如 draw(x=10, y=20, width=100, height=200, fill=True) |
| 形参更名敏感度 | 函数内部重命名形参,调用端代码不受任何影响 | 函数形参一旦重命名,外部所有使用原键名的调用全部报错 |
二、调用解析规则与解释器执行流水线
当开发者在同一个函数调用中混合使用位置参数与关键字参数时,必须遵循 Python 语法层面的两条不可逾越的“铁律”:
- 铁律一:位置参数必须严格置于关键字参数之前。如果语法解析器在位置参数之前检测到了关键字参数,将直接抛出
SyntaxError。例如register_user(username="Alice", 24)是无法通过语法检查的。 - 铁律二:同一个形参绝对不能被重复赋值。位置参数已经占用的形参槽位,后续的关键字参数绝不能再次传递。例如
register_user("Alice", 24, username="Bob")会因username被双重赋值而抛出TypeError。
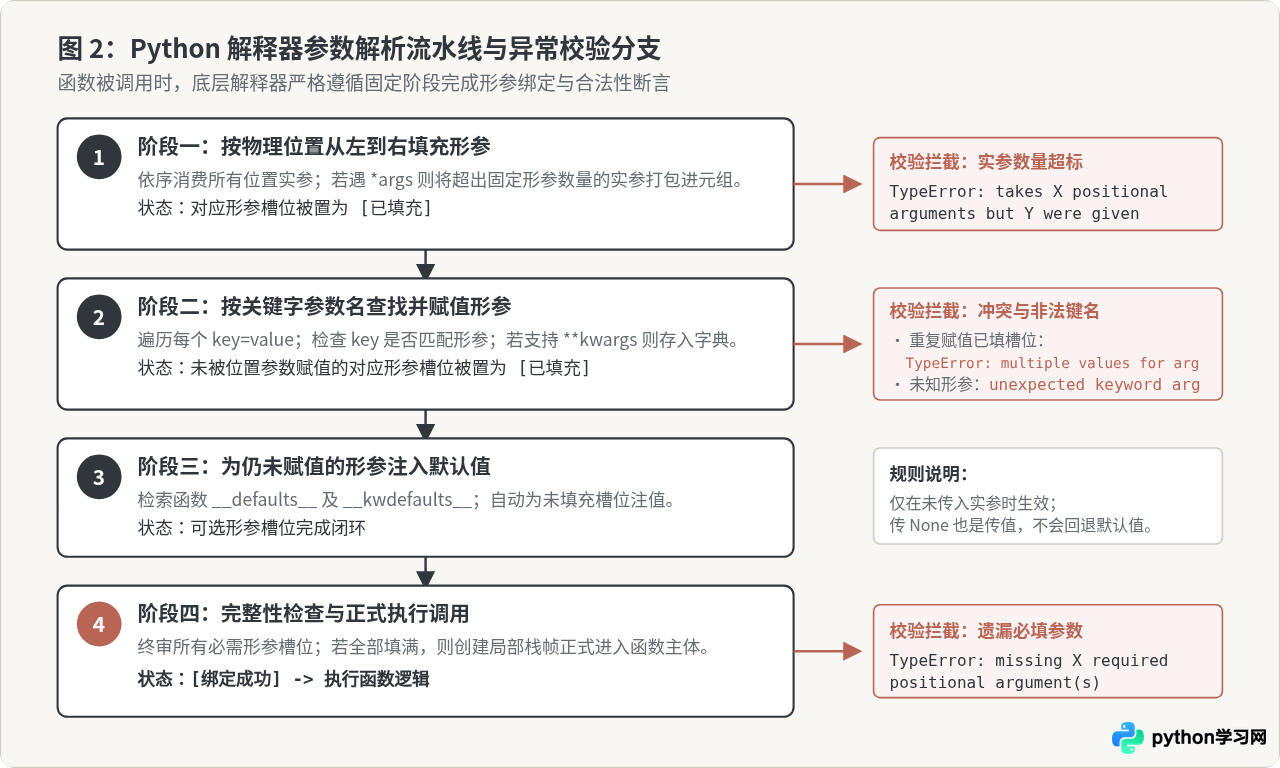
在 Python 解释器内部(CPython 的 ceval.c 及相关调用栈实现),参数的校验与解析并非随意处理,而是分为清晰的四个阶段:
-
阶段一(位置绑定):从左到右提取所有位置实参,依次填入函数的前置形参槽位。若实参数量超过了函数允许的最大位置形参个数,且函数未定义
*args,立刻拦截并抛出TypeError: takes X positional arguments but Y were given。 -
阶段二(关键字匹配):遍历所有形参键值对。首先检查该键名是否已被第一阶段的位置实参填满,若已填则抛出
TypeError: got multiple values for argument;其次检查函数是否存在同名形参,若不存在且无**kwargs收集器,则抛出TypeError: unexpected keyword argument。 -
阶段三(默认值回退):检查所有尚未填充的形参槽位。若该形参在定义时声明了默认值(存储在
__defaults__或__kwdefaults__中),解释器自动将其注入槽位。 -
阶段四(完整性终审):核对所有必需参数(即无默认值的参数)。若仍有槽位处于空白状态,立即抛出
TypeError: missing X required argument(s)。只有通过全部终审,解释器才会分配局部变量栈并开始执行函数体代码。
三、语法进阶:利用 / 与 * 进行边界防御
在传统 Python 语法中,大部分普通形参既可以被当做位置参数传递,也可以被当做关键字参数传递。然而在大型系统架构和 API 演进中,这种自由度往往带来维护隐患:
- 隐患 1:API 脆弱性。如果函数调用者大面积使用
func(name="Tom"),函数维护者未来就无法轻易将形参name重命名为更贴切的user_name,否则会打碎外部依赖。 - 隐患 2:布尔盲区(Boolean Blindness)。当函数包含多个布尔标志位时,调用者若写成
process(data, True, False, True),代码审查者根本无法识别这几个True/False到底控制什么逻辑。
为了彻底解决这两种痛点,现代 Python 正式确立了两个控制符号:Python 3.0 引入的 *(PEP 3102 仅限关键字参数),以及 Python 3.8 引入的 /(PEP 570 仅限位置参数)。
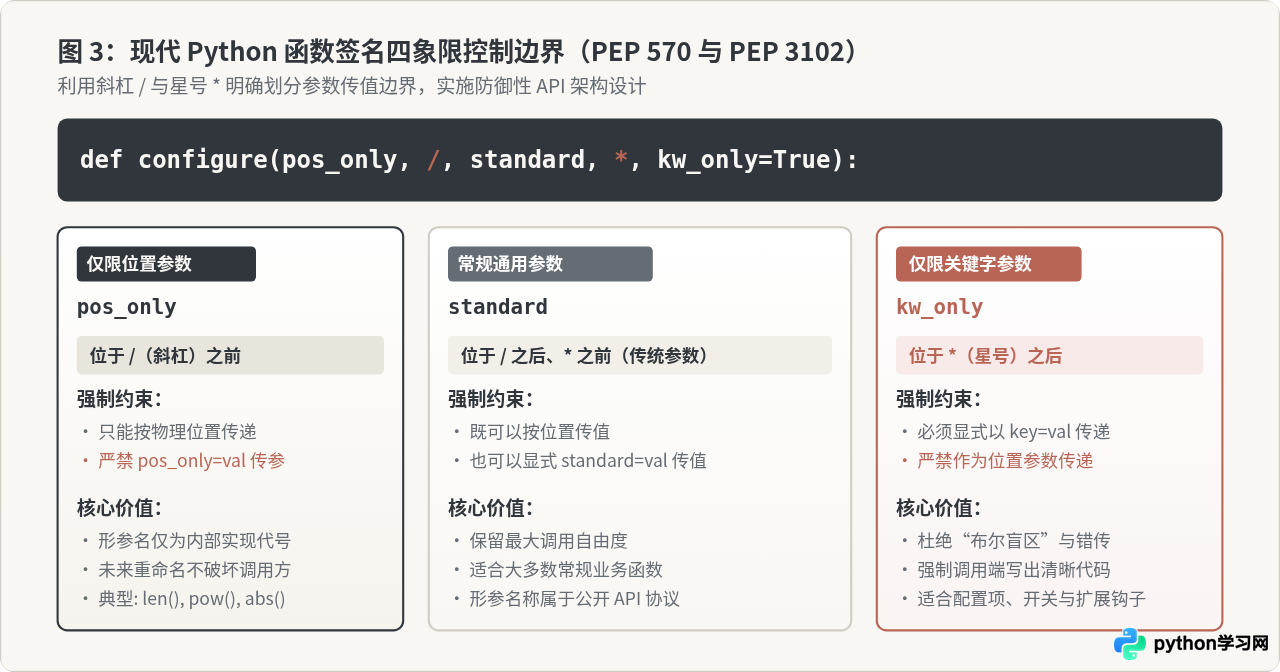
1. 仅限位置参数(Positional-Only Parameters):斜杠 /
在函数签名中,凡是位于 / 左侧的所有形参,必须且只能通过位置参数传递。调用方严禁以 key=value 的形式传递这些形参。
# a 与 b 是仅限位置参数;c 是常规参数
def calculate_vector(a, b, /, c=1.0):
    return (a + b) * c

# 合法调用:a 和 b 按位置传递
print(calculate_vector(10, 20, c=2.0))

# 非法调用:试图使用 a=10 进行关键字传递
# 触发 TypeError: calculate_vector() got some positional-only arguments passed as keyword arguments: 'a'
# calculate_vector(a=10, b=20)
这一特性广泛存在于 Python 内置 C 模块(如 abs(x)、len(obj)、math.pow(x, y))。内置函数的形参名往往只是占位符,强制仅限位置不仅执行速度更快,而且赋予了作者未来无痛重命名形参的完全自由。
2. 仅限关键字参数(Keyword-Only Parameters):星号 *
在函数签名中,凡是位于独立 *(或变长位置参数 *args)右侧的所有形参,必须且只能通过关键字参数传递。调用方严禁用纯位置实参注入。
# text 是常规参数;case_sensitive 和 max_split 是仅限关键字参数
def tokenize(text, *, case_sensitive=False, max_split=100):
    return text.split()

# 合法调用:强制显式指明参数名
tokenize("hello world", case_sensitive=True)

# 非法调用:试图将布尔值按位置传入
# 触发 TypeError: tokenize() takes 1 positional argument but 2 were given
# tokenize("hello world", True)
通过 * 强制要求调用端写明 case_sensitive=True,使得代码调用意图一目了然,从源头上扼杀了布尔参数错位导致的逻辑灾难。
四、常见开发陷阱与报错排查
在日常使用位置参数与关键字参数时,开发者最常遇到以下四个典型错误:
错误原因:代码在传参时,把普通位置实参写在了一个关键字参数的后面。
# 错误示例:位置实参 "developer" 出现在关键字实参 age=30 之后
register_user("Charlie", age=30, "developer")  # 语法解析阶段即崩溃

# 正确修复方案:所有无名位置参数必须排在最前方
register_user("Charlie", 30, role="developer")
错误原因:通过位置实参已经给某个形参赋了值,但在同一调用中,后面又通过关键字实参对同一个名字传了值。
# 错误示例:"Dave" 已经占据第 0 位(username),后续又显式传 username="David"
register_user("Dave", 28, username="David")

# 正确修复方案:核对槽位,避免重复指定
register_user("David", 28)
当使用列表/元组解包 *args 和字典解包 **kwargs 时,必须同样严格遵循“位置解包在先、关键字解包在后”的规范:
params = ["Eve", 22]
extra = {"role": "guest"}

# 正确顺序:*args 在前,**kwargs 在后
register_user(*params, **extra)

# 错误顺序:**kwargs 放在 *args 之前将触发 SyntaxError: iterable argument unpacking follows keyword argument unpacking
# register_user(**extra, *params)
虽然关键字传参可以按名指定可选参数,但若函数形参的默认值是可变对象(如 list 或 dict),即便每次都通过关键字传参调用,只要不给该参数传新值,所有调用都将共享函数定义时的同一份内存对象。
# 危险写法:默认参数使用空列表
def add_log(message, *, tags=[]):
    tags.append(message)
    return tags

# 规范解法:默认使用 None,内部判定重置
def add_log_safe(message, *, tags=None):
    if tags is None:
        tags = []
    tags.append(message)
    return tags
五、工程最佳实践与选型全景指南
在实际工程项目开发中,合理选用位置参数与关键字参数,是衡量代码可读性、防御性和架构质量的重要指标。
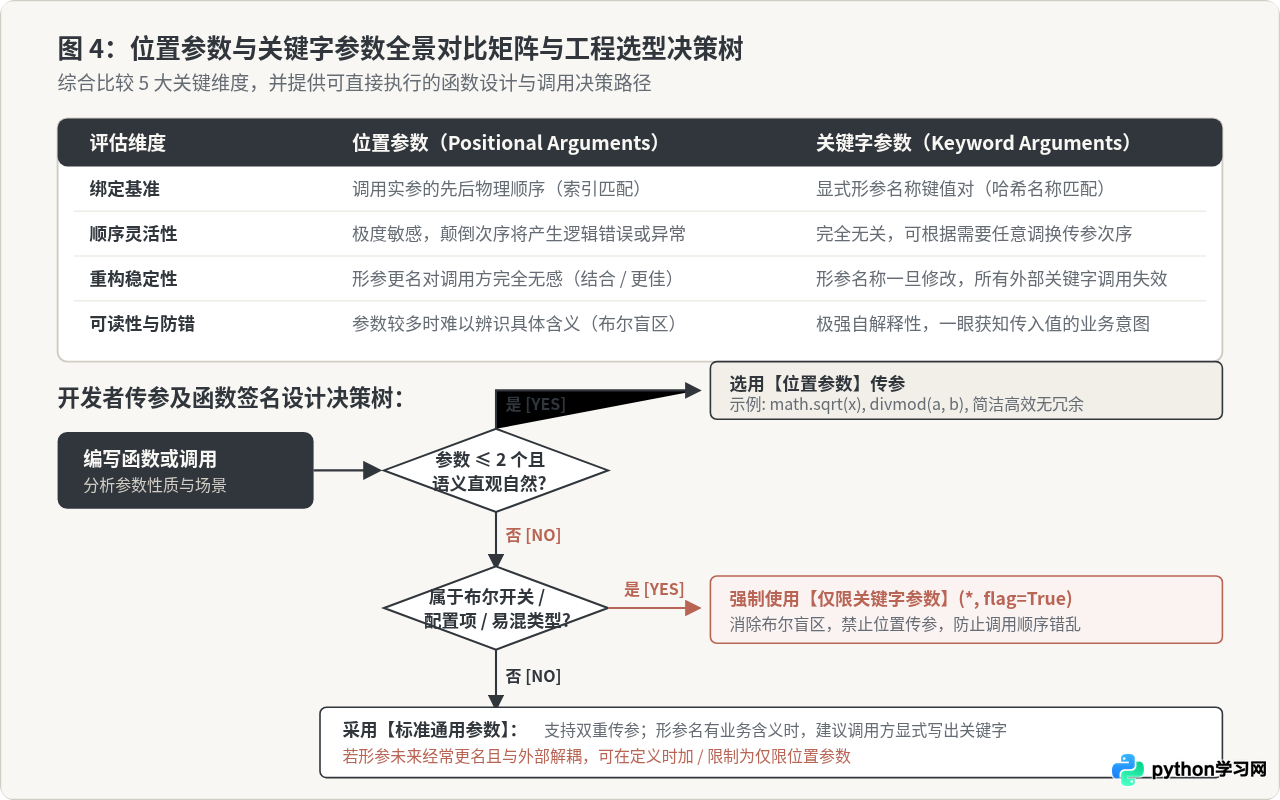
具体选型建议归纳如下:
-
优先使用位置参数的场景:
函数的参数极其精简(通常 ≤ 2 个),且参数之间存在大家熟知的天然逻辑顺序。例如数学函数
math.sin(x)、divmod(a, b),或者单对象转换str(obj)。此时使用位置参数传值最简洁、执行效率最高。若形参名称纯属实现细节、不希望外部依赖,应在签名末尾加上/。 -
强制使用关键字参数的场景:
当参数属于布尔标志(Flags)、阈值或配置项(如
timeout=30,retry=3,reverse=True),或者函数的形参达到 3 个及以上时,强烈建议在定义时使用*进行隔离,强制调用端显式传入参数名。这不仅可以消灭难以排查的“布尔盲区”,还能在新增可选参数时实现完全向后兼容。 -
调用端的防错自律:
即便底层库函数没有强制声明
*,在调用包含多个相同类型参数的函数时(例如图像裁剪坐标crop(x, y, w, h)),调用端主动显式写出crop(x=0, y=0, w=100, h=100)也是极具工程价值的防错好习惯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















