


在线Python编译器支持哪些第三方库?常见功能限制解析
深入解析主流在线Python编译器所支持的第三方库分类、底层运行架构差异以及网络、文件系统与计算资源等方面的常见功能限制。
打开浏览器写 Python 已经成为验证代码片段、完成基础教学和调试算法的首选方式。但很多人在本地跑得通的代码,一复制到网页端就会遭遇诸如 ModuleNotFoundError、只读报错或静默卡死。在线 Python 编译器能用什么第三方库、不能做什么操作,并不取决于前端界面长什么样,而是由其底层采用的执行架构(浏览器端 WebAssembly 还是远程服务器容器)以及平台施加的沙箱安全策略决定的。明确这两条分界线,就能在写代码前准确预判工具的适用边界。
两类截然不同的底层运行机制
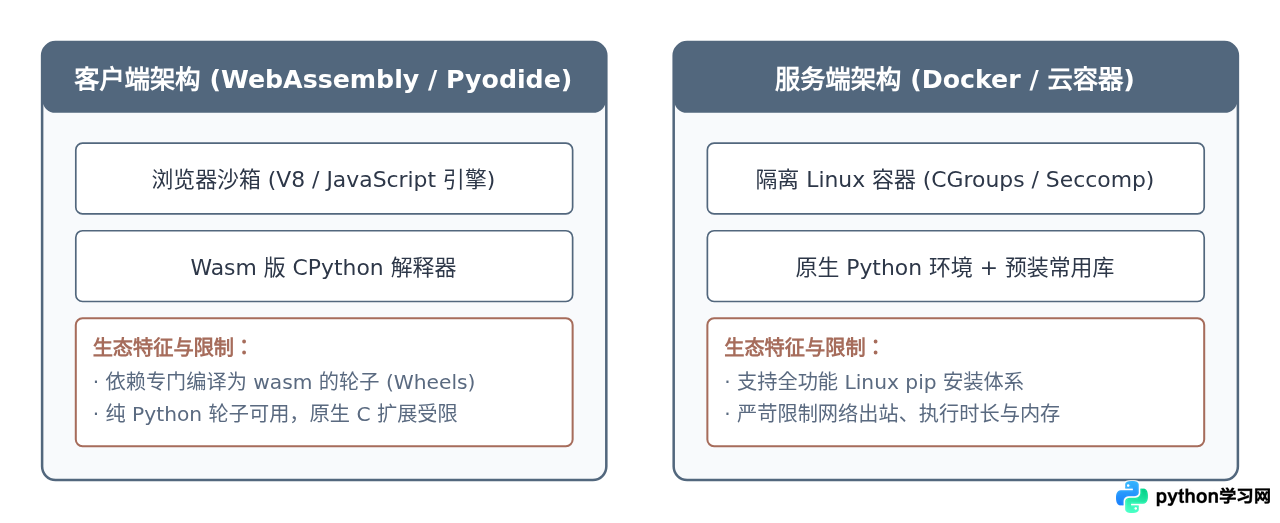
要判断一个在线环境能装什么库,必须先辨别它究竟是在你的本地浏览器里运算,还是在远程服务器上跑代码。市面上的在线 Python 编译器主要分为两派:基于 WebAssembly(以 Pyodide 为代表)的客户端运行架构,以及基于 Docker 等容器技术的服务端运行架构。
在基于 WebAssembly 的环境中,Python 解释器被编译成了可以在浏览器直接运行的二进制模块。代码在你的电脑内存与 CPU 中执行,平台无需承担计算服务器开销,因此服务通常长期免费且极少排队。但它的缺点也很突出:纯 Python 写的第三方库可以通过特定的轻量包管理器加载,而涉及底层 C/C++ 扩展编译的库(如早期版本的某些复杂科学计算库或特定驱动)必须经过专门移植编译成 wasm 格式才能支持。
在服务端容器架构中,服务商在后端为你分配一个短暂存活的 Linux 容器或微虚拟机。用户在网页点击“运行”,代码被网络协议发到后台容器执行,再把标准输出回传。这类平台理论上能执行完整的 Linux 常用命令和 pip install,对 C 扩展、多线程乃至原生二进制文件的兼容度高,但由于涉及真实服务器成本和网络攻击防范,平台会对资源使用时间和网络权限施加极为严苛的限制。
第三方库的支持范围与分类
无论平台界面如何封装,第三方库在在线环境下的支持情况基本可以划分为四种等级:
1. 平台默认预装库(零配置即用)
只要是面向数据分析或初学者的主流在线平台,通常在初始化容器或 Wasm 运行时就直接内置了基础工具包。最常见的是科学计算全家桶:numpy、pandas、matplotlib,以及轻量算法库 scikit-learn。你可以直接执行 import numpy as np 而无需任何下载流程。
2. 纯 Python 编写的第三方库(大多支持动态安装)
如果一个库的代码完全由标准 Python 语法编写,不包含任何需要用 GCC 或 MSVC 编译的底层代码(例如简单的爬虫解析库 beautifulsoup4、数据格式工具 marshmallow 或代码美化工具),只要平台开放了安装入口,无论是服务端的 pip 还是客户端的 micropip,均可快速拉取并正常加载。
3. 带有特定编译扩展的大型库(依赖平台适配)
类似 scipy、opencv-python(cv2)、Pillow 或复杂图像处理库,底层包含庞大的 C、C++ 或 Fortran 代码。在服务端容器里,平台只要构建了对应镜像就能用;但在浏览器端 Wasm 环境中,必须有人提前针对 Emscripten 工具链完成交叉编译与打补丁。如果官方源没有适配的 .whl 包,用户即便强行执行安装指令也会报错退出。
4. 深度依赖底层硬件与操作系统的库(基本全军覆没)
以下两类库在绝大多数在线平台中无法正常运转:
- 桌面图形界面(GUI)库:例如
tkinter、PyQt5、wxPython。在线环境没有本地的 X11 或 Wayland 显示服务器,也没有 Windows 窗口句柄。除极少数集成了 Web VNC 虚拟桌面的重型实验台外,常规在线编译器在import tkinter时就会抛出缺少显示服务(No display name and no $DISPLAY environment variable)的异常。 - 硬件与底层系统控制库:如
pynput(键盘鼠标全局钩子)、pyautogui(屏幕按键自动化)、pyserial(串口通讯)或scapy(底层网络抓包)。浏览器和沙箱容器出于绝对安全隔离,不会暴露宿主机的底层硬件设备。
如何检验当前在线环境支持哪些库
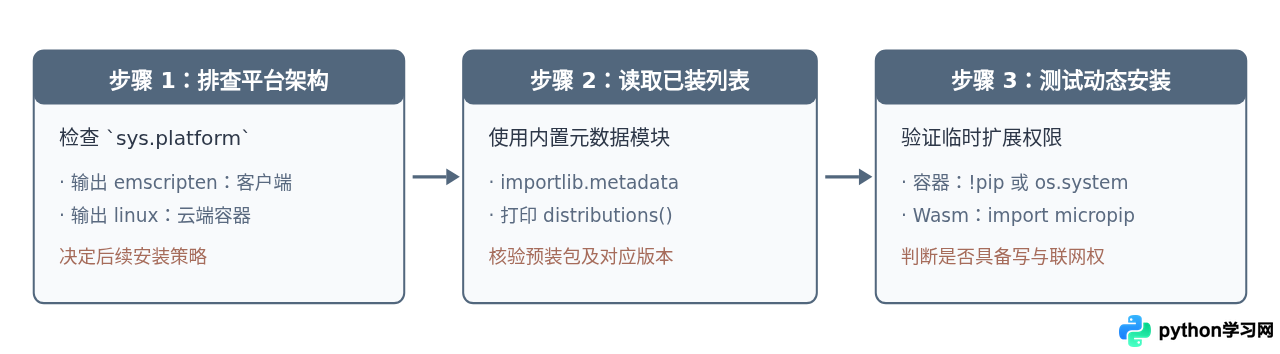
不必到处去查平台的文档表格,在代码框里运行以下三步排查代码,就能直接确认当前环境支持的范围和安装能力。
执行验证脚本示例
import sys
import importlib.metadata

# 1. 确认系统底层环境
print(f"Platform: {sys.platform}")
print(f"Python Version: {sys.version.split()[0]}")

# 2. 列出前 10 个已预装的核心第三方包
installed = sorted([dist.metadata['Name'] for dist in importlib.metadata.distributions()])
print(f"Total installed packages: {len(installed)}")
print(f"Sample packages: {installed[:8]}")

# 3. 针对特定依赖做快速测试
target_lib = "requests"
try:
    __import__(target_lib)
    print(f"Status: '{target_lib}' is ready to use.")
except ImportError:
    print(f"Status: '{target_lib}' is NOT pre-installed.")
示例输出:
Platform: linux
Python Version: 3.10.12
Total installed packages: 42
Sample packages: ['beautifulsoup4', 'certifi', 'charset-normalizer', 'contourpy', 'cycler', 'idna', 'matplotlib', 'numpy']
Status: 'requests' is ready to use.
如果你在第一步得到的平台是 emscripten,那么普通的 os.system('pip install xxx') 是无法工作的,需要使用专门的异步语法来载入纯 Python 库:
# 适用于 WebAssembly (Pyodide) 环境下载第三方库
import micropip
await micropip.install("packaging")
import packaging
print("Installed successfully via micropip!")
在线环境的核心功能限制解析
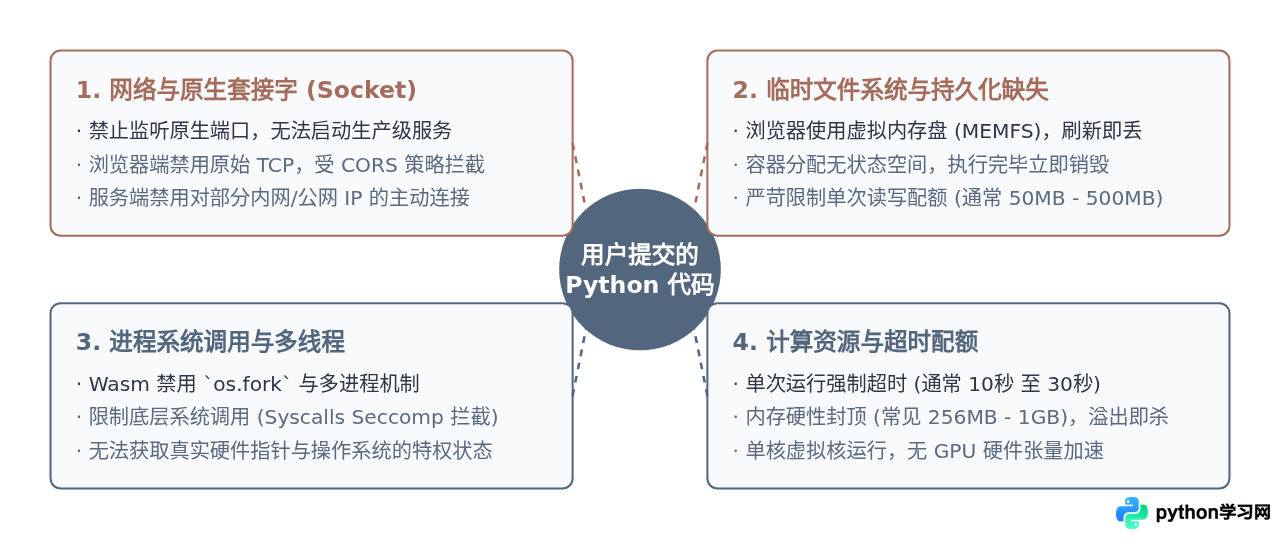
很多开发者在本地开发时形成了固定的编码习惯,一旦挪到在线网页,便经常遇到各种静默失败。这些现象并不是 Python 语法出了问题,而是提供商为了维护公共资源安全而设立的物理沙箱边界。
1. 网络限制:外部请求与 Socket 绑定
在网络方面,两大架构有各自的“墙”:
- Wasm 客户端:代码其实是在浏览器沙箱里跑,根本没有操作底层 TCP/UDP 原始套接字的权限。如果你尝试写一段经典的
socket.socket()发起连接,直接会报错。如果你用requests或urllib去爬取外部网站,所有流量必须经由浏览器的fetchAPI 代理,这意味着你会直接撞上跨域资源共享(CORS)策略。除非目标网站显式返回了允许跨域的响应头,否则请求在浏览器层就会被拦截丢弃。 - 云端容器:很多免费的云端在线环境为了防止被用来当作肉鸡挖矿、发垃圾邮件或发动 DDoS 攻击,会配置严格的防火墙规则(iptables/Security Groups),默认禁止所有未经白名单允许的外网出站连接。即使容器允许安装
requests,执行requests.get("https://...")时也往往会无限挂起直到超时。另外,你无法在公网真正 bind 一个端口来搭建生产可访问的 Web 服务(如app.run(port=8000)),即使提示服务运行中,外部也因端口未做 NAT 映射而无法接入。
2. 文件系统限制:临时虚拟空间与只读约束
几乎所有在线编译器都可以执行 with open("test.txt", "w") as f: f.write("ok"),这常常让新手误以为它拥有完备的文件系统。但必须注意两点:
- 持久性为零:浏览器端环境使用的是 Emscripten 的虚拟内存文件系统(MEMFS)。文件被保存在浏览器的内存分配区中,只要你按一下
F5刷新页面,之前写好的文本或生成的本地图片就会彻底蒸发。服务端容器也类似,每次点击“运行”或关闭标签页,平台会销毁旧容器并分配新实例。如果需要长期保存输出数据,必须手动复制代码或通过平台提供的下载按钮转存。 - 容量与写入区域限制:云端编译器通常只开放当前工作目录(如
/workspace或/tmp)的写权限,对系统根目录、配置目录是严格只读的。如果尝试写入几百兆的大文件,很容易触发磁盘配额溢出错误(Disk quota exceeded)。
3. 计算与执行生命周期限制
为了防止用户的死循环代码(如 while True: pass)拖垮计算集群或卡死单线程浏览器标签页,几乎所有平台都部署了看门狗机制(Watchdog):
- 时间硬上限:常见单次执行时长阈值被卡在 10 到 30 秒 之间。一旦超过该时间,后台会直接向进程发送
SIGKILL信号,或者浏览器前端弹出“页面无响应”警报,强制打断任务。 - 内存与多核约束:大多数免费分配的实例内存上限在 256MB 到 1GB 之间。当载入超大 CSV 文件(例如几百万行)并试图用
pandas做聚合计算时,会直接因 OOM(Out Of Memory)被底层内核无感知杀掉,终端仅显示Killed或返回非零状态码。
multiprocessing.Pool),在 Wasm 编译器中会直接触发 NotImplementedError,而在轻量容器中经常因为缺少共享内存设备(如 /dev/shm 容量受限或缺少权限)而抛出死锁或权限错误。在在线环境中,应优先将逻辑降级为单线程或标准循环。
常见任务适用性对比
为了让读者在实际编写代码前快速确定方案可行性,下表系统梳理了主流编程任务在两类典型在线环境中的支持表现:
| 业务场景 / 任务类别 | 典型依赖库 | WebAssembly (Pyodide) | 服务端容器 (Docker) | 推荐解决方案 |
|---|---|---|---|---|
| 基础语法与算法验证 | math, random, itertools |
完全支持 | 完全支持 | 任意在线环境均可胜任 |
| 数据清洗与矩阵计算 | numpy, pandas |
支持预编译轮子 | 完全支持 | 注意控制测试数据集在 50MB 以内 |
| 静态图表绘制 | matplotlib, seaborn |
支持 (渲染为页面 Canvas) | 支持 (需导出图片后预览) | 在网页端注意避免使用交互式 plt.show() 阻塞 |
| 外网爬虫与数据采集 | requests, scrapy |
极度受限 (受制于 CORS) | 视平台网络白名单而定 | 简单抓取选支持联网的容器;严谨项目用本地环境 |
| 桌面客户端界面 (GUI) | tkinter, PyQt, kivy |
不支持 | 不支持 (无显示器服务) | 必须在本地操作系统安装 Python 执行 |
| 深度学习大模型推理 | torch, tensorflow |
极度受限 (包体积庞大) | 支持 CPU 版 (缺少显卡加速) | 选用带 GPU 算力配额的云端专用 Notebook |
使用建议与决策总结
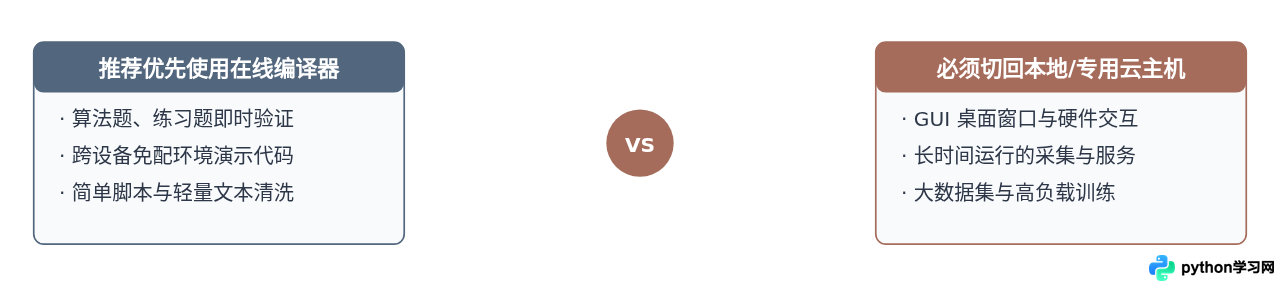
在线 Python 编译器最适合的定位是轻量级沙盒。当你需要验证一段正则表达式的正确性、向同事实时演示一个算法函数、调试一小段数据转换逻辑,或是指导编程入门时,在线平台开箱即用的体验无可替代。
但在选型时应掌握一条清晰的判断链路:当你发现代码必须依赖外部真实硬件交互、需要启动后台长连接监听服务、依赖未编译进 Wasm 的冷门原生 C 扩展,或者需要长时间处理大规模数据集时,不要试图在在线编译器的各种限制之间“绕道走”。这时候停下来,在本地配置一个轻量的虚拟环境,或者部署一个完整的远程开发容器,才是更稳妥、高效的工程选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















