


scikit-learn1.6的FrozenEstimator是干什么的?
深入解析 scikit-learn 1.6 新增的 FrozenEstimator 元估计器:核心功能、工作原理、为什么弃用 cv='prefit'、方法分发机制以及在概率校准与阈值调整中的完整实战代码与选型指南。
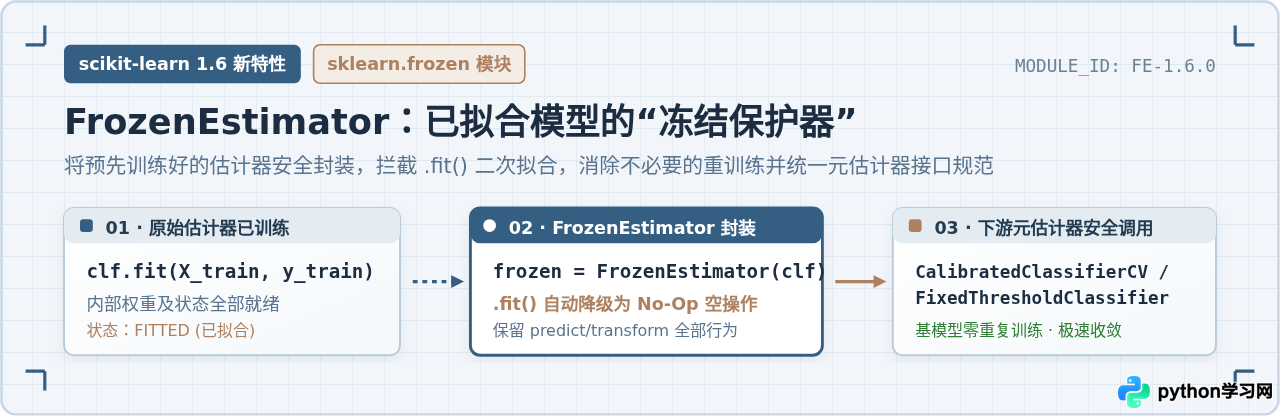
sklearn.frozen 模块中正式引入了 FrozenEstimator。它是一个专为“已训练模型”设计的包装元估计器(Meta-Estimator)。当一个已经拟合完毕的模型被 FrozenEstimator 包裹后,任何对其调用的 .fit() 操作都会直接变成“空操作”(No-Op),从而安全保护内部模型参数不被重新拟合或意外覆盖;与此同时,它对外完整保留并代理了原模型的 predict、predict_proba、transform 以及属性访问能力。这一机制彻底解决了在流水线、概率校准和决策阈值调优时预训练模型被重复拟合的历史难题。
一、为什么需要 FrozenEstimator:历史痛点与设计背景
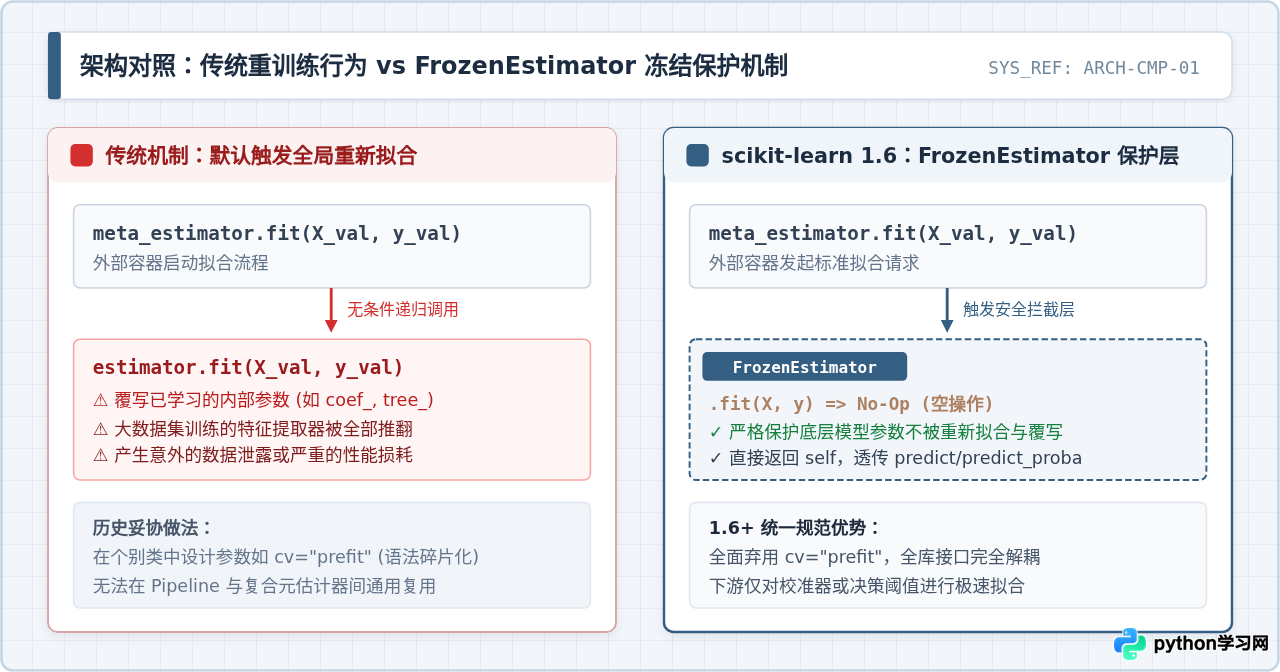
在 scikit-learn 过去的架构设计中,“状态可变性”与“无条件重新拟合”是复合估计器的默认行为法则。无论是 Pipeline、FeatureUnion,还是诸如 StackingClassifier、CalibratedClassifierCV 等元估计器,其顶级容器在调用 .fit(X, y) 时,都会无条件对内部持有的每一个子估计器触发 .fit()。
这种设计在端到端从零训练单数据集模型时非常简洁,但在现代机器学习工程中,许多实际业务需要分步拟合或复用预训练模型:
- 概率校准场景:模型已经在大规模训练集上充分拟合,现在需要使用保留的校准验证集(Validation Set)拟合概率校准器(如 Platt 缩放或等保回归)。在此之前,如果把基模型直接传进
CalibratedClassifierCV,调用.fit()会直接把辛苦训练好的基模型用小样本验证集冲刷覆盖。 - 决策阈值调优场景:在非均衡分类任务中,模型权重保持不变,工程师仅希望在验证集上通过
FixedThresholdClassifier或TunedThresholdClassifierCV计算最佳决策阈值。 - 特征工程部分冻结:流水线前端包含耗时巨大的预提取特征器(如大型特征降维模型或预训练嵌入模型),下游分类器在进行网格调参时,不希望上游特征器反复重新拟合。
在 1.6 之前,scikit-learn 针对此类需求的做法非常碎片化。最典型的妥协产物就是 CalibratedClassifierCV 中的 cv="prefit" 参数。这种设计存在严重的工程缺陷:
- 语义割裂:
cv参数本意是定义交叉验证折数(如cv=5),却被强行塞入"prefit"字符串来表达“模型已经预先拟合”,破坏了接口契约。 - 不可迁移:这种私有参数只存在于少数几个类中,在通用
Pipeline或其他元估计器中根本无法使用。 - 缺乏保护机制:外部代码缺乏显式声明,易发生隐式重训练导致脏数据泄露。
scikit-learn 1.6 引入的 FrozenEstimator 从底层抽象上统一了该行为,并且官方在 1.6 中正式将 cv="prefit" 标记为弃用(Deprecated),全面推荐使用 FrozenEstimator。
二、FrozenEstimator 的核心工作机制
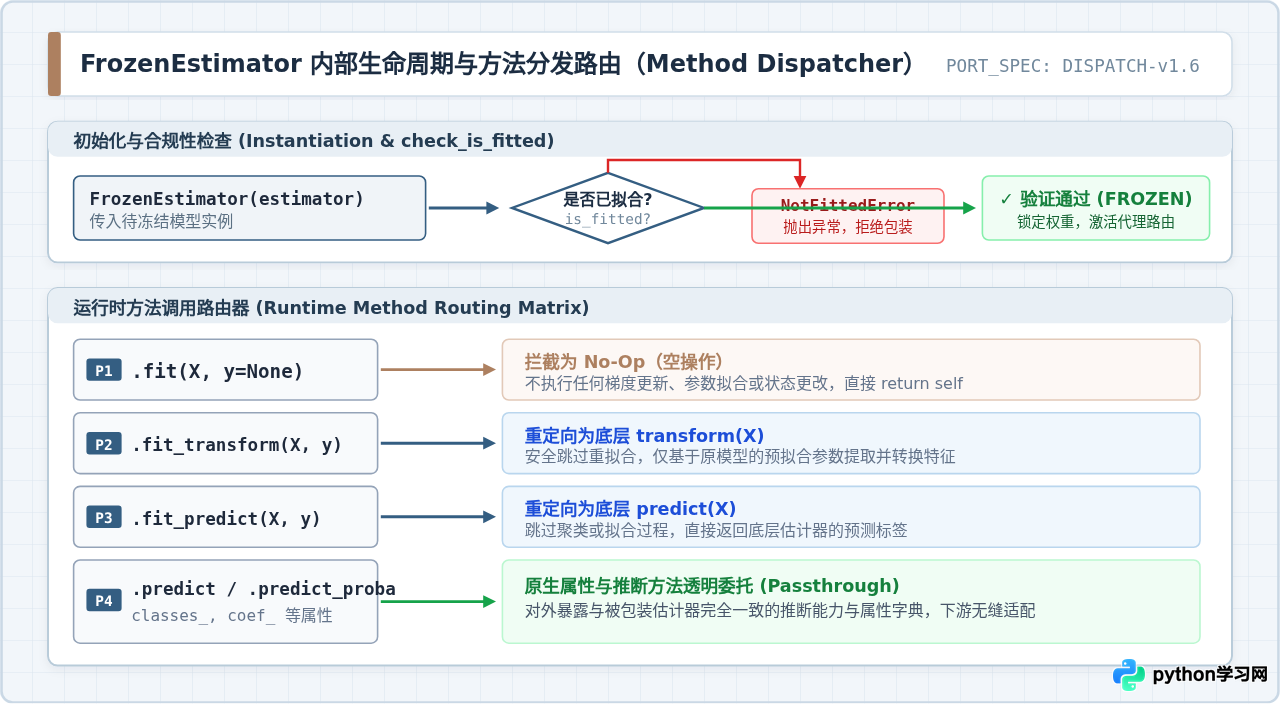
FrozenEstimator 在内部扮演了类似于“防篡改代理(Proxy Decorator)”的角色。它的运行机制可以拆解为初始化安全性检验与运行时方法智能分发两部分。
1. 强制状态校验:拒绝未拟合对象
当实例化 FrozenEstimator(estimator) 时,它会主动通过 check_is_fitted(estimator) 探测被包装对象的内部状态。如果开发者传入了一个尚未经过 .fit() 的裸模型,系统会立即抛出 sklearn.exceptions.NotFittedError。这一机制确保了只有已就绪的模型才能被冻结,从根本上防止了“空模型被冻结后直接推断”的静默逻辑故障。
2. 方法调用路由(Method Dispatcher)
一旦封装完成,FrozenEstimator 拦截并重新分配了常见 scikit-learn API 行为:
.fit(X, y=None, **fit_params):执行空操作(No-Op)。它会直接忽略传入的特征矩阵与标签,不计算任何梯度,不更新任何权重,仅仅返回self。.fit_transform(X, y=None, **fit_params):智能重定向。对于特征转换器,它会绕过拟合逻辑,直接将调用路由到原始对象的.transform(X)方法。.fit_predict(X, y=None, **fit_params):直接降级为调用原始对象的.predict(X)方法。- 推断方法透传:外部调用
.predict()、.predict_proba()、.decision_function()等方法时,完全透明地委托给底层模型。 - 属性无损代理:底层的学习属性(如
classes_、coef_、feature_names_in_等)通过属性代理无缝暴露给下游。
三、实战演示:典型应用场景与代码实现
以下代码演示在 scikit-learn 1.6+ 环境下,如何使用 FrozenEstimator 完成概率校准以及后验决策阈值调优。
scikit-learn >= 1.6.0。你可以通过 python -c "import sklearn; print(sklearn.__version__)" 查看当前版本。
场景一:标准化概率校准(替代已弃用的 cv="prefit")
这是 FrozenEstimator 最主要的使用场景。我们首先在大数据集上训练逻辑回归分类器,随后在校准数据集上仅训练校准曲线:
# 环境:Python 3.9+,scikit-learn >= 1.6.0
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.calibration import CalibratedClassifierCV
from sklearn.frozen import FrozenEstimator

# 1. 构建模拟分类数据并划分为训练集、校准集和测试集
X, y = make_classification(n_samples=2000, n_features=20, random_state=42)
X_train, X_temp, y_train, y_temp = train_test_split(X, y, test_size=0.4, random_state=42)
X_calib, X_test, y_calib, y_test = train_test_split(X_temp, y_temp, test_size=0.5, random_state=42)

# 2. 正常训练基础分类器
base_clf = LogisticRegression(random_state=42)
base_clf.fit(X_train, y_train)

# 3. 使用 FrozenEstimator 锁定基模型权重
frozen_clf = FrozenEstimator(base_clf)

# 4. 接入 CalibratedClassifierCV(1.6 推荐新写法)
# 注意:无需再写已废弃的 cv="prefit",直接传入冻结模型
calibrated_clf = CalibratedClassifierCV(estimator=frozen_clf, method="sigmoid")

# 5. 在独立的校准集上进行拟合(base_clf 不会被重新训练)
calibrated_clf.fit(X_calib, y_calib)

# 6. 在测试集评估输出校准概率
probs = calibrated_clf.predict_proba(X_test)
print(f"校准预测概率样例(前3个样本):\n{probs[:3]}")[[0.14120938 0.85879062]
[0.78912301 0.21087699]
[0.05234195 0.94765805]]
场景二:与决策阈值调整器(FixedThresholdClassifier)协同
在很多风控或故障诊断业务中,正负样本代价不均,我们需要将决策阈值从默认的 0.5 调整为 0.8。配合 FrozenEstimator,可以确保阈值模型只执行边界判断,而零成本复用原模型:
from sklearn.model_selection import FixedThresholdClassifier

# 将已冻结的模型包装进阈值微调分类器中,设定判定门限为 0.8
threshold_clf = FixedThresholdClassifier(
    estimator=frozen_clf,
    threshold=0.8
)

# 拟合阈值包装器(此时不会对内部 base_clf 产生任何额外训练)
threshold_clf.fit(X_calib, y_calib)

# 测试集推断,仅当正类概率 >= 0.8 时判定为类别 1
predictions = threshold_clf.predict(X_test)
print(f"阈值调整后前 10 个预测结果: {predictions[:10]}")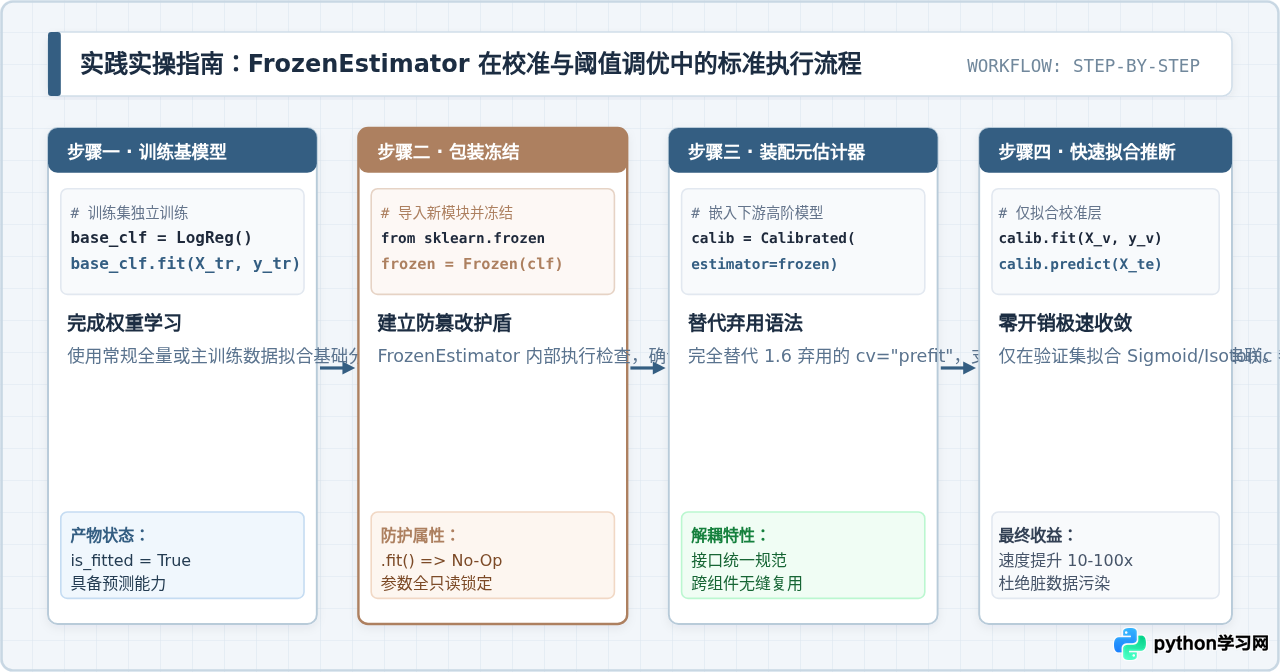
四、使用注意事项与避坑指南
在将旧代码迁移至 FrozenEstimator 或构建复杂 Pipeline 时,需要特别注意以下四个细节:
如果你在调用
FrozenEstimator(model) 前忘记执行 model.fit(...),代码会在初始化或下游首次访问时抛出 NotFittedError: This FrozenEstimator instance is not fitted yet。记住口诀:先 fit 再 freeze。
1. 超参数搜索中的行为界限
当你在 GridSearchCV 或 RandomizedSearchCV 的参数网格中包含一个 FrozenEstimator 时,必须清楚:被冻结步骤的内部参数不会在搜索过程中更新。如果你希望调优基模型的超参数,应当将原始估计器放入网格;如果你希望调优的是下游元估计器(如校准方法或阈值),此时使用 FrozenEstimator 包裹基模型可以显著成倍减少网格搜索的耗时。
2. 对象深拷贝(Cloning)行为
scikit-learn 内部大量使用 sklearn.base.clone。对 FrozenEstimator 进行 clone() 时,scikit-learn 会正确处理包装层关系。但需要注意,如果下游组件尝试对其进行二次深度克隆并重拟合,克隆后的副本仍然是一个被冻结的对象,依然保持 .fit() 为空操作。
3. 模型持久化兼容性
FrozenEstimator 原生支持通过 joblib.dump 和 pickle 进行序列化。保存后的模型文件包含了底层模型的全部固定权重,恢复后依然保持冻结状态,适合直接部署在生产推断微服务中。
五、新旧方案选型与技术演进对比
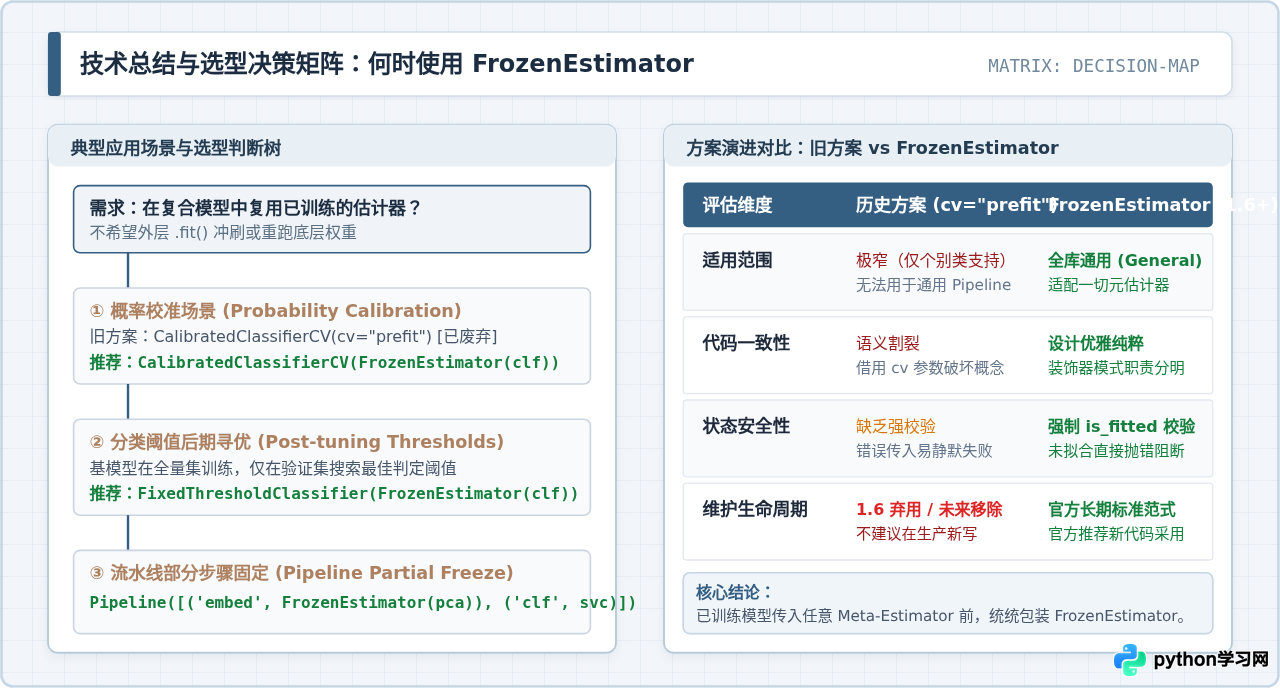
为了帮助开发者准确评估迁移收益,下表总结了 scikit-learn 1.6+ 推荐的 FrozenEstimator 方案与以往方案的维度差异:
| 对比维度 | 历史做法 A:cv="prefit" | 历史做法 B:手写 No-Op 类 | 1.6+ 官方方案:FrozenEstimator |
|---|---|---|---|
| 适用组件范围 | 仅限少数类(如 CalibratedClassifierCV) | 需开发者自行维护,容易漏写委托方法 | 全库通用,适配一切元估计器与 Pipeline |
| API 规范性 | 语义混淆,用 cv 传递状态参数 | 非官方实现,跨环境兼容性极差 | 优雅的装饰器设计模式,职责高度解耦 |
| 拟合前置检查 | 偶有逻辑漏洞,无法统一拦截 | 取决于手写代码质量 | 强制 check_is_fitted 严格校验 |
| 版本维护状态 | 1.6 弃用,未来版本将彻底移除 | 第三方技术债务 | 官方核心维护模块(sklearn.frozen) |
六、总结
FrozenEstimator 在 scikit-learn 1.6 中的推出,标志着 scikit-learn 元估计器架构的一次重大规范化重构。它虽然概念直观——通过空操作拦截保护已拟合模型,却从根本上根治了长久以来 cv="prefit" 带来的接口割裂问题,使得模型在分步训练、概率校准、决策阈值后验优化及特征工程复用等复杂场景下,能够以标准化、类型安全且高性能的方式自由组合。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















