


Python正则表达式贪婪与非贪婪匹配怎么控制
深入讲解Python正则表达式中贪婪与非贪婪匹配的控制方法、问号修饰符语法、引擎回溯原理、实战代码对比与避坑指南。
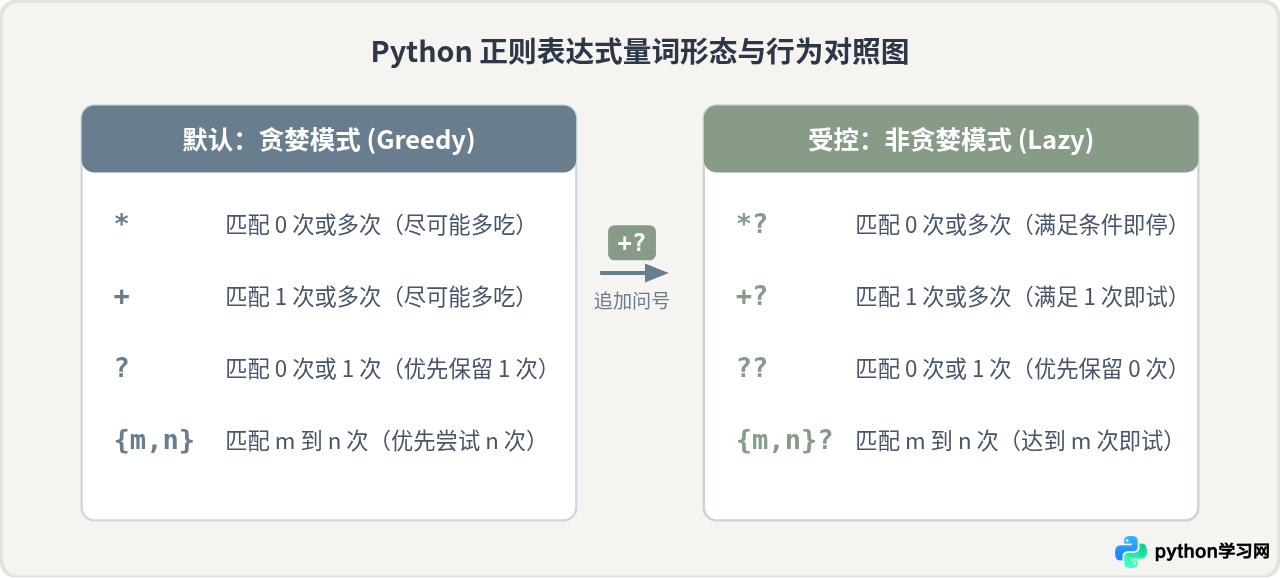
re 模块中,控制贪婪与非贪婪匹配的核心方法就是在量词后面紧跟一个英文问号 ?。默认情况下,量词(如 *、+、?、{m,n})是贪婪的,倾向于尽可能多地吞入字符;一旦在其后追加 ?(变为 *?、+?、??、{m,n}?),引擎便切换为非贪婪模式,在满足最低匹配要求的前提下立刻停下。
一、量词背后的两种机制:贪婪与非贪婪的区别
在使用正则表达式处理文本时,我们经常需要匹配位于两个特定标记之间的内容。例如提取括号内的文字、HTML 标签中的节点内容,或是两个双引号之间的字符串。此时若不加控制,默认的量词往往会产生“跨界过度匹配”的问题。
这种现象源于正则表达式引擎的匹配策略:
- 贪婪匹配(Greedy):这是 Python 正则的默认行为。当引擎遇到量词时,会尝试一直吃进尽可能多的文本,直到遇到行尾或无法匹配的边界,然后通过向左“回溯”找到符合整个表达式的最长子串。
- 非贪婪匹配(Non-greedy / Lazy):也称为惰性匹配或勉强匹配。引擎在每吃进一个字符时,都会优先尝试让后续表达式进行匹配。只要达到满足整体匹配的最低限度,它就立即结束当前量词的消耗,因此匹配到的是最短子串。
二、实战代码对比:控制符号的具体效果
为了直观看到贪婪与非贪婪的具体差异,我们来看一段处理 HTML 字符串的代码。假设目标是从文本中提取出各个 <span> 标签内的文本。
import re

text = '<span class="tag">Python</span><span class="tag">Regex</span><span class="tag">Tutorial</span>'

# 1. 贪婪匹配:使用 .*
pattern_greedy = r'<span.*?>(.*)</span>'
result_greedy = re.findall(pattern_greedy, text)
print("贪婪模式提取结果:", result_greedy)

# 2. 非贪婪匹配:使用 .*?
pattern_lazy = r'<span.*?>(.*?)</span>'
result_lazy = re.findall(pattern_lazy, text)
print("非贪婪模式提取结果:", result_lazy)
非贪婪模式提取结果: ['Python', 'Regex', 'Tutorial']
在贪婪模式中,中间的 (.*) 从第一个 > 之后开始吞入文本,一口气吞到了最末尾的 Tutorial</span>。为了让整个表达式以 </span> 结尾,它只向左吐回了最后一个 </span>,把中间的标签结构全部吞作了内容。
而在非贪婪模式 (.*?) 中,量词 *? 在每吞入一个字符后,就立刻询问后续的 </span> 能否成立。当到达 Python 之后的 </span> 时,匹配立刻成功并截断,从而能够准确按标签提取出三段独立的文本。
三、引擎底层原理:吞噬回溯与渐进探查
理解正则引擎在贪婪与非贪婪状态下的工作逻辑,能够帮助我们在面对复杂长文本时写出性能更优、更可靠的表达式。
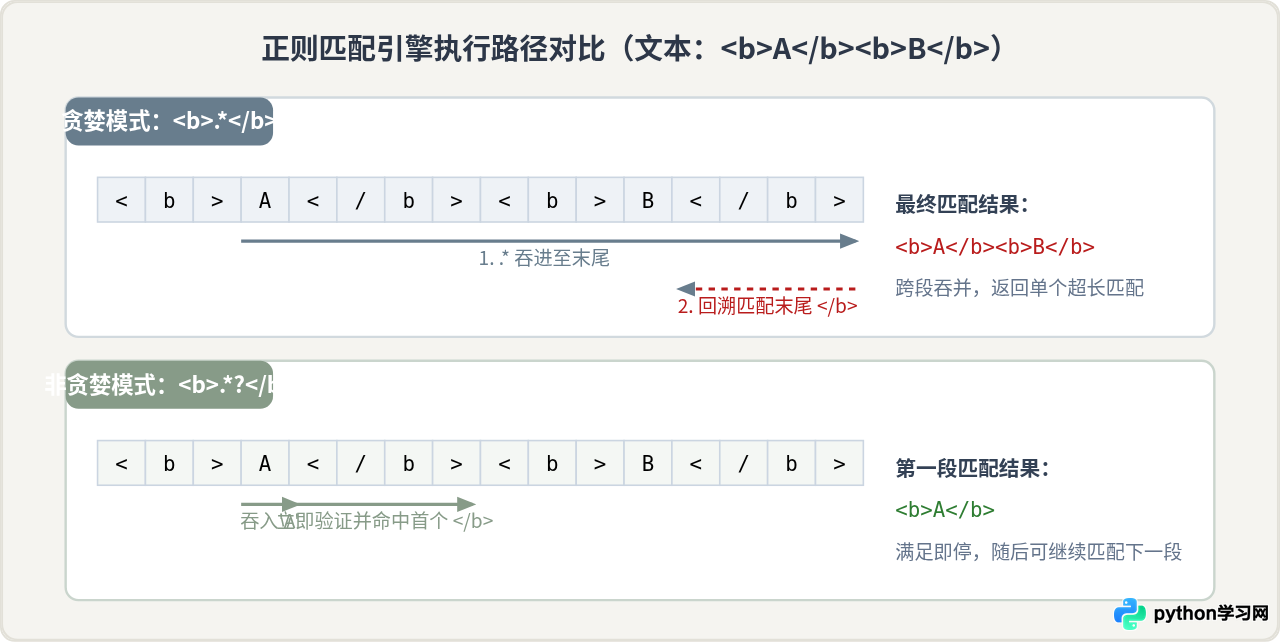
从执行过程可以看出两者在效率和行为上的差异:
- 贪婪模式发生回溯:贪婪量词会一直向右走,直到文本走完或遇到硬性约束,然后再回头逐步释放字符以迎合后面的模式。当文本非常庞大时,大量的回溯会产生明显的性能损耗。
- 非贪婪模式逐步试探:非贪婪量词每前进一步,就试探一次后面的条件是否成立。只要成立立刻锁定结果,不会越过最近的定界符。
四、精准控制正则匹配的四步实操流程
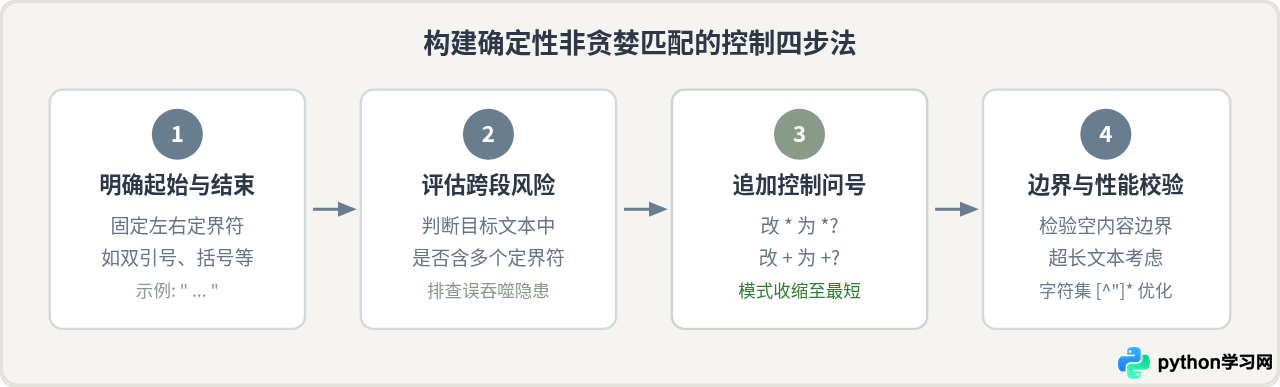
在实际开发中,要想写出既精准又高效的正则匹配,可以按照以下四个步骤进行构思与控制:
进阶对比:非贪婪 .*? 与排除型字符集 [^"]*
在提取两端封闭的简单文本时,虽然 .*? 能够实现非贪婪效果,但使用排除型字符类通常是更优雅且性能更好的选择。例如提取双引号中的字符串:
| 对比维度 | 非贪婪方案:"(.*?)" |
排除型字符集:"([^"]*)" |
|---|---|---|
| 匹配原理 | 每前进一个字符都需要尝试匹配后续的双引号。 | 直接吞入所有非双引号字符,天然在双引号前停止。 |
| 回溯消耗 | 如果字符串末尾缺少闭合引号,会引发连续回溯。 | 无回溯风险,状态机单向流转,性能极高。 |
| 适用场景 | 结束标记为多字符(如 </div>、-->)。 |
结束标记为单个特定字符(如 "、'、,)。 |
五、容易混淆的关键陷阱与注意事项
陷阱 1:问号 ? 的“一符两用”
在正则表达式中,问号 ? 既可以独立作为量词(表示匹配前面的元素 0 次或 1 次),也可以作为模式修饰符附着在量词后面(表示非贪婪)。例如:
• a?:贪婪模式,表示匹配 0 次或 1 次 'a',但如果有 'a' 则优先吃进 1 次。
• a??:非贪婪模式,同样表示 0 次或 1 次,但优先保留 0 次,只有后续匹配失败时才会退求其次匹配 1 次。
陷阱 2:非贪婪不是“全局最短匹配”,依然遵循“先到先得”
许多初学者误以为非贪婪模式会在整段文本中寻找字数最少的一段,这是错误的。正则表达式引擎从文本最左侧开始扫描,左侧的起始点一旦确定,非贪婪仅控制右侧结束点尽可能靠前。
例如在文本 "abc123def" 中用 \d+? 匹配,结果依然是 1 而不是整个字符串里更靠后的某个位置。它不会跳过左侧的首先匹配项。
陷阱 3:跨行模式下的边界穿透(re.DOTALL / re.S)
默认情况下,点号 . 不匹配换行符 \n。如果不小心开启了 re.DOTALL(或 re.S)参数,.*? 将会跨过多行匹配。如果文本结构中缺少预期的结束标记,它可能会一路匹配到文档最末尾,产生意想不到的超长抓取。
六、核心要点总结
掌握贪婪与非贪婪的控制,关键在于根据目标边界的确定性来选择最合适的量词与修饰符。
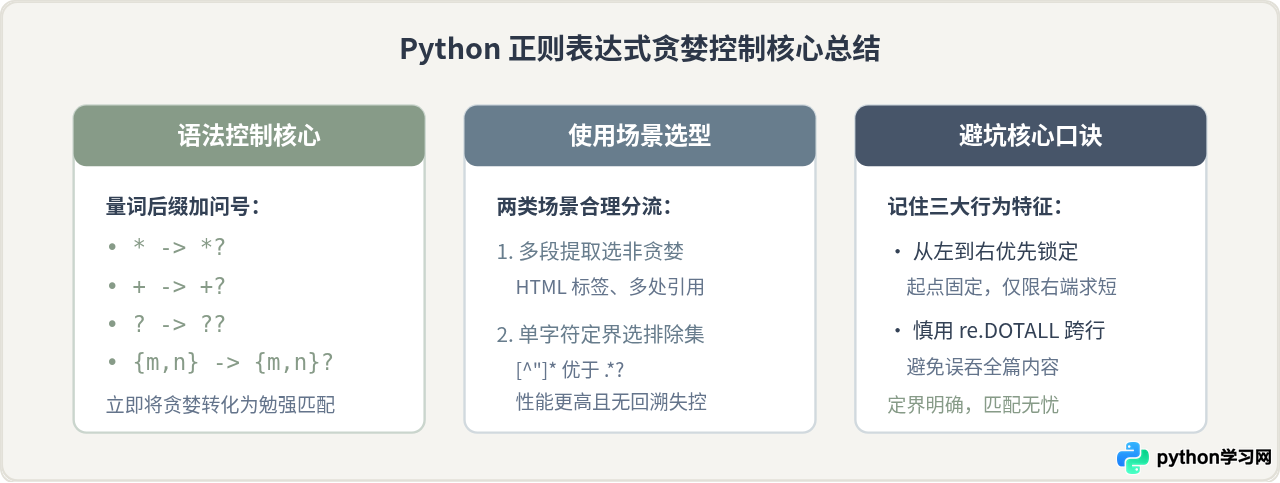
总结来说,想要在 Python 正则表达式中精确控制匹配范围,只需要在相应量词后加入 ? 即可将贪婪转为非贪婪。同时,面对常见的单字符闭合结构时,优先采用排除型字符类(如 [^">]*),能够使你的正则表达式在准确性与执行效率上都更加健壮。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















