


python必背源代码Lock锁防竞态代码
深入解析Python多线程编程中互斥锁Lock防止竞态条件的核心必背源代码,剖析GIL下的字节码交错原理、with上下文管理器机制与死锁防范实战。
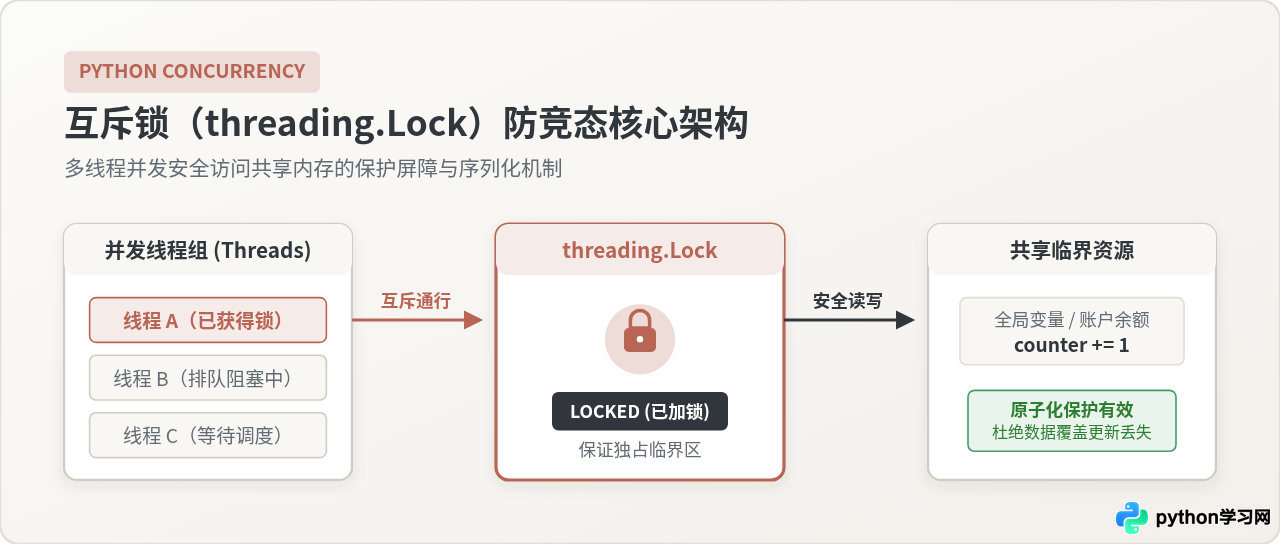
在 Python 多线程并发编程中,当两个或多个线程并发读写同一个共享变量(如全局累加器、库存数量、订单金额等)时,由于操作系统线程调度的不可预测切换,极易导致写入覆盖与数据错乱,这种现象被称为竞态条件(Race Condition)。解决该问题的标准核心手段,是使用标准库 threading.Lock(互斥锁)。通过将修改共享状态的代码放入锁保护的临界区内,确保任何时刻只有一个线程能够执行这部分逻辑,从而彻底消除竞态条件。
一、核心必背源代码模板
编写防竞态代码时,最关键的是遵循异常安全原则。在现代 Python 规范中,推荐使用上下文管理器(with 语句)来操作互斥锁,这是每一位 Python 开发者都必须熟练背诵的工业级核心代码:
import threading

# 1. 实例化全局或类级别的互斥锁对象
data_lock = threading.Lock()

# 共享可变资源
shared_counter = 0

def safe_increment(step: int = 1):
    """
    通过互斥锁安全累加共享变量的必背标准函数
    """
    global shared_counter
    # 2. 使用 with 语句自动获取锁并在退出时自动释放
    with data_lock:
        # 3. 临界区:独占读写共享数据
        shared_counter += step
千万不要把锁的创建语句写在工作函数内部。互斥锁必须在所有线程可共同访问的作用域内(如模块级变量或类的实例属性)只创建一次;如果每个线程在自己的函数里各自 Lock(),彼此操作的不是同一个锁对象,互斥机制就会完全失效。
二、为什么 GIL 无法阻止竞态条件
不少初学者存在一个严重误区:“既然 Python 拥有全局解释器锁(GIL),保证了同一时间只有一个线程在执行字节码,为什么多线程还会发生竞态条件?”
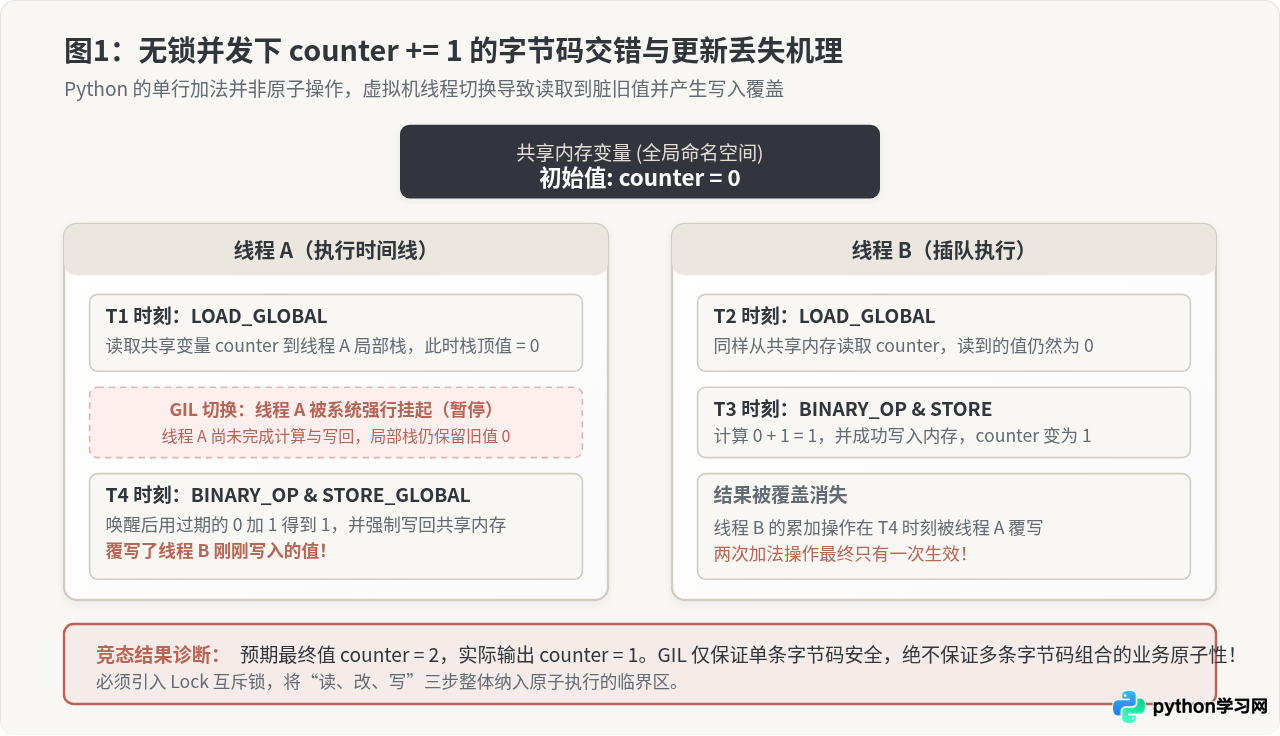
答案在于:GIL 仅保证虚拟机内部单个字节码指令的原子性,但不保证多条字节码组合成的业务逻辑的原子性。在 Python 中,看似最简单的一行 counter += 1,在解释器底层实际上被拆解为三条独立的字节码指令:
LOAD_GLOBAL:从全局内存将当前counter的值读入当前线程的求值栈;BINARY_OP/BINARY_ADD:在栈顶将数值加 1;STORE_GLOBAL:将加 1 后的新值重新写回全局内存。
当多个线程并发运行时,Python 虚拟机会在执行一定数量的字节码或遇到 I/O 操作时主动释放 GIL 并触发线程切换。如果线程 A 刚执行完第 1 步读取到数值 0,就被操作系统强行挂起并切换到了线程 B;线程 B 完整执行了读取 0、计算 1、写回 1 的过程;当线程 A 重新获得 CPU 时,它仍保留着之前读取的旧值 0,继续完成计算并把 1 写回内存——这就导致线程 B 的累加结果被彻底抹去。
三、Lock 互斥锁的工作流程与运行状态
互斥锁 threading.Lock 在操作系统层面充当了一个二元信号量,其内部仅维护两种状态:锁定(LOCKED)与未锁定(UNLOCKED),并维护一个等待该锁的线程阻塞队列。
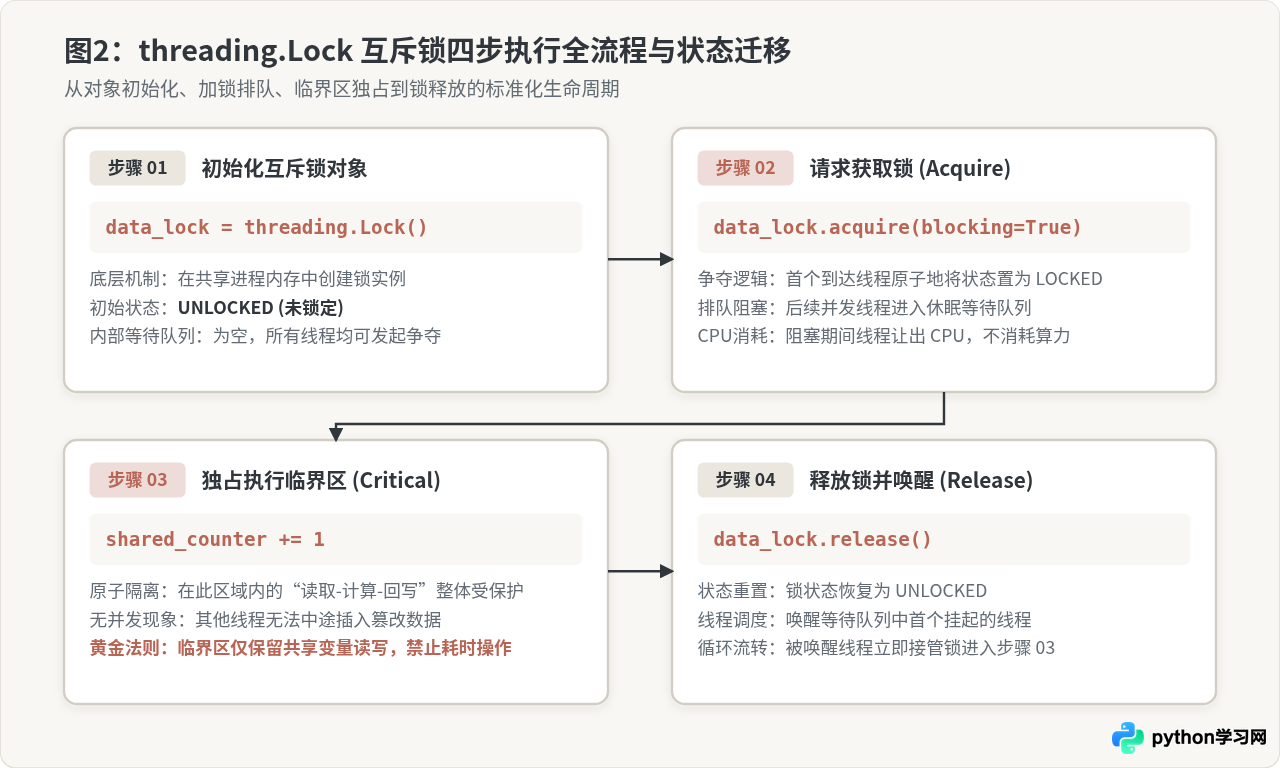
它的完整生命周期由四个确定性阶段构成:
- 步骤 1(初始化):调用
data_lock = threading.Lock()时,锁处于 UNLOCKED 状态,内部等待队列为空。 - 步骤 2(请求获取):当线程调用
acquire()时,若锁当前为 UNLOCKED,该线程原子性地将锁置为 LOCKED 并立即向下执行;若锁已经被其他线程持有,当前线程会被系统放入阻塞队列并挂起,让出 CPU 执行权,处于休眠等待状态。 - 步骤 3(临界区独占):持有锁的线程独占访问临界区内的共享数据,任何其他线程都无法介入修改,确保了“读-改-写”全过程的完整原子性。
- 步骤 4(释放与唤醒):持有锁的线程调用
release()时,锁状态恢复为 UNLOCKED,同时系统自动唤醒等待队列头部的线程,被唤醒的线程重新获取锁并继续执行。
四、两套核心代码范式深度对比
在实际编码中,实现互斥锁保护有两种主流写法:一种是推荐的 with data_lock: 上下文管理器语法;另一种是底层的 try...finally 手动结构。
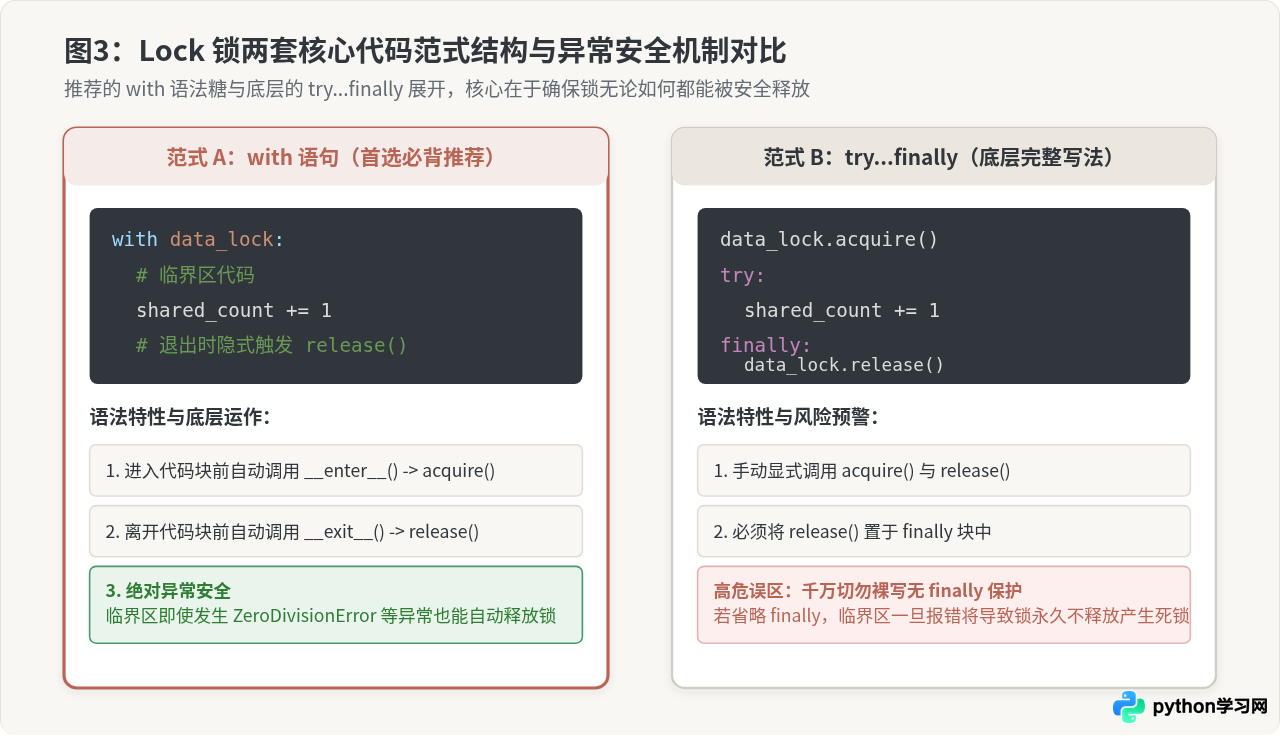
为了让读者彻底理解两者的等价性与内部机制,以下列出两套代码的完整实现形式:
1. 首选范式:上下文管理器(with 语句)
# 范式 A:推荐的工业级简洁写法
with data_lock:
    # 无论此处正常返回还是抛出异常,都会确保释放锁
    user_account['balance'] -= withdrawal_amount
threading.Lock 对象内部实现了 __enter__() 和 __exit__() 魔术方法。进入 with 代码块时自动调用 acquire(),离开代码块(包括遇到 return、break 或抛出未捕获异常)时无条件调用 release()。代码结构紧凑,消除了因疏忽导致锁未释放的隐患。
2. 底层范式:try...finally 结构
# 范式 B:底层的显式展开写法(与 with 语句语义等价)
data_lock.acquire()
try:
    user_account['balance'] -= withdrawal_amount
finally:
    # 无论 try 块发生何种异常,finally 中的 release 必被执行
    data_lock.release()
绝对不要编写形如 data_lock.acquire(); user_account['balance'] -= withdrawal_amount; data_lock.release() 的裸调用代码。如果中间的扣款逻辑因为键不存在、除以零或网络超时抛出异常,后续的 release() 将永远不会被执行。该锁将被永久锁定,所有后续排队的线程全被死死卡住,导致整个程序死锁瘫痪。
五、可运行的竞态与防竞态对比验证
为了直观验证加锁前后的实际差异,我们可以运行下面的完整测试脚本。该脚本创建 10 个线程,每个线程循环累加 100,000 次,理论上的累加总量应为 1,000,000:
import threading

NUM_THREADS = 10
ITERATIONS = 100_000

# 测试 1:无锁并发(必现竞态条件)
unsafe_counter = 0

def unsafe_worker():
    global unsafe_counter
    for _ in range(ITERATIONS):
        unsafe_counter += 1

threads = [threading.Thread(target=unsafe_worker) for _ in range(NUM_THREADS)]
for t in threads:
    t.start()
for t in threads:
    t.join()

print(f"[无锁测试] 预期值: {NUM_THREADS * ITERATIONS}, 实际值: {unsafe_counter}")

# 测试 2:使用 Lock 锁防竞态(严格准确)
safe_counter = 0
mutex = threading.Lock()

def safe_worker():
    global safe_counter
    for _ in range(ITERATIONS):
        with mutex:
            safe_counter += 1

threads = [threading.Thread(target=safe_worker) for _ in range(NUM_THREADS)]
for t in threads:
    t.start()
for t in threads:
    t.join()

print(f"[加锁测试] 预期值: {NUM_THREADS * ITERATIONS}, 实际值: {safe_counter}")
执行输出示例(不同计算机环境数值略有浮动):
[无锁测试] 预期值: 1000000, 实际值: 418293
[加锁测试] 预期值: 1000000, 实际值: 1000000
可以看到,无锁状态下由于大量的写入覆盖,最终结果严重丢失超过 50%;而在加入 threading.Lock 之后,即使线程数量与计算量成倍增加,最终结果依然精准无误。
六、防竞态技术选型与避坑准则
锁虽然解决了数据安全性问题,但也引入了执行串行化与死锁风险。根据业务场景选择正确的并发同步原语至关重要。
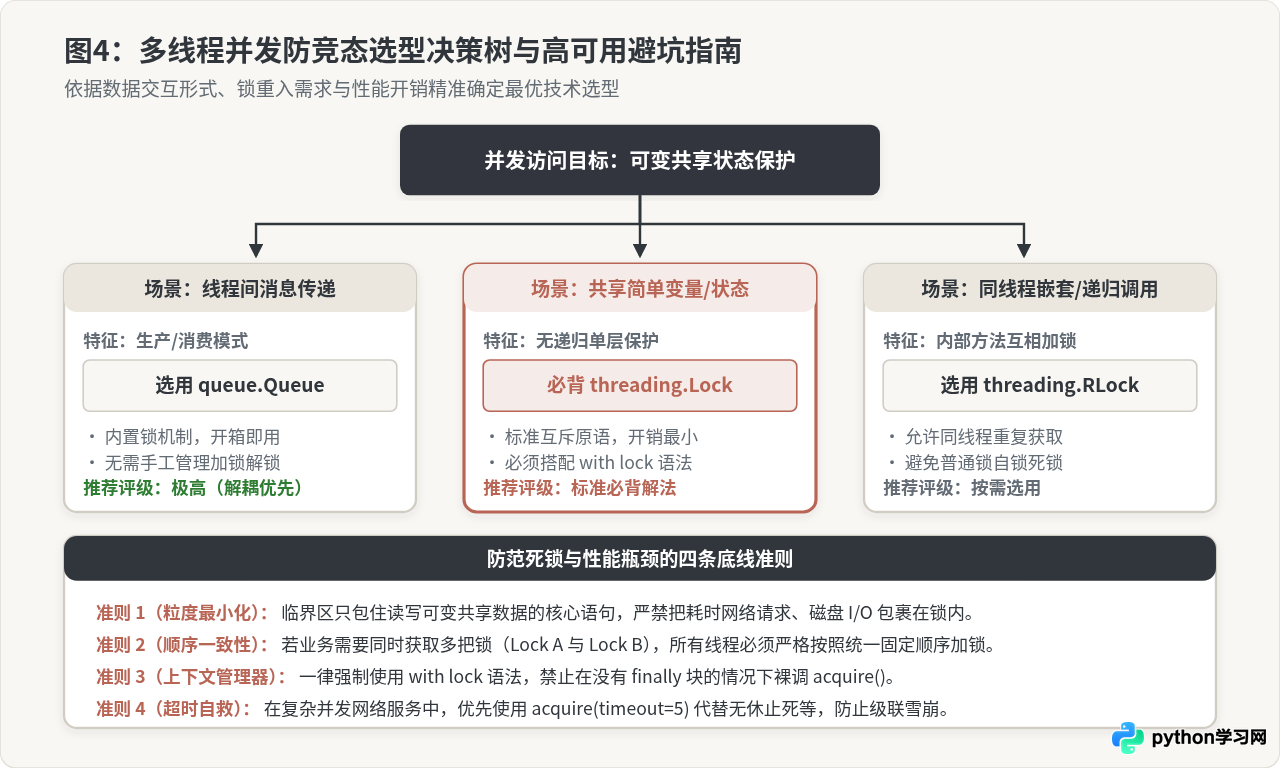
| 机制类型 | 适用场景 | 优点 | 注意事项与潜在代价 |
|---|---|---|---|
threading.Lock |
简单的全局或对象状态共享互斥修改 | 轻量高效,系统开销极小 | 同一线程重复 acquire 会导致自锁死锁 |
threading.RLock |
包含递归调用或内部方法相互调用的复杂对象 | 支持同一线程重复加锁,重入安全 | 比普通 Lock 稍有额外维护计数开销 |
queue.Queue |
多线程任务分发、流水线生产/消费模式 | 线程安全封装,无需手动加解锁 | 适合单向数据流动,不适合原地多路修改 |
实战开发必须恪守的四项法则
- 保持临界区尽量细小(Fine-Grained Locking):只在触碰共享资源的那两三行代码前后加锁。绝对不要把耗时的
time.sleep()、数据库查询、磁盘读写或第三方 HTTP 请求放在with lock内部,否则会导致所有并发线程全部排队等候,并发性能退化为甚至不如单线程。 - 固定获取多锁的次序:如果一个操作需要同时获取两个锁(例如账户 A 给账户 B 转账,需要同时锁住 A 和 B),系统内的所有线程必须严格按照统一的固定顺序(如按账户 ID 大小排序加锁)。若线程 1 先锁 A 再锁 B,线程 2 先锁 B 再锁 A,两者极易发生互相等待的死锁。
- 非阻塞与超时探测:在复杂生产环境中,若不想让线程无休止死等,可以给
acquire设置超时机制:got_lock = data_lock.acquire(timeout=3.0)。若超时未获得锁,可及时记录告警或执行重试降级逻辑,防止服务雪崩。 - 优先考虑消息传递:如果可以通过
queue.Queue将任务拆解为“生产者-消费者”模型,尽量采用队列通信代替共享状态竞争。不共享内存往往是避免竞态条件最优雅的架构选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















