


Python字符串逆序:切片[::-1]的原理与用法
深入解析Python使用切片[::-1]实现字符串逆序的原理与用法,剖析切片三元组、负步长寻址机制、边界默认值计算以及与reversed方案的性能对比。
在 Python 中将字符串逆序,最直接且高效的方法是切片表达式 s[::-1]。例如执行 "hello"[::-1] 即可得到 "olleh"。这种写法无需循环迭代,也没有额外的函数调用开销,直接依托底层 C 语言层级的内存复制完成逆序构建。本文详细解析该写法的语法结构、负步长索引寻址机制、边界省略时的判定规则及工程应用要点。
一、切片基本结构与 [::-1] 语法拆解
Python 序列切片的标准语法为 sequence[start:stop:step],由三个由冒号分隔的可选参数构成:
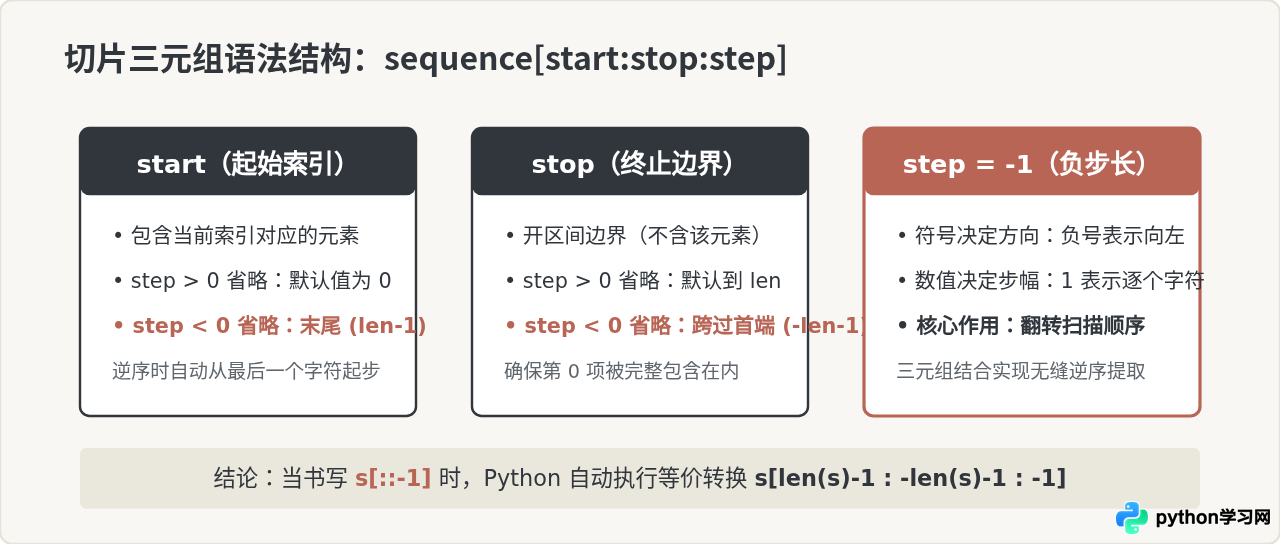
- start(起始索引):切片截取的起点下标。如果省略,其取值取决于步长的正负方向。
- stop(终止索引):切片截取的结束下标边界。切片区间遵循左闭右开规则,截取结果不包含该索引对应的元素。
- step(步长与步进方向):每次索引前进的步幅,其绝对值决定跳跃距离,符号决定扫描方向。正数表示从左向右(正向),负数表示从右向左(反向)。
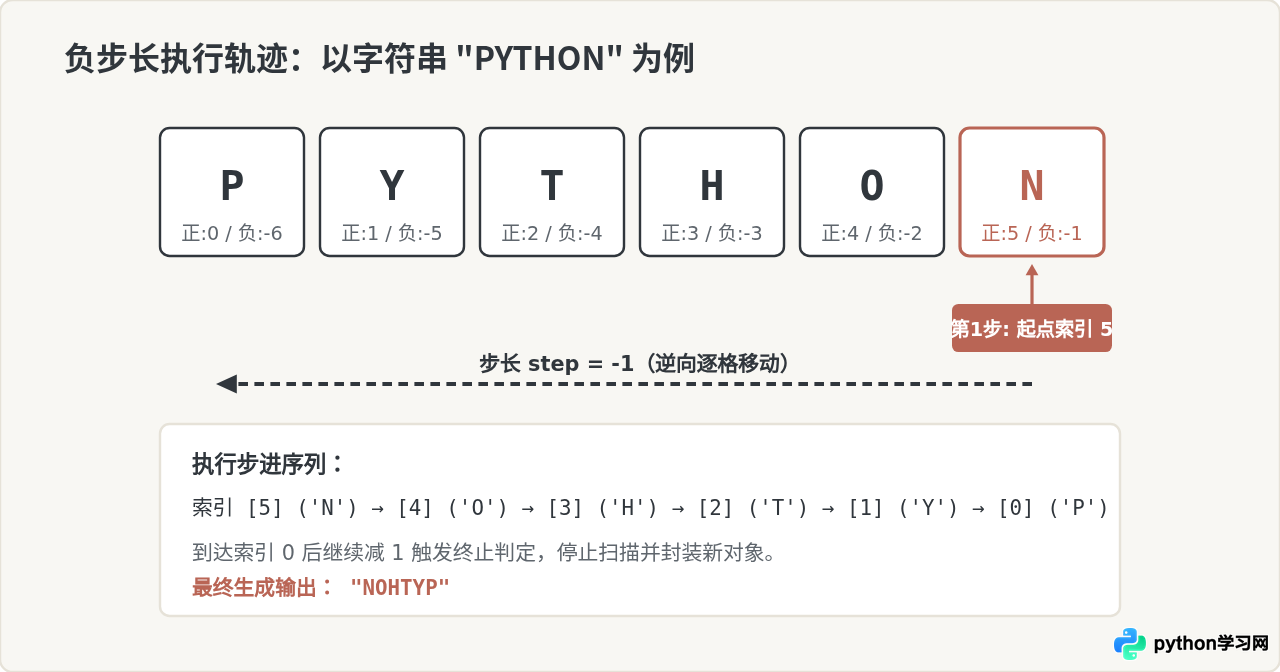
在表达式 s[::-1] 中,我们显式指定了 step = -1,同时省略了 start 和 stop。这意味着扫描方向变为逆向(从右向左),步幅为 1 个字符,并且遍历范围覆盖整段字符串。
二、负步长下的寻址机制与边界计算原理
初学者容易产生一个疑问:既然切片区间是左闭右开,当步长为负数时,Python 是如何判定遍历范围的?为什么手动写 s[0:5:-1] 会得到空字符串,而留空 s[::-1] 却能完美逆序?
要理解这一点,必须清楚 CPython 内部对切片边界的处理流程:
- 方向一致性要求:当
step > 0时,索引每次递增,要求start < stop才能截取有效区间;当step < 0时,索引每次递减,要求start > stop才能向前截取。如果手动指定start = 0且stop = 5,在step = -1的情况下,从 0 往左走无法到达 5,切片会立即判定为空并返回""。 - 默认边界的自适应映射:当省略
start时,如果step < 0,解释器不会将其设为 0,而是自动赋予末尾下标len(s) - 1;当省略stop时,若step < 0,解释器不能简单设为 0(否则第 0 个字符会因为开区间规则被排除),而是将stop设为一个超越左边界的虚值(概念上相当于-len(s) - 1或None标志),指示循环扫描直到索引 0 结束。
三、具体用法与常用开发场景
掌握了基本原理后,我们来看看在实际编码中有哪些常见应用场景。
1. 基础字符串整串翻转
这是最典型也是最简单的使用方式,直接将字符串实例赋给切片表达式:
# 示例 1:纯英文字符串翻转
original_text = "HelloWorld"
reversed_text = original_text[::-1]
print(reversed_text)  # 输出示例: dlroWolleH

# 示例 2:中文字符串翻转
chinese_text = "白日依山尽"
print(chinese_text[::-1])  # 输出示例: 尽山依日白
2. 回文字符串判断(Palindrome Check)
利用切片逆序与原字符串是否全等,可以在一行代码内优雅地完成回文校验:
def is_palindrome(s: str) -> bool:
    # 忽略大小写及空白字符后的回文判断
    cleaned = "".join(ch.lower() for ch in s if ch.isalnum())
    return cleaned == cleaned[::-1]

print(is_palindrome("Level"))                  # 输出示例: True
print(is_palindrome("A man, a plan, a canal: Panama"))  # 输出示例: True
print(is_palindrome("Python"))                 # 输出示例: False
3. 指定子区间的局部逆序
当需要限定在特定区间内逆向截取时,必须明确赋予 start 和 stop,且切记 start 必须位于右侧、stop 位于左侧:
s = "0123456789"
# 从索引 7(包含)向左截取到索引 2(不包含,即到 3 截止),步长为 -1
sub_rev = s[7:2:-1]
print(sub_rev)  # 输出示例: 76543
四、性能评估与不同逆序方案对比
在 Python 中,实现字符串逆序并非只有切片一种方式,常见的方式还包括 ''.join(reversed(s))、通过循环倒序累加或借助列表结构。在工程选型中,如何权衡这几种方法?
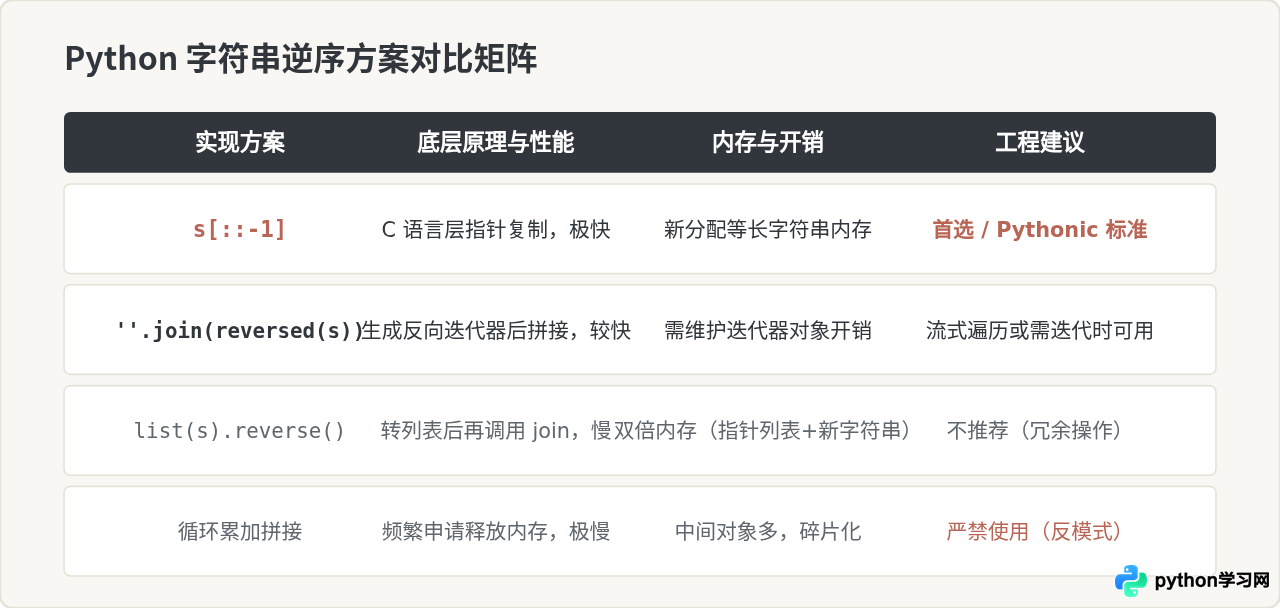
str 对象属于不可变对象(Immutable)。s[::-1] 之所以速度极快,是因为 CPython 在解析到步长为 -1 时,内部直接调用了底层优化的 C 函数,在预分配好目标长度的内存空间后,以高效率的指针从后向前逐字节/逐字符复制,完全避免了解释器循环解释字节码的开销。
五、注意事项与特殊场景陷阱
尽管 [::-1] 简便快捷,但在某些特定场景下需要保持谨慎:
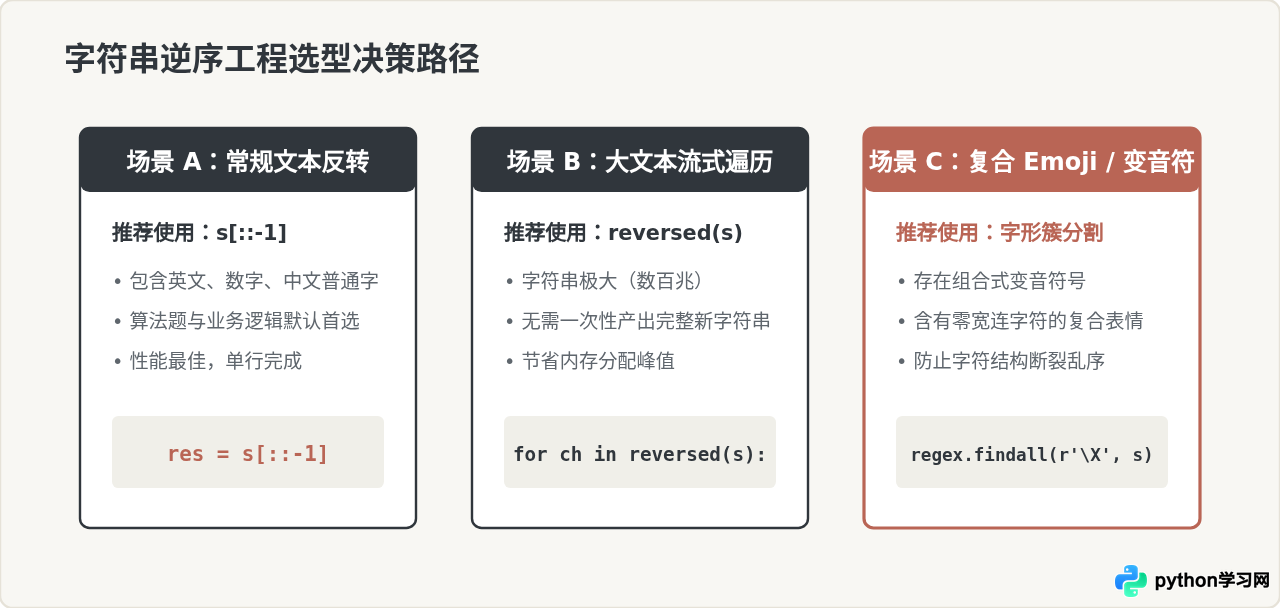
- Unicode 字形簇(Grapheme Clusters)问题:切片是以 Python 内部字符(Code Point)为单位分割的。如果文本中包含结合字符(如变音符号
e + ́ = é)或由零宽连字符(ZWJ)连接的复合 Emoji(例如某些家庭或职业 Emoji),直接使用[::-1]会将修饰符与原字符反序颠倒,导致文字变形或 Emoji 拆解为多个独立符号。处理此类多语言复杂字符时,应使用第三方regex库按照\X(扩展字形簇)分段反转。 - 内存占用考量:由于返回的是一个全新字符串,当处理体量在数百兆字节以上的超大字符串时,
s[::-1]会瞬间申请等量的连续内存空间。若仅仅是为了从后向前检查字符,应优先采用for char in reversed(s):进行惰性迭代。
六、总结与决策指引
切片 [::-1] 凝聚了 Python 语法简洁与执行高效的特点。在绝大部分常规场景下,它都是实现字符串逆序的最优解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















