


面试题:pandas3.0和NumPy2.0必须一起升级吗?

深入解析Python数据分析面试高频题:pandas 3.0 与 NumPy 2.0 是否必须一起升级。详细梳理版本依赖兼容矩阵、底层解耦原理、生产环境分步升级与依赖排错方案。
在 Python 数据科学与后端工程面试中,“pandas 3.0 和 NumPy 2.0 必须一起升级吗?”是一道极具辨识度的考题。很多开发者容易产生一种直觉误区:因为 pandas 长期将 NumPy 作为底层数组引擎,所以看到 NumPy 迎来历史性大版本 2.0,且 pandas 也迈入 3.0 时代时,就先入为主地认为两者必须成对打包、同步迁徙。面试官提出这一问题,往往不仅在考察候选人对具体版本号的了解,更是在检验其对底层二进制兼容性(ABI)、生态标准(SPEC 0 / NEP 29)以及生产环境依赖解耦策略的理解深度。
一、核心结论与双向兼容性实证
要准确回答这道面试题,首先必须用具体事实拆解其在版本互认层面的两个核心维度:
- 维度一:升级到 NumPy 2.0,是否必须升级到 pandas 3.0?
答案是完全不需要。 pandas 官方在 2.x 系列中早已完成了针对 NumPy 2.0 的适配。早在pandas 2.2.2维护版本中,团队就修复了与 NumPy 2.0 候选版的兼容问题,并在后续的pandas 2.2.3中提供了对 NumPy 2.0 正式发布的全面运行时支持。这意味着,现有项目完全可以继续保留在 pandas 2.2.x,同时享用 NumPy 2.0 带来的向量化计算性能与底层优化。 - 维度二:升级到 pandas 3.0,是否必须强制升级到 NumPy 2.0?
答案同样是不需要。 科学计算生态广泛遵循 SPEC 0 规范(Scientific Python Ecosystem Coordination)。按照规范,pandas 3.0 会对发布日期前至少 24 个月内的旧版 NumPy 保持向后兼容。在实际的包依赖定义中,pandas 3.0 允许的 NumPy 下限通常覆盖numpy >= 1.23.5或1.24+,并不会在底层写死强依赖numpy >= 2.0。因此,即使底层仍在使用稳定的 NumPy 1.x,也可以单向升级至 pandas 3.0。
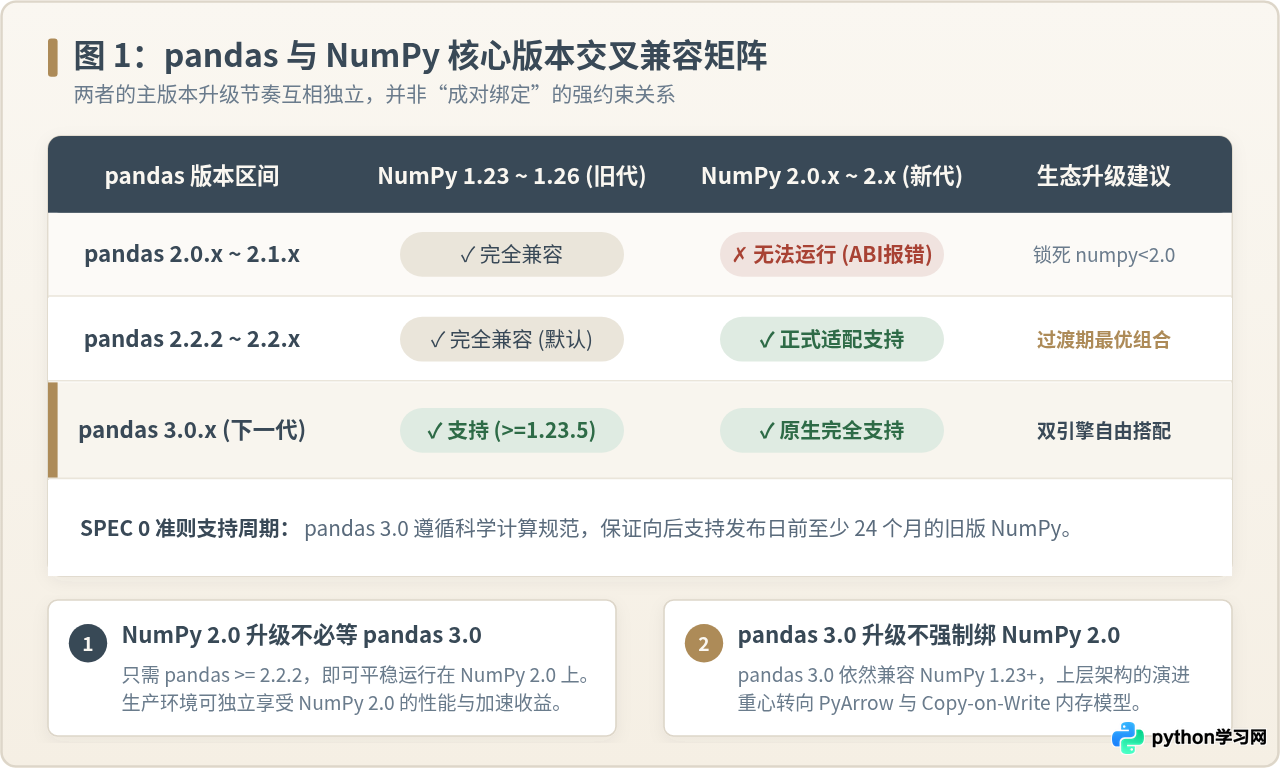
从上面的兼容矩阵中可以看出,二者的兼容边界非常清晰。对于开发者而言,最忌讳的是在旧版 pandas < 2.2.2(如 2.0 或 2.1)的环境中直接无约束安装 numpy >= 2.0,这将直接触发 C-API 二进制不兼容的运行时致命错误。
二、为什么常被误认为必须绑定升级?底层原理剖析
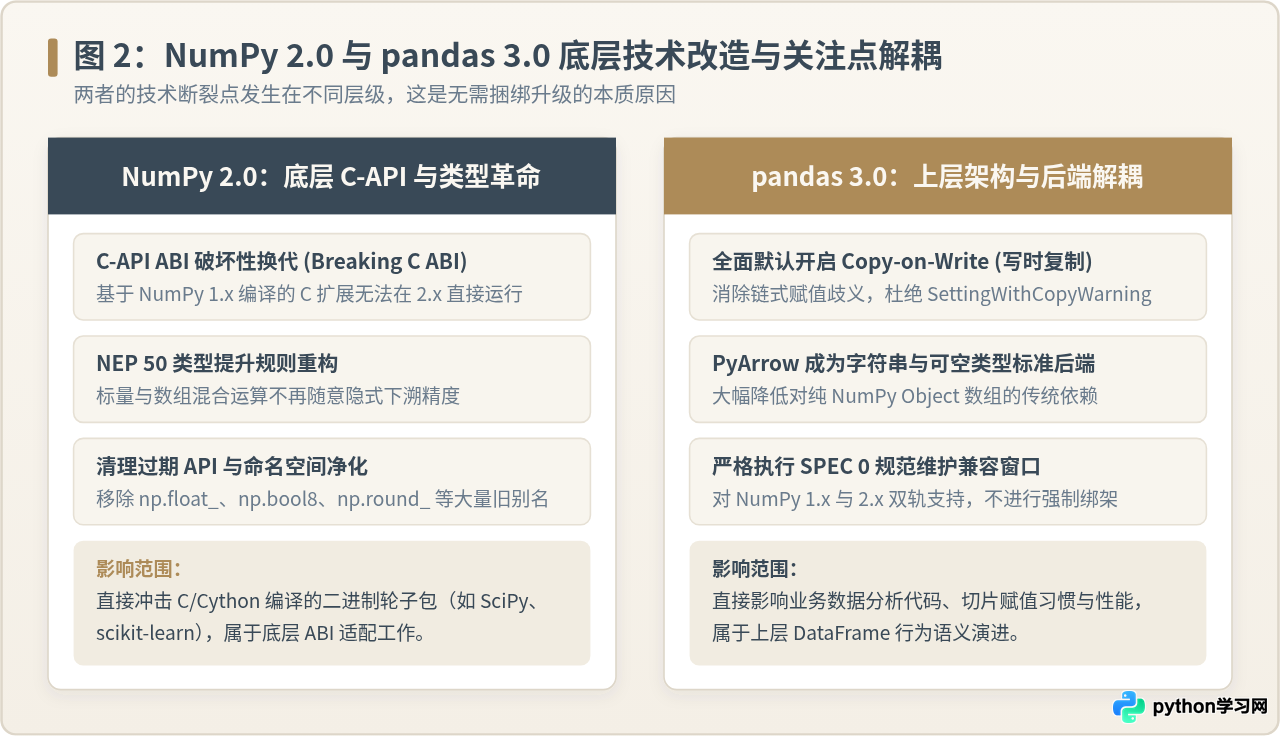
既然官方兼容性并不强制绑定,为什么许多资深工程师在实际项目中往往把它们放在一起讨论?这背后的技术成因在于:NumPy 2.0 的底层破坏性换代与 pandas 3.0 的数据底座重塑恰好在相近的时间窗口发生,两者的升级痛点各自落在完全不同的抽象层面上。
1. NumPy 2.0 的核心冲击:C-API ABI 破坏与类型系统重构
NumPy 2.0 是该项目自 2006 年以来的首次主版本跃迁,其最大变更是 C-API 的 ABI(应用二进制接口)断裂。在以往的 1.x 时代,许多三方库(如 SciPy、scikit-learn、OpenCV、PyTorch、Cython 模块)直接利用 NumPy 的 C 结构体和指针进行底层数据交互。如果一个 C 扩展是针对 NumPy 1.x 编译构建的,它在 NumPy 2.0 环境下启动时会直接崩溃报错,例如:
A module that was compiled using NumPy 1.x cannot be run in
NumPy 2.0.0 as it may crash. To support both 1.x and 2.x
versions of NumPy, modules must be compiled with NumPy 2.0.
此外,NumPy 2.0 实施了 NEP 50 规范,对数据类型提升规则进行了严格规范,不再允许标量随意弱化数组精度,同时清理了如 np.float_、np.bool8、np.round_ 等陈旧命名空间别名。这些变化使得升级 NumPy 2.0 变成了一项侧重于外部编译依赖排查与数学运算精度核验的任务。
2. pandas 3.0 的技术重心:PyArrow 底座与 Copy-on-Write 机制
与 NumPy 偏向底层 C 运行时的改造不同,pandas 3.0 的演进重点在于上层 DataFrame 行为语义的现代化与对纯 NumPy 数组的逐步解耦:
- 全面启用 Copy-on-Write (CoW): 在 pandas 3.0 中,写时复制成为强制默认机制。以往引发无数初学者困惑的隐式切片共享、链式赋值以及臭名昭著的
SettingWithCopyWarning彻底退场。所有切片返回的都是视图,修改时才会触发懒加载拷贝。这一变动直接影响了业务层的数据处理代码写法。 - PyArrow 成为原生一等公民: 长期以来,pandas 的字符串、对象列和可空布尔值均以低效的 Python 对象数组(基于 NumPy object dtype)存储,内存占用居高不下。pandas 3.0 深度融合 Apache Arrow,将 PyArrow 作为字符串、缺失值及原生类型的关键后端。这一转变让 pandas 在许多数据处理通路上不再高度依赖 NumPy 数组引擎。
正因为一个在改“底层 C 运行环境”,另一个在改“顶层内存模型与 API 语义”,如果将它们强行混在一次发布中同时上线,一旦线上抛出异常,工程师将难以分辨究竟是 NumPy 2.0 的 ABI/类型提升导致的数值漂移,还是 pandas 3.0 的 CoW 机制引发的逻辑变更。
三、生产环境中的解耦升级四步法
在面对这一面试题的追问“如果让你在生产项目中推进升级,你将如何规划?”时,给出条理清晰、风险可控的分步落地路径是拿到高分的关键。推荐采用如下四步操作:
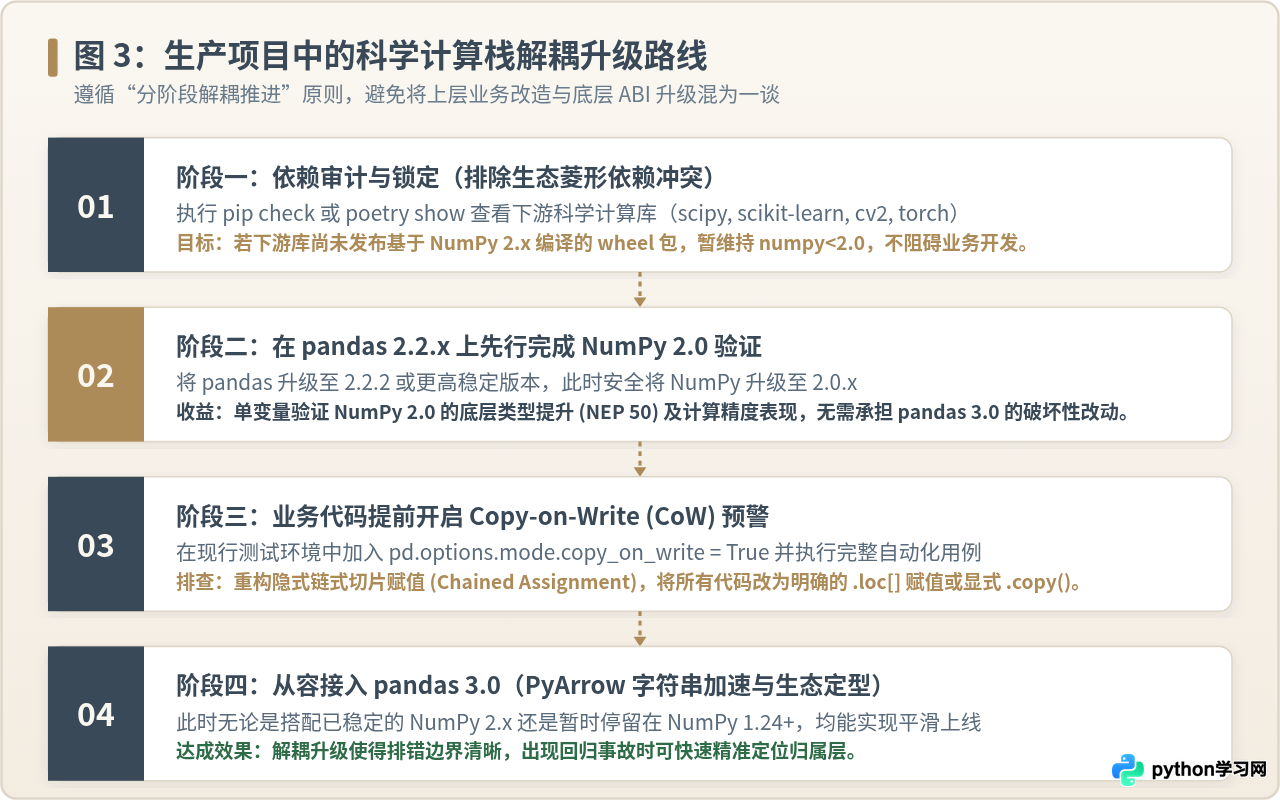
步骤一:依赖拓扑审计(排除 C 扩展生态中的菱形冲突)
在独立虚拟环境中,首先审计当前工程涉及的所有下游科学计算与机器学习依赖包。执行以下命令检查依赖树:
# 导出当前项目的依赖树并检查版本约束
pip check
pip list --format=freeze > current_requirements.txt重点关注包含编译扩展的库:scipy、scikit-learn、cv2、torch、lightgbm 等。如果其中有某个关键库尚未发布兼容 NumPy 2.x 的二进制 wheel,或者依赖项内部硬编码了 numpy < 2.0,那么此时升级整个项目的全局 NumPy 就会失败。正确的做法是先将 NumPy 版本锁定在 numpy>=1.24,<2.0,暂不强行推行 NumPy 2.0。
步骤二:独立升级 pandas 至 2.2.x 并先行引入 NumPy 2.0 验证
若生态三方包已经具备 NumPy 2.0 兼容版本,此时应先保持业务逻辑稳定,将 pandas 平滑提升到 pandas 2.2.2+(推荐 2.2.3),然后在该环境下安装 NumPy 2.0:
# 在保持现有业务代码不变的情况下,完成对 NumPy 2.0 的单变量验证
pip install --upgrade "pandas>=2.2.3" "numpy>=2.0.0"
运行核心业务单测与回归测试。此时排查的重点全部聚焦在 NEP 50 标量运算、移除的别名调用以及 C 扩展的运行稳定性上,将底座风险在可控范围内提前消化。
步骤三:业务代码提前开启 Copy-on-Write 预警排查
在准备迈向 pandas 3.0 前,无需直接安装 3.0。在当前的 pandas 2.2.x 环境中,即可主动开启 CoW 模式进行预演:
# 在单测入口或环境变量中预先启用写时复制
import pandas as pd
pd.options.mode.copy_on_write = True
执行自动化测试套件。此时如果代码中存在以下陈旧的链式赋值写法,将会被立即捕获:
# 典型的不规范链式赋值(在 CoW 开启后会静默失效或引发警告)
# 错误示范:
df[df['status'] == 1]['score'] = 100

# 应当重构为规范的显式索引赋值:
df.loc[df['status'] == 1, 'score'] = 100
通过在现行版本中完成业务代码规范化重构,便扫清了升级 pandas 3.0 最核心的代码语义障碍。
步骤四:平稳切入 pandas 3.0
在底层运行库与业务语法均完成分项验证后,最终在项目依赖声明(如 pyproject.toml 或 requirements.txt)中放开对 pandas 3.0 的约束:
# pyproject.toml 示例:保持弹性区间约束
[project.dependencies]
python = ">=3.10"
pandas = ">=3.0.0"
numpy = ">=1.24.0"  # 允许灵活搭配 NumPy 1.x 或 2.x
pyarrow = ">=14.0.0"
如此一来,项目的各层级改造责任被严格隔离在各个阶段,故障回滚时只需回退单一变量,避免了全量崩溃。
四、面试应答总结与决策思维模型
综合以上分析,当在面试中被问及“pandas 3.0 和 NumPy 2.0 必须一起升级吗?”时,推荐采用“三层金字塔”结构进行条理清晰的作答:
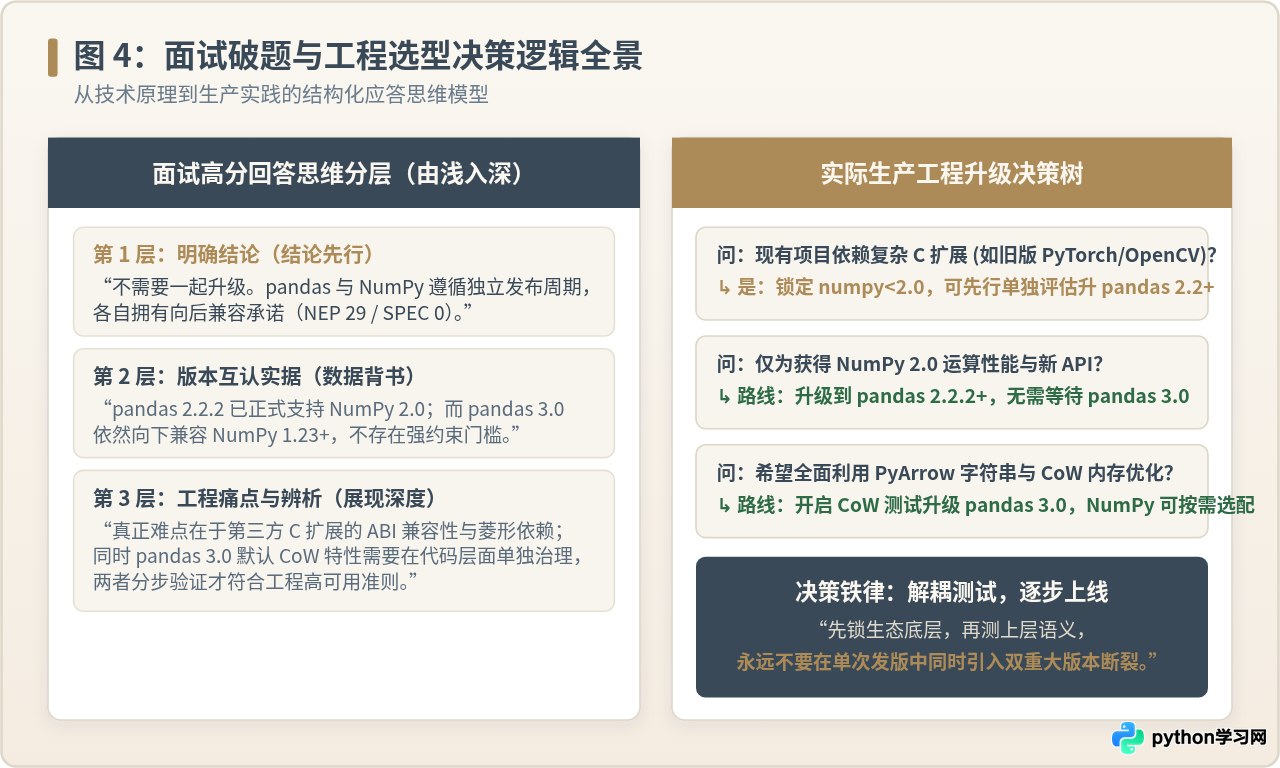
- 第一层:结论先行(干脆明确)
“面试官,答案是不需要一起升级。它们是两个独立演进的开源项目,各自遵循 SPEC 0 / NEP 29 生态兼容标准。不仅 pandas 2.2.2+ 就能单独运行在 NumPy 2.0 之上,pandas 3.0 也会继续兼容特定版本的 NumPy 1.x。” - 第二层:辨析底层关注点差异(展现技术内涵)
“之所以常被混淆,是因为两者的主版本跃迁碰巧接近。但 NumPy 2.0 的破局点在于底层的 C-API ABI 换代和 NEP 50 类型推导;而 pandas 3.0 的技术核心在于默认启用 Copy-on-Write 消除视图歧义,并引入 PyArrow 作为可空数据与字符串的基础后端,两者改造的层级完全不同。” - 第三层:阐述工程落地防险策略(体现架构素养)
“在实际工程落地中,强烈反对双主版本同时捆绑升级。因为一旦上线出现问题,根本无法定位是 C 扩展的 ABI 冲突还是业务代码的写时复制语义变化。工业界的最佳实践应当是‘单变量演进’:先锁定下游复杂 C 库,在已支持 NumPy 2.0 的稳定版 pandas 上验证底座;再在现有代码中预先开启 CoW 特性排查隐式赋值;最后再平稳切入 pandas 3.0。”
Q:为什么我的环境升级了 NumPy 2.0 后,即使 pandas 没报错,调用 scipy 时却报 numpy.dtype size changed?
这是典型的菱形依赖导致的 C-API ABI 冲突。NumPy 2.0 改变了基础结构体大小,如果已安装的 SciPy 是在 NumPy 1.x 环境下预编译的 wheel,就会触发此报错。解决方案是更新 SciPy 至 1.13.1+ 或 1.14.0+(官方已针对 NumPy 2.0 重新编译构建),或者将 NumPy 锁定在 <2.0。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















