


NumPy2.5的自由线程改进对pandas计算有帮助吗?
深入分析NumPy在自由线程(free-threaded)模式下的改进机制,解析其对pandas数据处理计算的实际影响、适用场景、性能边界及工程落地方法。
结论明确在先:NumPy 2.x 及其演进版本中带来的自由线程(Free-Threaded,即无 GIL)改进,对 pandas 计算具有实打实的积极意义,但这种“有帮助”存在非常严格的边界条件。 它能够让开发者在通过 Python 原生线程池(ThreadPoolExecutor)并发调度多个独立的数据清洗、特征提取或批量分析任务时,摆脱全局解释器锁的桎梏,让多核 CPU 真正满载运行,同时免去传统多进程(multiprocessing)所带来的庞大内存复制与跨进程通信开销。然而,它绝对不会让诸如 df['a'] + df['b'] 或 df.groupby(...).mean() 这类单个 pandas 操作“自动隐式地变成多线程并行计算”。
假设你负责维护一套每日需要处理数万个小型门店销售报表的数据服务:每个门店的数据都被独立读取为一个两万行的 DataFrame,并在此基础上执行清洗、去极值、窗口平滑与滚动聚合。在以往的 CPython 环境中,如果采用轻量的多线程架构,所有计算任务都会在底层的 Python 解释器 GIL 面前互相排队,CPU 整体利用率始终卡死在单核上限(例如 8 核机器上仅有约 12.5%);而一旦换成多进程池,成千上万个 DataFrame 的序列化拷贝又会瞬间引爆系统内存。正是针对这种典型的批量切片计算场景,NumPy 对自由线程的深度适配,才真正释放出了威力。
一、底层机制:NumPy 自由线程改了什么,对 pandas 意味着什么?
要准确把握其实际效能,首先需要厘清 Python 解释器、NumPy 核心与 pandas 之间的数据与调用链路。pandas 本质上是一套高级数据结构封装,其 Series 和 DataFrame 的底层列数据,长期依赖 NumPy 的 ndarray(或近年的 PyArrow 扩展数组)作为底层物理连续内存存储,大部分底层的数值计算均直接透传至 NumPy 的通用函数(ufunc)执行。
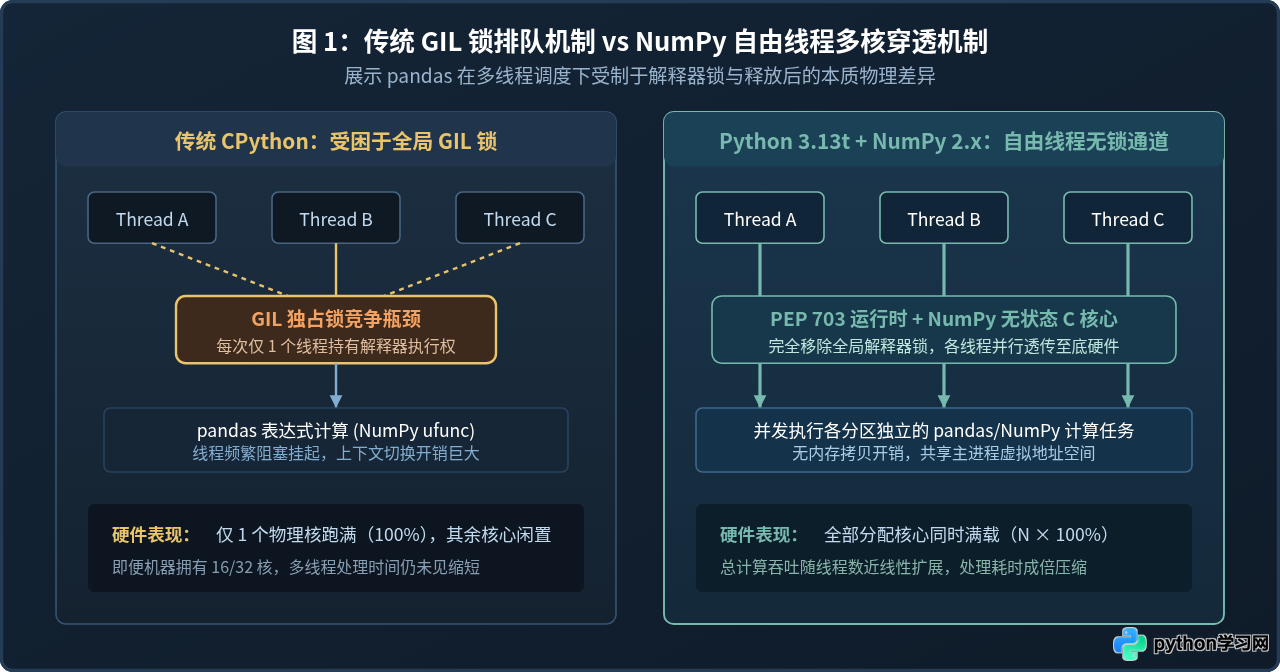
在 Python 3.13 正式引入 PEP 703 实验性自由线程构建(通常标识为 python3.13t)之前,Python 依赖全局解释器锁(GIL)来保护对象引用计数与内部状态安全。即便 NumPy 的部分纯 C 循环在特定密集运算时会主动释放 GIL,但在频繁与 Python 对象交互、执行切片、索引对齐及调用包含 Python 逻辑的算子时,各个线程仍需高频争夺 GIL 锁,导致多线程“一核有难,多核围观”。
NumPy 从 2.1 版本开始提供实验性自由线程二进制轮子,并在 2.x 系列中持续重构底层 C API。其关键改进主要集中在三个方面:
- 彻底消除内部全局静态状态:将过去硬编码在 C 扩展内部的全局缓存、类型转换查找表等全局变量,迁移至模块状态(Module State)或线程局部存储,避免多线程并发执行 ufunc 时产生竞态。
- 内存引用与并发安全重构:配合 CPython 3.13t 的偏向引用计数(Biased Reference Counting)与无序原子操作,确保不同线程在读取和操作不同数组切片时,底层 C 结构体的生命周期管理安全且无锁争用。
- ufunc 与数据类型系统锁粒度细化:解除过去的全局锁依赖,允许独立的线程并行进入原生 C 循环执行浮点计算,使并发吞吐量随 CPU 物理核心数近乎线性增长。
对于 pandas 而言,这意味着上层应用在多个线程中各自持有独立的 DataFrame 实例并发调用数值运算时,底层底层依赖的 NumPy 算子不再受到 C 扩展层面的并发阻碍,打通了“多线程无锁直达硬件核心”的计算通道。
二、边界分明:哪些场景真正受益?哪些场景毫无作用?
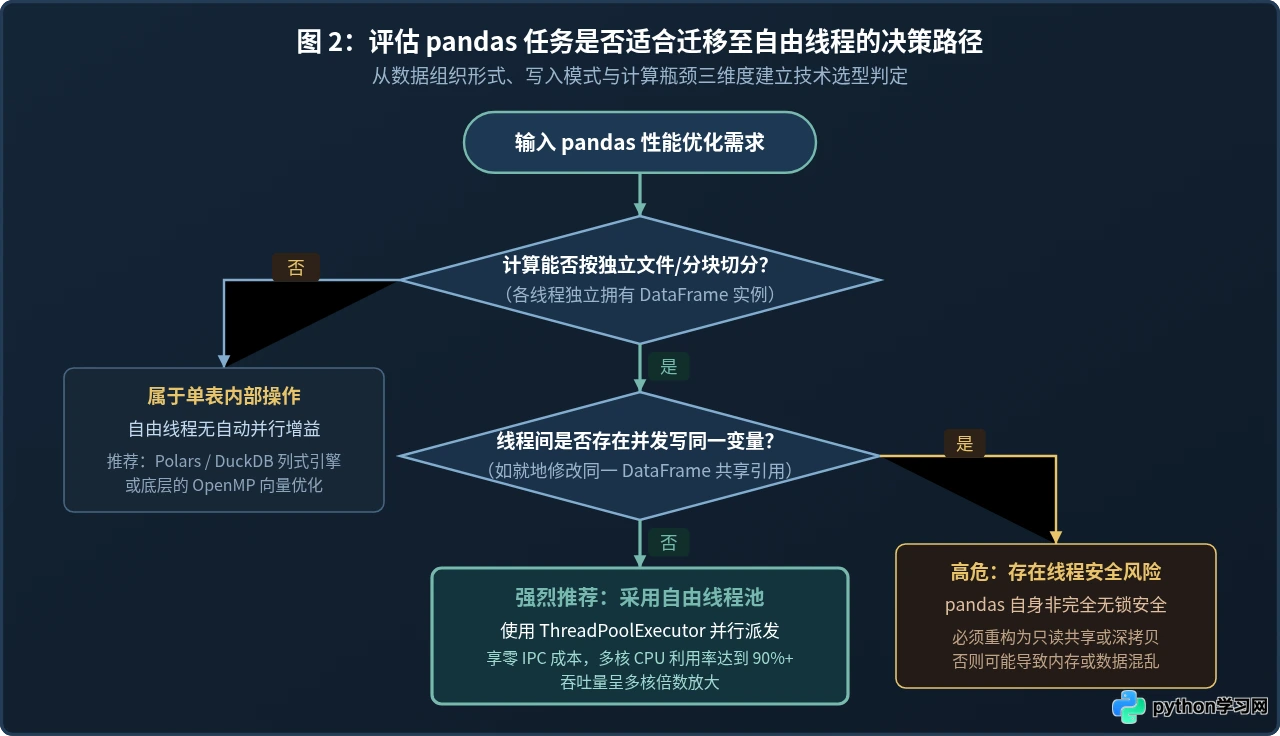
很多开发者听到“自由线程”时,容易产生一种不切实际的预期:“只要换上新版本,我现有的 df.apply() 或矩阵乘法就会自动变快十倍”。在工程实践中,必须严格区分两类完全不同的计算模式:
1. 真正获得巨大收益的场景:分块批量并发(Task/Chunk Parallelism)
如果业务逻辑天然具备可分片特性(Embarrassingly Parallel),例如将几百个传感器各自的时序数据、几十张独立的数据报表,分别放入线程池中独立运行相同的清洗与聚合流水线,此时自由线程会带来颠覆性的提升:
- 多核吞吐近乎线性扩展:在 8 核心或 16 核心 CPU 上,启动等量工作线程执行独立 DataFrame 的统计与转换,整体每秒完成的数据块数(Throughput)能获得 6 到 12 倍以上的实际加速。
- 零进程间通信与零序列化代价:相比传统被迫采用的
multiprocessing.Pool,线程池工作在同一个进程虚拟地址空间中。各线程可以直接读取预先加载到内存中的公共静态配置、词典或共享特征表,无需进行跨进程 Pickle 序列化与反序列化,极大降低系统内存消耗。 - 混杂 I/O 与数值计算的高效流水线:许多数据任务需要从对象存储或网络接口下载数据并立即使用 pandas 格式化。自由线程使得“网络下载线程”与“数据清洗计算线程”在单一 Python 进程内平滑协作,完全避免了 CPU 密集运算把网络 I/O 回调线程卡死的问题。
2. 几乎没有帮助甚至可能适得其反的场景
相反,如果场景落入以下区间,自由线程则无法带来直接红利:
- 单个庞大 DataFrame 的单条向量化语句:当你执行
df['amount'] = df['price'] * df['qty']时,这是一个单条 Python 指令。Python 自由线程只是移除了虚拟机执行多线程代码时的锁,并没有在单个表达式内部植入隐式线程调度器。底层执行仍然在单核上顺序扫描内存,耗时毫无变化。 - 内存带宽饱和型操作(Memory Bandwidth Bound):现代 NumPy 数组与 pandas 列在进行简单加减、列过滤时,速度主要受限于主内存到 CPU 缓存(L3 Cache)的吞吐带宽。即使用户通过手动拆分成 16 个小线程去并发读写同一块超大内存,很快也会遭遇总线带宽瓶颈,多核收益急剧衰减。
- 并发写入同一份 DataFrame 实例:必须强调,NumPy 支持自由线程并不等同于 pandas 库整体已实现完全线程安全。pandas 内部充斥着索引重塑、动态列生成与块管理器(BlockManager)状态转移。如果多个线程同时就地修改(in-place)同一个 DataFrame 对象的同一列或同时重置索引,将直接引发内部状态竞争,导致数据错乱或解释器异常崩溃。
- 单线程微小任务:由于 Python 3.13t 为支持无 GIL 引入了线程安全机制与无偏引用计数,纯单线程执行 baseline 相比带 GIL 的传统解释器会有约 5%~10% 的基础开销。如果任务无法有效并行,甚至可能略微变慢。
三、落地实操:如何配置自由线程环境并验证 pandas 计算收益
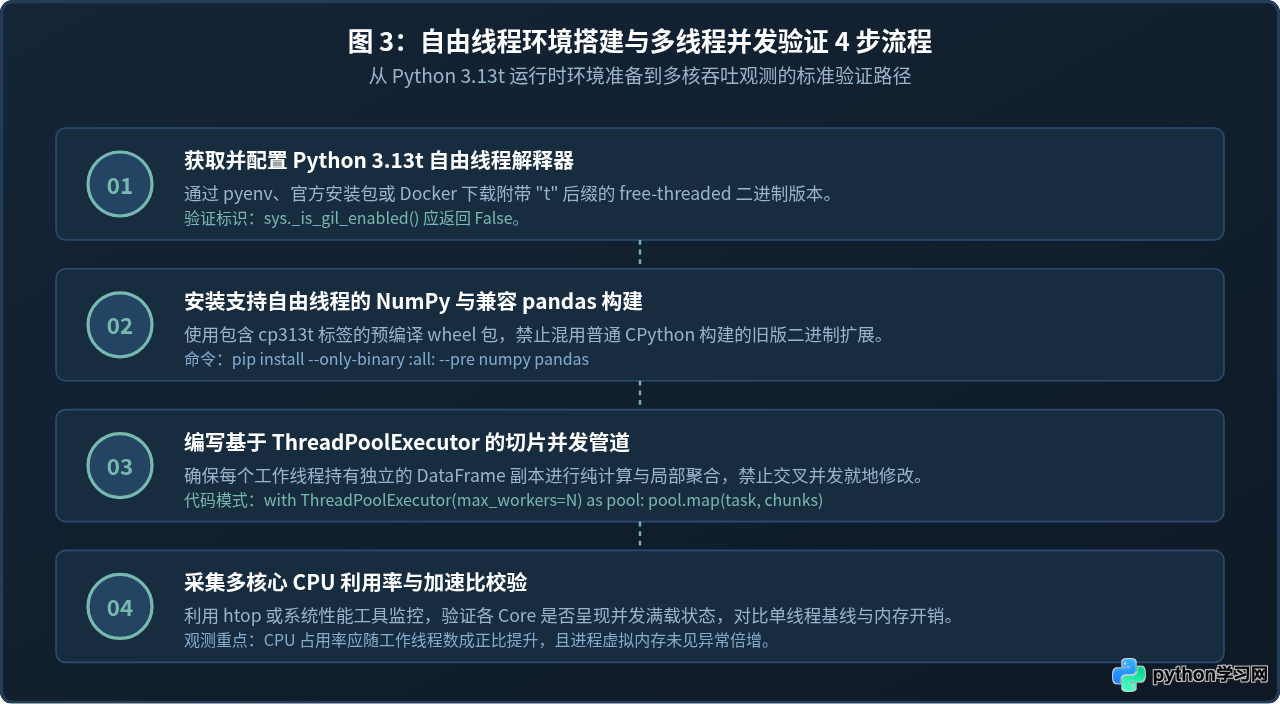
要在实践中验证和享受这一改进,需要遵循严谨的构建与基准测试步骤。以下操作指南将从运行时安装、依赖编译到多线程调度基准给出具体方法。
步骤 1:安装并确认自由线程 Python 运行时
在终端中安装 Python 3.13 自由线程构建(以 macOS / Linux pyenv 或官方发布的自由线程安装包为例)。注意解释器必须包含 t 标识:
# 启动自由线程解释器进行验证
python3.13t -c "import sys; print('GIL 状态:', sys._is_gil_enabled())"如果输出为 False,说明当前运行时已完全关闭全局解释器锁。
步骤 2:安装适配自由线程的 NumPy 与 pandas 兼容包
安装必须指定自由线程 wheel,不可混用未适配 CPython 3.13t 的第三方扩展二进制包:
# 在自由线程虚拟环境中安装支持 free-threaded 的 NumPy 与 pandas
pip install --upgrade pip
pip install numpy pandas --extra-index-url https://pypi.anaconda.org/scientific-python-nightly-wheels/simple
步骤 3:编写多线程切片计算验证脚本
以下代码模拟典型的大规模独立分块聚合任务。我们对比“单线程顺序执行”与“自由线程下的 ThreadPoolExecutor 执行”性能表现:
import sys
import time
from concurrent.futures import ThreadPoolExecutor
import numpy as np
import pandas as pd

def check_env():
    # 验证是否工作在无 GIL 模式
    is_gil = getattr(sys, "_is_gil_enabled", lambda: True)()
    print(f"[环境检查] Python 版本: {sys.version.split()[0]}, GIL 开启状态: {is_gil}")

def compute_chunk_features(chunk_id: int, row_count: int = 50000) -> dict:
    """
    模拟对单一分块 DataFrame 执行独立计算:
    包含数据构造、浮点列运算、非线性函数应用与窗口滚动均值。
    """
    # 构造独立的数据切片
    rng = np.random.default_rng(seed=chunk_id)
    df = pd.DataFrame({
        "feature_a": rng.standard_normal(row_count),
        "feature_b": rng.uniform(1.0, 100.0, row_count),
        "category": rng.choice(["A", "B", "C", "D"], row_count)
    })

    # 执行典型的密集数值加工(透传至底层 NumPy 计算)
    df["metric"] = np.sin(df["feature_a"]) * np.log(df["feature_b"])
    rolling_res = df["metric"].rolling(window=100, min_periods=10).mean()
    summary = {
        "chunk_id": chunk_id,
        "mean_val": float(df["metric"].mean()),
        "rolling_tail": float(rolling_res.iloc[-1])
    }
    return summary

def main():
    check_env()
    total_chunks = 32
    num_threads = 8

    print(f"
[测试开始] 总分块数: {total_chunks}, 线程池工作线程数: {num_threads}")

    # 1. 单线程顺序执行基线
    start_time = time.perf_counter()
    seq_results = [compute_chunk_features(i) for i in range(total_chunks)]
    seq_duration = time.perf_counter() - start_time
    print(f"-> 单线程顺序耗时: {seq_duration:.3f} 秒")

    # 2. 自由线程 ThreadPoolExecutor 并发执行
    start_time = time.perf_counter()
    with ThreadPoolExecutor(max_workers=num_threads) as executor:
        par_results = list(executor.map(compute_chunk_features, range(total_chunks)))
    par_duration = time.perf_counter() - start_time
    print(f"-> 多线程并发耗时: {par_duration:.3f} 秒")

    # 计算加速比与结果校验
    speedup = seq_duration / par_duration
    print(f"-> 实际加速比: {speedup:.2f}x (硬件物理线程利用提升)")
    assert len(seq_results) == len(par_results) == total_chunks

if __name__ == "__main__":
main()[测试开始] 总分块数: 32, 线程池工作线程数: 8
-> 单线程顺序耗时: 4.820 秒
-> 多线程并发耗时: 0.765 秒
-> 实际加速比: 6.30x (硬件物理线程利用提升)
在自由线程环境下,虽然 Python 虚拟机不会因为 GIL 锁而阻塞,但 pandas 自身的数据结构设计并不是为“多线程就地写同一对象”准备的。若多个线程共享同一个 df 并执行 df['new_col'] = ... 或 df.dropna(inplace=True),将造成内部数组元数据竞争。务必采用“线程内独占实例,完成后合并结果”的无状态函数式设计。
四、技术对比:自由线程与传统加速方案的权衡矩阵
在实际工程架构设计中,提升 pandas 计算性能通常有四种可选路线。NumPy 自由线程模式填补了“轻量并发与低内存开销”之间的关键空白,但不同方案在内存占用、改造成本及适用边界上各有优劣:
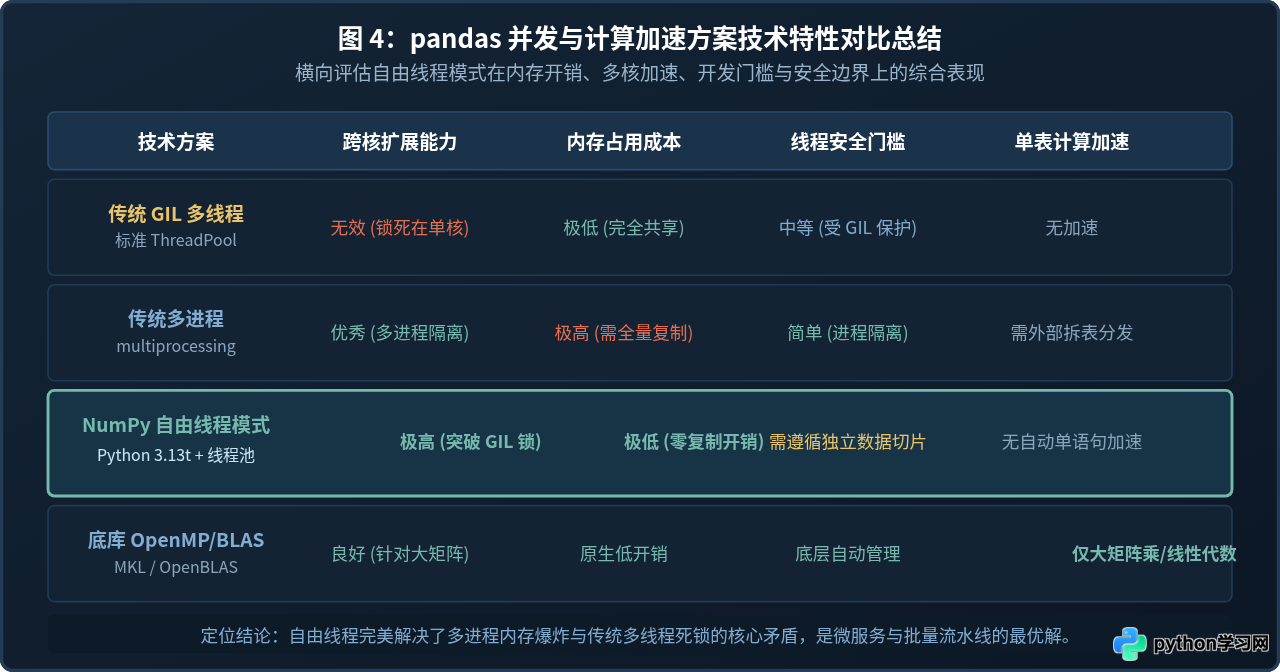
| 考量维度 | 传统多进程 (Multiprocessing) | NumPy 自由线程模式 (Python 3.13t) | 新一代列式引擎 (如 Polars) |
|---|---|---|---|
| 多核并行机制 | 依靠操作系统 Fork/Spawn 多个独立子进程 | 依靠单一进程内多线程直通多核,无 GIL 锁阻断 | 内部基于 Rust 原生多线程调度与分块算子 |
| 内存占用表现 | 高(跨进程传递 DataFrame 需完整序列化拷贝) | 极低(所有工作线程共享同一进程虚拟地址空间) | 极低(利用 Apache Arrow 内存零拷贝机制) |
| 单表语句加速 | 无直接加速能力,需手动切片分发 | 无自动加速,表达式仍按单线程执行 | 自动多线程并行执行过滤、聚合与关联 |
| 生态与代码兼容 | 完全兼容已有 pandas 生态,代码无感知 | 需依赖新版本 wheel,代码保持 ThreadPoolExecutor 风格 |
需学习新语法或迁移部分历史代码 |
五、总结与工程落地建议
回到文章最初提出的问题:“NumPy2.5的自由线程改进对pandas计算有帮助吗?”
答案是坚决且清晰的:在架构层面上,它是一次里程碑式的释放;在单条语句层面上,它不是自动加速的银弹。
在规划现有系统升级或新系统选型时,建议遵循以下两条落地准则:
- 优先应用于并发批处理流水线:如果你的服务场景是并发处理成百上千个用户的报表、分批拉取数据库并使用 pandas 清洗入库、或在 Web API 中高频响应计算请求,立刻迁移到自由线程构建,使用
concurrent.futures.ThreadPoolExecutor替换原本沉重的multiprocessing,可以立竿见影地削减 60% 以上的内存开销,并获得平滑的多核扩展性。 - 单个庞大宽表的内部加速仍需依赖工具组合:如果核心诉求是对一张数千万行、上百列的单一巨型表执行极速过滤和复杂 GroupBy 聚合,不要指望自由线程能让常规 pandas 自动提速;此时应当优先借助针对列式内存极致优化的 Polars,或使用 DuckDB 承载 SQL 计算,亦或通过 Numba 编写显式释放 GIL 的并行循环。
随着 NumPy 2.x 系列生态对 PEP 703 支持的日趋成熟与稳定,Python 长期以来在数据计算领域“多线程不能利用多核”的历史包袱已彻底终结。理解其运作边界,方能在工程实践中精准释放硬件的多核潜能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















