


Python 爬取 114 黄页商家电话与数据实战

本文介绍如何使用 Python 爬取 114 黄页的商家联系电话及名称。通过 requests 获取页面源码,利用 BeautifulSoup 解析 HTML 结构,提取特定 div 下的列表数据。代码包含翻页逻辑、请求头设置及 CSV 文件写入,适合初学者学习基础爬虫开发。
环境准备与依赖模块
实现该爬虫功能需要安装两个第三方库:requests 用于发送 HTTP 请求获取网页内容,BeautifulSoup 用于解析 HTML 文档。此外,Python 标准库中的 csv 和 time 模块也需引入,前者用于将数据写入表格文件,后者用于控制请求频率以避免触发反爬机制。
import requests
from bs4 import BeautifulSoup
import csv
import time
核心抓取函数设计
编写 get_content 函数负责获取并解析页面数据。该函数接收目标 URL 作为参数,并构建包含 User-Agent 等字段的请求头,模拟浏览器访问。获取响应后,使用 BeautifulSoup 解析 HTML 内容。
数据提取逻辑如下:首先定位到 ID 为 news_con 的 div 元素,接着找到其下的 ul 标签,并获取所有的 li 节点。遍历这些 li 节点,分别提取 h4 标签下的商铺名称和第二个 div 下的联系电话,将结果存入列表后返回。
def get_content(url,data=None):
 header = {
  'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8',
  'Accept-Encoding': 'gzip, deflate',
  'Accept-Language': 'zh-CN,zh;q=0.8',
  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/59.0.3071.104 Safari/537.36',
 }
 r = requests.get(url, headers=header)
 soup = BeautifulSoup(r.content, 'html.parser')
 data = soup.body.find('div',{'id':'news_con'})
 ul = data.find('ul')
 lis = ul.find_all('li')
 pthons=[]

 for item in lis:
  rows=[]
  name= item.find('h4').string
  rows.append(name)
  tel = item.find_all("div")[2].string
  rows.append(tel)
  pthons.append(rows)
  time.sleep(1)
 return pthons
数据持久化与写入
使用 write_data 函数将抓取到的数据保存为 CSV 文件。该函数接收数据列表和文件名作为参数,以写入模式打开文件,并设置 newline=''` 以避免空行。首先写入表头“商铺名称”和“联系电话”,随后使用 writerows 批量写入所有数据,并在控制台打印抓取完成提示。
def write_data(data,name):
 file_name=name
 with open(file_name, "w", newline='') as csvfile:
  writer = csv.writer(csvfile)
  writer.writerow(["商铺名称", "联系电话"])
  writer.writerows(data)
  print('抓取完成')
主程序执行与翻页逻辑
在 if __name__ == '__main__': 块中定义起始 URL。该 URL 包含 page 参数,通过修改此参数可实现翻页操作。程序调用 get_content 获取数据,并传入 write_data 保存为 phone.csv。实际应用中,可通过循环自动递增 page 参数来实现多页数据的批量抓取。
if __name__ == '__main__':
 url = 'http://ty.114chn.com/CustomerInfo/Customers?cid=008004008&page=2'
 mydata = get_content(url)
 write_data(mydata,'phone.csv')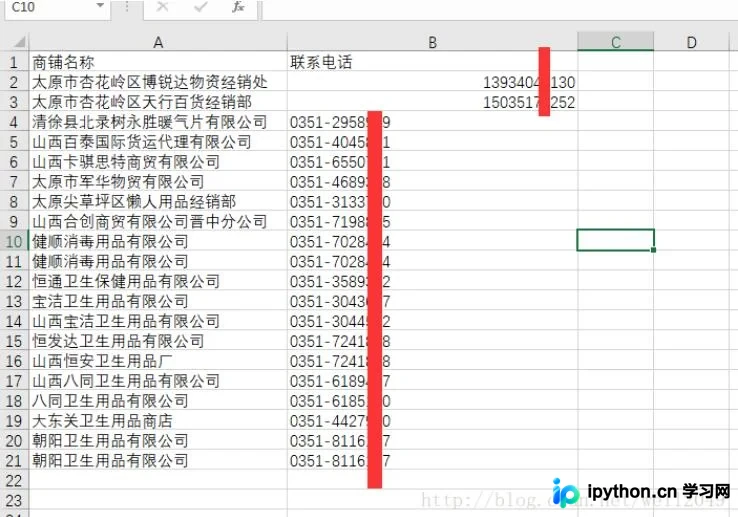
以上就是 Python 爬取 114 黄页商家电话与数据实战的详细内容,更多关于 Python 爬虫开发、网络数据采集的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















