


使用Python实现区分I和l等视觉相似字符

发布时间:2026-10-11 |
3人浏览过
针对不支持复制粘贴场景下无法区分的视觉相似字符(如大写I与小写l、数字1与字母l等),本文提供Python处理方案。通过构建混淆字符映射表并遍历目标文本,程序可精准统计疑似字符的出现位置,或逐行输出中文标注文本,帮助用户快速核对并手动键入正确内容。
常见视觉混淆字符的使用痛点
在许多应用交互中,系统明确禁止直接复制粘贴,要求用户手动输入账号、游戏ID或验证码。当目标名称由视觉上高度相似的字符组合时(尤其在特定渲染字体下,大写“I”与小写“l”几乎重合),人工逐字辨认极易发生错位或拼写遗漏。
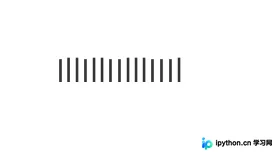
准备与核心逻辑
解决该问题的核心在于利用Python的字符串遍历功能,建立目标文本与人类可读描述的映射关系。程序会按索引扫描每一个字符,一旦命中预设的混淆字符表,便将其转换为明确的名称说明。以下代码移除了原文本中未调用的re模块,保留核心逻辑以确保可直接运行。
from collections import defaultdict

# 初始化混淆字符映射表,可根据实际使用的字体自行增删
confusable_chars = {
    'I': '大写字母I',
    'l': '小写字母l',
    '1': '数字1',
    '0': '数字0',
    'O': '大写字母O',
    'o': '小写字母o'
}

text = "IllllIl111llI11111"  # 待处理的原始文本
第1步:统计混淆字符的位置与频次
此步骤主要用于全局核对。程序会记录每个干扰字符在字符串中的确切索引位置及总次数,适合用于交叉验证是否遗漏了某个隐蔽字符。
def analyze_confusable_characters(text, confusable_chars):
    results = defaultdict(list)

    for i, char in enumerate(text):
        if char in confusable_chars:
            results[char].append(i)

    print("混淆字符统计分析:")
    for char, positions in results.items():
        print(f"字符 '{char}' ({confusable_chars[char]}) 出现次数: {len(positions)}, 位置: {positions}")

    return results

results_step1 = analyze_confusable_characters(text, confusable_chars)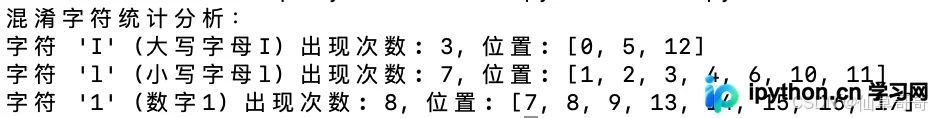
第2步:生成逐行标记文本
统计完成后,为了降低手动输入的出错率,通常需要生成一份按顺序逐行标注的清单。该函数会跳过位置计算,直接返回格式化后的提示文本,用户可完全照抄对应汉字部分进行键盘录入。
def generate_labeled_text(text, confusable_chars):
    labeled_lines = []
    for idx, char in enumerate(text):
        if char in confusable_chars:
            labeled_lines.append(f"第{idx + 1}个字符是:{confusable_chars[char]}")
        else:
            labeled_lines.append(f"第{idx + 1}个字符是:{char}")
    return "\n".join(labeled_lines)

print(generate_labeled_text(text, confusable_chars))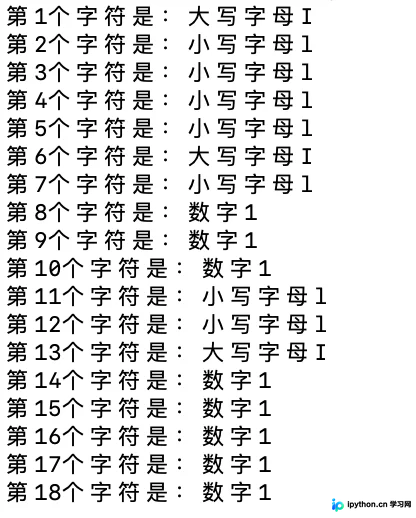
完成判断与扩展建议
当控制台完整输出带序号的逐行说明时,即代表分析任务已完成。核对无误后,直接对照屏幕提示依次按下对应按键即可完成输入。
若需适配其他易混淆组合(如数字5与字母S、小写u与v等),只需在代码顶部扩充confusable_chars字典即可,遍历逻辑会自动覆盖新增项。示例如下:
confusable_chars = {
    'S': '大写字母S',
    's': '小写字母s',
    '5': '数字5',
    'u': '小写字母u',
    'v': '小写字母v',
    '3': '数字3'
}
以上就是使用Python脚本区分视觉相似字符的详细内容,更多关于Python字符串处理与日常工具开发的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















