


Python提取包含特定字符串的行数据方法

发布时间:2026-10-11 |
1人浏览过
本文介绍如何使用Python提取包含特定字符串的行数据。通过正则表达式匹配目标字符串,结合文件读写操作,实现从原始文件中筛选并保存包含特定关键字的行。
Python提取特定字符串行的方法
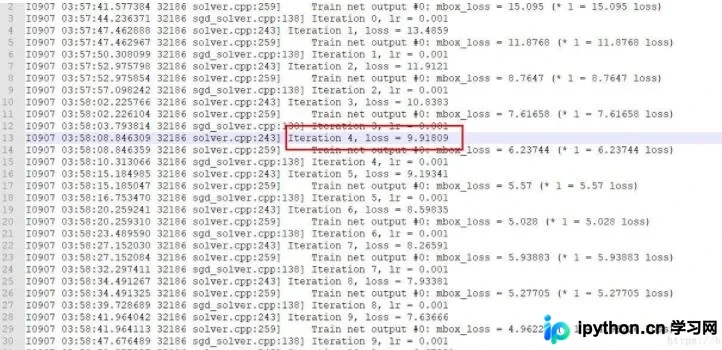
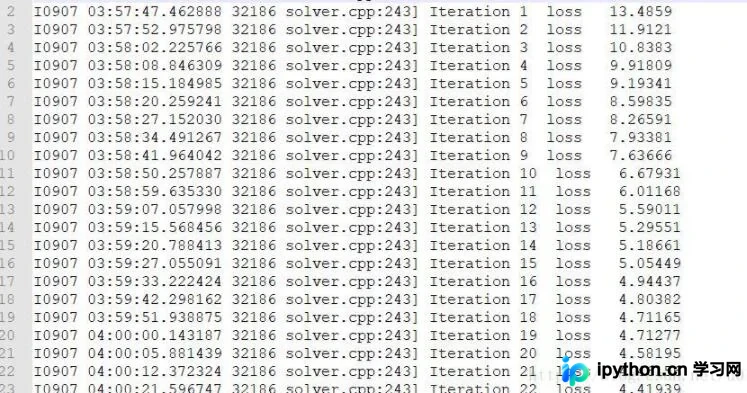
在处理日志文件或实验数据时,经常需要从大量文本中提取包含特定关键字的行。例如,从名为 lossstotal.txt 的文件中提取包含 Iteration 和 loss 的行。以下是一种基于正则表达式的实现方法。
准备工作
在运行代码前,请确保:
- 代码文件与数据文件
lossstotal.txt位于同一目录。 - 目标文件存在且包含待处理的数据。
代码实现
以下代码演示了如何分两步提取包含 Iteration 和 loss 的行,并进行简单的文本清理:
#coding:utf-8
#__author__ ='dell'

import re

# 读取原始文件
f1 = open('lossstotal.txt', 'r')
data1 = f1.readlines()
f1.close()

results = []
f2 = open('loss2.txt', 'w')

# 利用正则表达式提取包含 'Iteration' 的行
for line in data1:
    data2 = line.split()
    for i in data2:
        n = re.findall(r"Iteration", i)
        if n:
            f2.writelines(line)
f2.close()

# 读取中间文件,提取包含 'loss' 的行
f3 = open('loss2.txt', 'r')
data3 = f3.readlines()
f3.close()
f4 = open('loss3.txt', 'w')

for line in data3:
    data4 = line.split()
    for i in data4:
        n = re.findall(r"loss", i)
        if n:
            print(line)
            f4.writelines(line)
f4.close()

# 清理文本:去除逗号
f5 = open('loss3.txt', 'r')
data5 = f5.read()
f5 = data5.replace(',', ' ')
f6 = open('lossfinal.txt', 'w')
f6.write(f5)
f6.close()

# 清理文本:去除等号
f7 = open('lossfinal.txt', 'r')
data7 = f7.read()
f7 = data7.replace('=', ' ')
f8 = open('lossfinal.txt', 'w')
f8.write(f7)
f8.close()
代码说明
- 正则匹配:使用
re.findall(r"Iteration", i)和re.findall(r"loss", i)来检测单词是否包含目标字符串。 - 文件操作:通过多次读写文件,逐步筛选出包含特定关键字的行。
- 文本清理:使用
replace()方法去除逗号(,)和等号(=),以简化输出格式。
注意事项
- 确保输入文件
lossstotal.txt存在,否则代码会抛出异常。 - 代码中使用了
open()和readlines(),在处理大文件时请注意内存占用。 - 正则表达式匹配的是单词边界内的字符串,如需更精确的匹配,可调整正则表达式。
以上就是Python提取包含特定字符串的行数据方法的详细内容,更多关于Python文件处理与正则表达式应用的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















