


Python实现分类器决策边界可视化:从数据生成到逻辑回归演示

发布时间:2026-10-12 |
2人浏览过
本文介绍如何使用Python和Scikit-learn库可视化分类器的决策边界。通过生成 moons 数据集,定义预测函数并绘制等高线图,详细演示了逻辑回归模型在非线性可分数据上的分类效果及边界绘制方法,适合AI入门及模型训练学习者参考。
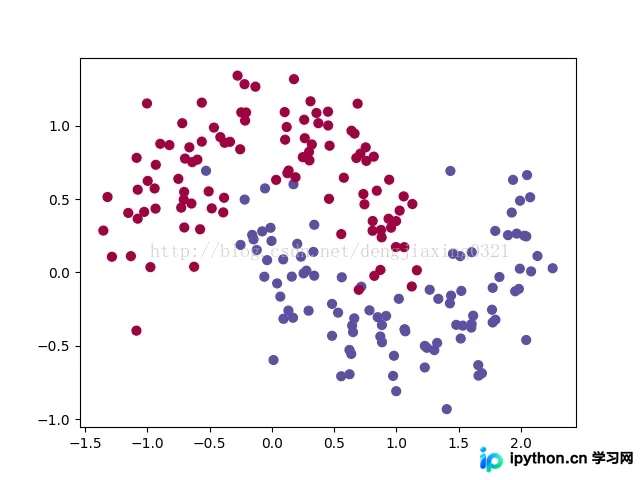
首先获取数据集,并绘制基础数据分布图,具体代码如下:
import numpy as np
from sklearn.datasets import make_moons
import matplotlib.pyplot as plt
# 手动生成一个随机的平面点分布,并画出来
np.random.seed(0)
X, y = make_moons(200, noise=0.20)
plt.scatter(X[:,0], X[:,1], s=40, c=y, cmap=plt.cm.Spectral)
plt.show()
运行上述代码后,得到的初始数据分布图如下所示:
接下来定义用于绘制决策边界的辅助函数,实现步骤如下:
# 咱们先顶一个一个函数来画决策边界
def plot_decision_boundary(pred_func):

 # 设定最大最小值,附加一点点边缘填充
 x_min, x_max = X[:, 0].min() - .5, X[:, 0].max() + .5
 y_min, y_max = X[:, 1].min() - .5, X[:, 1].max() + .5
 h = 0.01

 xx, yy = np.meshgrid(np.arange(x_min, x_max, h), np.arange(y_min, y_max, h))

 # 用预测函数预测一下
 Z = pred_func(np.c_[xx.ravel(), yy.ravel()])
 Z = Z.reshape(xx.shape)

 # 然后画出图
 plt.contourf(xx, yy, Z, cmap=plt.cm.Spectral)
 plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.Spectral)
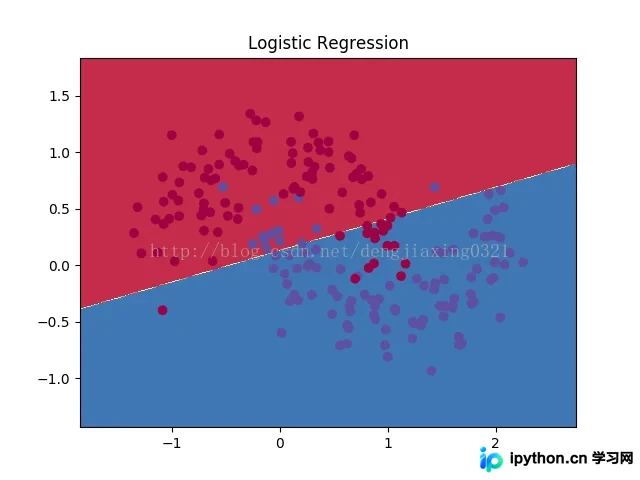
定义分类器函数,并调用前述边界绘制函数生成决策边界图,完整代码如下:
from sklearn.linear_model import LogisticRegressionCV
#咱们先来瞄一眼逻辑斯特回归对于它的分类效果
clf = LogisticRegressionCV()
clf.fit(X, y)

# 画一下决策边界
plot_decision_boundary(lambda x: clf.predict(x))
plt.title("Logistic Regression")
plt.show()
执行上述代码后,生成的决策边界可视化结果如下:
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















