


Python requests.text乱码处理与decode()错误机制详解

在使用Python的requests库抓取网页时,开发者常遇到res.text返回乱码的情况。这通常是因为网站实际编码与requests自动猜测的编码不一致。本文详细解析如何通过content属性结合decode()方法手动指定编码,并重点讲解errors参数在解决非法字符导致的转码异常中的关键作用。
理解 requests.text 与乱码成因
在Python中,使用requests库获取网页内容时,开发者通常会直接访问响应对象的 text 属性。该属性会自动尝试根据HTTP头或网页内容猜测编码格式进行解码,并返回字符串。然而,这种自动猜测机制并不总是准确的。当网站的实际编码格式(如GBK、GB2312)与requests默认猜测的格式(通常是UTF-8或ISO-8859-1)不一致时,text 属性返回的内容就会出现乱码。
手动解码:从 content 到 decode
要解决乱码问题,最可靠的方法是手动指定编码格式。这需要分两步走:
- 获取原始字节数据:访问响应对象的
content属性。与text不同,content返回的是未经解码的bytes类型数据,保留了网页的原始字节序列。 - 执行解码操作:对获取到的
bytes数据调用decode()方法,并明确指定网页的实际编码格式(例如'utf-8'或'gbk')作为参数。
代码示例如下:
import requests

response = requests.get('http://example.com')
# 获取原始字节
raw_bytes = response.content
# 手动指定编码解码
correct_text = raw_bytes.decode('utf-8')
处理解码异常:errors 参数的妙用
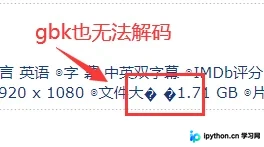
即使指定了正确的编码格式,有时仍会抛出 UnicodeDecodeError 异常。这通常是因为网页中包含了一些不符合该编码规范的“非法字符”。例如,某些网站可能混入了非标准的全角空格(如 \xa3\xa0 或 \xa1\xa1),这些字符在标准的GBK或UTF-8编码中可能无法被正确解析。一旦遇到一个非法字符,默认的解码过程就会中断,导致整篇内容无法转码。
为了解决这个问题,decode() 方法提供了一个 errors 参数,用于控制遇到非法字符时的处理策略。其函数原型为 decode([encoding], [errors='strict'])。默认情况下,errors 为 'strict',即遇到非法字符直接抛出异常。我们可以根据需求调整该参数:
'strict'(默认):遇到非法字符抛出UnicodeDecodeError。适用于对数据完整性要求极高,且能确保编码完全匹配的场景。'ignore':直接忽略无法解码的非法字符。这能确保解码过程顺利完成,但可能会丢失部分信息(如特殊符号或空格)。'replace':用问号?替换无法解码的字符。这是一种折中方案,保留了字符串长度和结构,但用占位符替代了乱码部分。'xmlcharrefreplace':使用XML字符引用(如 )替换非法字符。这种方式在生成XML或HTML内容时较为有用,能保留字符的语义信息。
在实际开发中,如果确定乱码是由少量非关键字符(如特殊空格)引起的,使用 'ignore' 或 'replace' 往往能迅速解决问题,保证程序继续运行。
总结
解决Python requests.text乱码的核心在于理解自动解码的局限性,并掌握手动解码的技巧。通过结合 content 属性和 decode() 方法,并灵活运用 errors 参数处理非法字符,开发者可以高效地应对各种复杂的网页编码问题。以上就是Python响应对象text属性乱码解决方案的详细内容,更多关于Python requests库使用技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















