


Python 实现 T00ls 自动签到脚本代码(邮件+钉钉通知)

本文详细介绍如何使用 Python 编写 T00ls 论坛的自动签到脚本,通过集成钉钉机器人 Webhook 和 QQ 邮箱 SMTP 服务实现实时通知。文章涵盖基础登录签到、域名查询获取 TuBi 奖励、以及利用 Linux crontab 设置定时任务的完整流程,帮助开发者自动化获取论坛积分并减少手动操作成本。
T00ls 论坛每日签到可获取 TuBi 奖励,但因经常遗忘导致损失。经搜索发现已有不少开发者编写了签到脚本,功能涵盖签到执行、定时任务及多种提醒方式。受此启发,笔者尝试整合前辈经验,编写一套包含签到、定时执行及通知功能的自动化脚本。鉴于拥有 Linux 服务器,计划利用 crontab 实现定时任务,并通过钉钉和邮件进行提醒,以满足日常使用需求。
基础签到功能实现
脚本开发需逐步添加功能,首要目标是实现基础的登录与签到逻辑,随后再集成邮件和钉钉通知模块。
鉴于脚本功能相对简单,将各功能封装为独立函数,并参照标准开发规范提供详细注释。具体实现代码如下:
import json
import requests
username = '国光' # 帐号
password = 'xxxxxxxxxxxxxxxxxxxxxxxxxxxxxx' # 密码MD5 32位(小写)
question_num = 5 # 安全提问 参考下面
question_answer = 'xxx' # 安全提问答案
# 0 = 没有安全提问
# 1 = 母亲的名字
# 2 = 爷爷的名字
# 3 = 父亲出生的城市
# 4 = 您其中一位老师的名字
# 5 = 您个人计算机的型号
# 6 = 您最喜欢的餐馆名称
# 7 = 驾驶执照的最后四位数字
def t00ls_login(u_name, u_pass, q_num, q_ans):
 """
 t00ls 登录函数
 :param u_name: 用户名
 :param u_pass: 密码的 md5 值 32 位小写
 :param q_num: 安全提问类型
 :param q_ans: 安全提问答案
 :return: 签到要用的 hash 和 登录后的 Cookies
 """
 login_data = {
 'action': 'login',
 'username': u_name,
 'password': u_pass,
 'questionid': q_num,
 'answer': q_ans
 }
 response_login = requests.post('https://www.t00ls.net/login.json', data=login_data)
 response_login_json = json.loads(response_login.text)
 if response_login_json['status'] != 'success':
 return None
 else:
 print('用户:', username, '登入成功!')
 formhash = response_login_json['formhash']
 t00ls_cookies = response_login.cookies
 return formhash, t00ls_cookies
def t00ls_sign(t00ls_hash, t00ls_cookies):
 """
 t00ls 签到函数
 :param t00ls_hash: 签到要用的 hash
 :param t00ls_cookies: 登录后的 Cookies
 :return: 签到后的 JSON 数据
 """
 sign_data = {
 'formhash': t00ls_hash,
 'signsubmit': "true"
 }
 response_sign = requests.post('https://www.t00ls.net/ajax-sign.json', data=sign_data, cookies=t00ls_cookies)
 return json.loads(response_sign.text)
def main():
 response_login = t00ls_login(username, password, question_num, question_answer)
 if response_login:
 response_sign = t00ls_sign(response_login[0], response_login[1])
 if response_sign['status'] == 'success':
  print('签到成功')
 elif response_sign['message'] == 'alreadysign':
  print('今日已签到')
 else:
  print('出现玄学问题了 签到失败')
 else:
 print('登入失败 请检查输入资料是否正确')
if __name__ == '__main__':
 main()
需注意,T00ls 要求连续签到 2 天方可获得 TuBi 奖励。
域名查询奖励机制
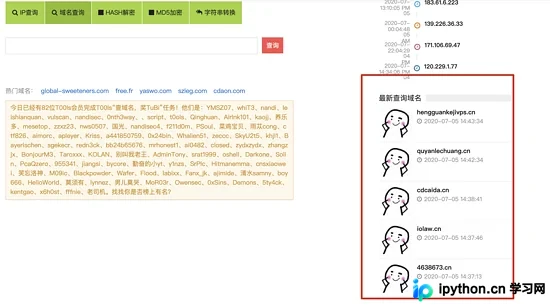
T00ls 在线工具提供域名查询功能,每日查询可额外获得 1 个 TuBi 奖励。结合签到奖励,每日可获得 2 个 TuBi,月累计 60 个,年累计可达 720 个 TuBi。
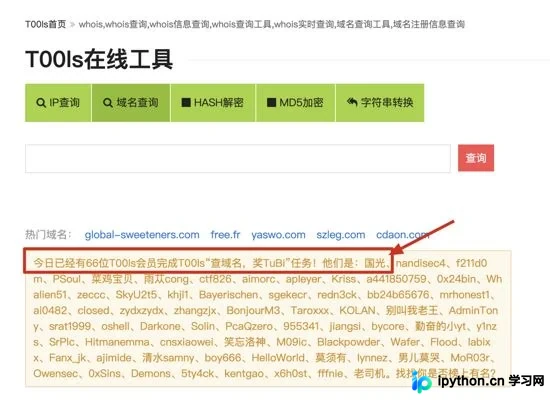
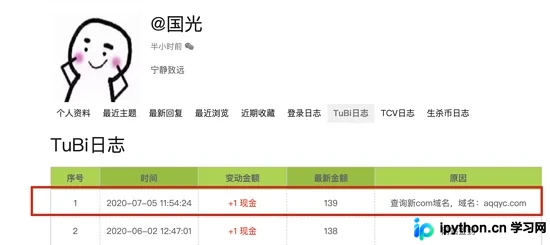
在 TuBi 日志中可查看域名查询的相关记录:
域名查询功能存在特定限制,经咨询 T00ls 的 MoR03r 大佬得知:
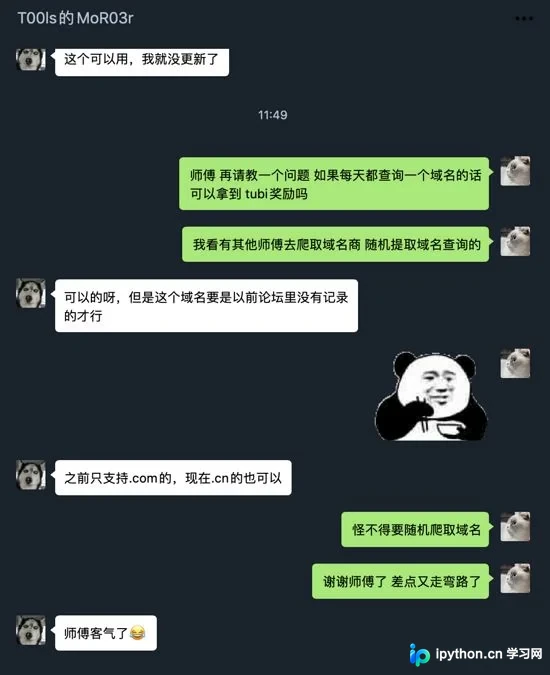
因此,每日需查询一个论坛内未记录的域名才能生效,需编写相应流程。以下是域名查询的代码实现:
def t00ls_domain(t00ls_hash, t00ls_cookies):
 # 使用站长之家查询今天注册的域名
 start_time = time.time()
 china_url = 'https://whois.chinaz.com/suffix'
 search_data = 'ix=.com&suffix=.cn&c_suffix=&time=1&startDay=&endDay='
 req_headers['Content-Type'] = 'application/x-www-form-urlencoded'
 response_domains = requests.post(url=china_url, headers=req_headers, data=search_data, timeout=10)
 soup = BeautifulSoup(response_domains.text, 'html.parser')
 # Bs4 解析器 简单规则过滤一下放入到 domains 的列表中
 domains = []
 for i in soup.select('.listOther a'):
 if '.' in i.string and '*' not in i.string:
  domains.append(i.string)
 domain = random.sample(domains, 1)[0] # 随机抽取一个 幸运儿
 end_time = time.time()
 print(f'站长之家随机找域名耗时: {end_time - start_time:.4f}秒')

 start_time = time.time()
 query_url = 'https://www.t00ls.net/domain.html'
 query_data = f'domain={domain}&formhash={t00ls_hash}&querydomainsubmit=%E6%9F%A5%E8%AF%A2'
 query_status = False

 # 如果 t00ls 查询没有成功的话 就一直查询
 while not query_status:
 domain = random.sample(domains, 1)[0] # 随机抽取一个 幸运儿
 query_data = f'domain={domain}&formhash={t00ls_hash}&querydomainsubmit=%E6%9F%A5%E8%AF%A2'

 try:
  response_query = requests.post(url=query_url, headers=req_headers, data=query_data, cookies=t00ls_cookies)
 except Exception as e:
  pass

 if domain in response_query.text:
  print('t00ls 查询域名成功')
  response_tb = requests.get('https://www.t00ls.net/members-tubilog.json', cookies=t00ls_cookies)
  if domain in response_tb.text:
  print('查询域名 TuBi + 1')
  query_status = True
  else:
  print('糟糕 域名查询成功 但是 TuBi 没有增加 可能域名重复了')
  print('随机延时 5-10 秒,继续查询...')
  time.sleep(random.randint(5, 10))
 else:
  print(f'查询失败?失败的域名是: {domain}')
  print('随机延时 5-10 秒,继续查询...')
  time.sleep(random.randint(5, 10))

 end_time = time.time()
 print(f't00ls 域名查询耗时: {end_time - start_time:.4f}秒')
域名查询调用站长之家服务,速度尚可。由于 T00ls 域名查询服务稳定性一般,代码中采用 while 循环持续查询。为减轻服务器负担,查询失败时随机延时 5-10 秒,建议使用者保持此延时策略,以维持良好的爬虫规范。
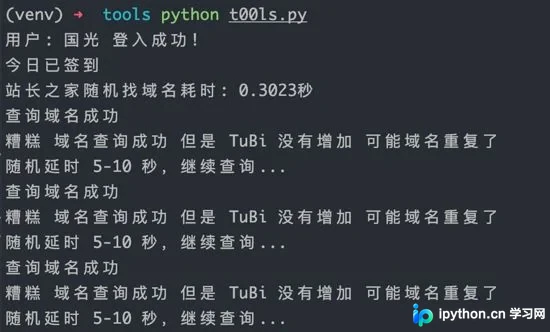
代码已考虑多种边界情况,包括查询超时、域名重复等异常处理。
域名查询功能完成后,为避免因频繁查询被拉黑,接下来研究如何接入钉钉通知服务。
钉钉服务接入指南
鉴于办公环境普遍使用钉钉,尝试将脚本接入钉钉提醒服务。
钉钉机器人仅支持在群聊中添加,因此需预先创建一个用于接收通知的群。若无现成群,可通过手机端「发起群聊」-「选人建群」-「面对面建群」创建,即使仅包含本人也可正常使用。
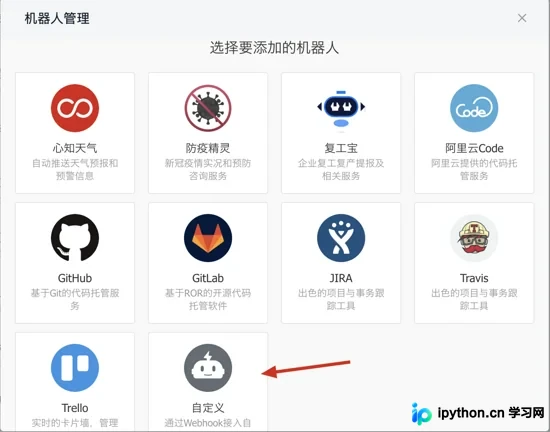
在钉钉「机器人管理」中添加自定义机器人,通过 Webhook 接入操作便捷:
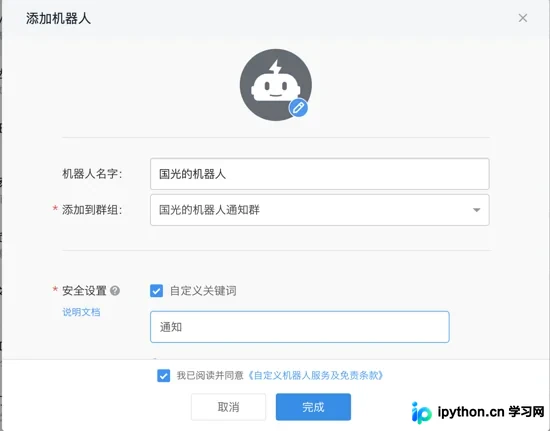
将机器人添加至新建群后,可设置自定义关键词(若设置关键词,Webhook 内容必须包含该关键词,否则消息无法发送):
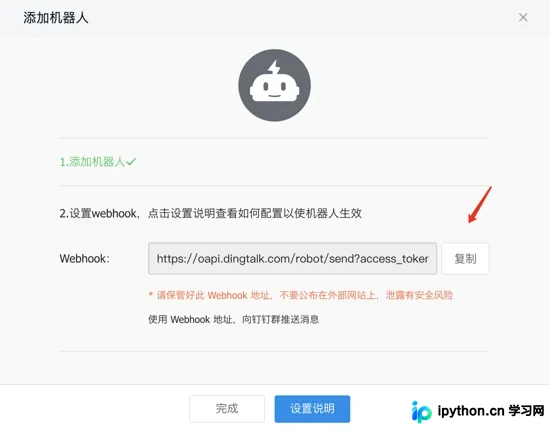
配置完成后生成 Token 地址,需复制保存备用:
详细的钉钉自定义机器人配置可参考官方文档:钉钉开发文档。
笔者采用最基础的 text 文本类型进行通知:
{
 "msgtype": "text",
 "text": {
 "content": "我就是我, 是不一样的烟火"
 },
 "at": {
 "atMobiles": [
  "177******30",
 ],
 "isAtAll": false
 }
}
若无需 @特定人员,可使用以下最基础的 Demo 代码:
import json
import requests

webhook = 'https://oapi.dingtalk.com/robot/send?access_token={你的机器人的token}'

dd_headers = {
 "Content-Type": "application/json",
 "Charset": "UTF-8"
}

dd_message = {
 "msgtype": "text",
 "text": {
  "content": '通知:Hello World'
 }
 }

r = requests.post(url=webhook, headers=dd_headers, data=json.dumps(dd_message))
print(r.text)
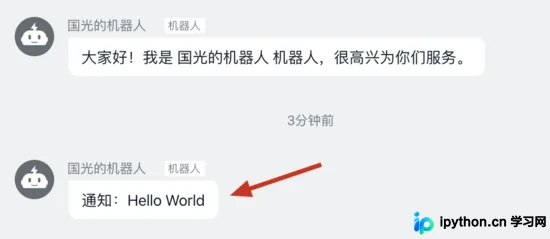
最终通知效果如下:
邮件服务接入方案
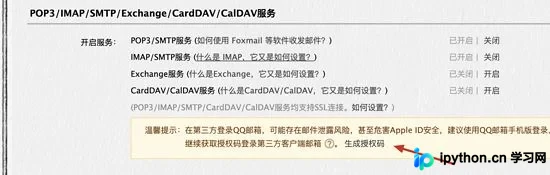
邮件通知以 QQ 邮箱为例,需先开启 POP3/SMTP 服务,并生成授权码:
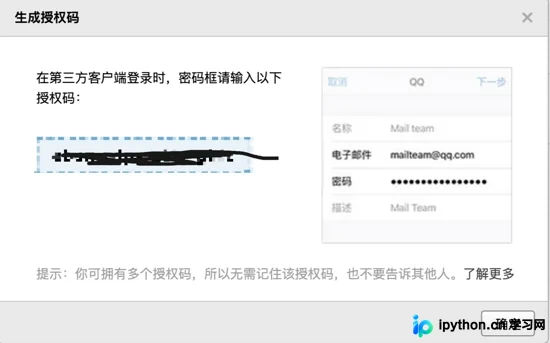
生成的授权码等同于密码,务必妥善保管,切勿外泄:
以下是完整的 Python 调用邮件发送 Demo,填写相应配置信息后即可运行:
import smtplib
from email.mime.text import MIMEText
from email.utils import formataddr

sender = 'admin@sqlsec.com' # 发件人邮箱账号
sender_pass = '***********' # 发件人邮箱密码
receiver = 'admin@sqlsec.com' # 收件人邮箱账号
content = '邮件正文内容'

try:
 msg = MIMEText(content, 'plain', 'utf-8')
 msg['From'] = formataddr(["T00ls 签到提醒", sender]) # 括号里的对应发件人邮箱昵称、发件人邮箱账号
 msg['To'] = formataddr(["", receiver]) # 括号里的对应收件人邮箱昵称、收件人邮箱账号
 msg['Subject'] = "Python 发送邮件测试" # 邮件的主题,也可以说是标题

 server = smtplib.SMTP_SSL("smtp.qq.com", 465)
 server.login(sender, sender_pass) # 括号中对应的是发件人邮箱账号、邮箱密码
 server.sendmail(sender, [receiver, ], msg.as_string()) # 括号中对应的是发件人邮箱账号、收件人邮箱账号、发送邮件
 server.quit() # 关闭连接
 print("邮件发送成功")
except Exception:
 print("邮件发送失败")
功能模块整合
项目开源地址:https://github.com/sqlsec/TuBi
完成钉钉和邮件的独立 Demo 后,进行最终功能整合,完整代码如下:
import time
import json
import random
import smtplib
import requests
from bs4 import BeautifulSoup
from email.mime.text import MIMEText
from email.utils import formataddr

# t00ls 账号配置
username = '国光' # 帐号
password = '***' # 密码MD5 32位(小写)
question_num = 7 # 安全提问 参考下面
question_answer = '***' # 安全提问答案

# 0 = 没有安全提问
# 1 = 母亲的名字
# 2 = 爷爷的名字
# 3 = 父亲出生的城市
# 4 = 您其中一位老师的名字
# 5 = 您个人计算机的型号
# 6 = 您最喜欢的餐馆名称
# 7 = 驾驶执照的最后四位数字

# 选择提醒方式
notice = 2 # 0 = 钉钉 1 = 邮件 2 = 我全都要

# 如果选择钉钉通知的话 请配置下方信息
webhook = 'https://oapi.dingtalk.com/robot/send?access_token=***' # 钉钉机器人的 webhook

# 如果选择邮件通知的话 请配置下方信息
sender = 'admin@sqlsec.com' # 发件人邮箱账号
sender_pass = '***********' # 发件人邮箱密码
receiver = 'admin@sqlsec.com' # 收件人邮箱账号

req_headers = {
 'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_5) AppleWebKit/537.36 (KHTML, like Gecko) Safari/537.36'
}

def t00ls_login(u_name, u_pass, q_num, q_ans):
 """
 t00ls 登录函数
 :param u_name: 用户名
 :param u_pass: 密码的 md5 值 32 位小写
 :param q_num: 安全提问类型
 :param q_ans: 安全提问答案
 :return: 签到要用的 hash 和 登录后的 Cookies
 """

 login_data = {
 'action': 'login',
 'username': u_name,
 'password': u_pass,
 'questionid': q_num,
 'answer': q_ans
 }
 response_login = requests.post('https://www.t00ls.net/login.json', data=login_data, headers=req_headers)
 response_login_json = json.loads(response_login.text)

 if response_login_json['status'] != 'success':
 return None
 else:
 print('用户:', username, '登入成功!')
 formhash = response_login_json['formhash']
 t00ls_cookies = response_login.cookies
 return formhash, t00ls_cookies


def t00ls_sign(t00ls_hash, t00ls_cookies):
 """
 t00ls 签到函数
 :param t00ls_hash: 签到要用的 hash
 :param t00ls_cookies: 登录后的 Cookies
 :return: 签到后的 JSON 数据
 """
 sign_data = {
 'formhash': t00ls_hash,
 'signsubmit': "true"
 }
 response_sign = requests.post('https://www.t00ls.net/ajax-sign.json', data=sign_data, cookies=t00ls_cookies,
     headers=req_headers)
 return json.loads(response_sign.text)


def t00ls_domain(t00ls_hash, t00ls_cookies):
 """
 t00ls 域名查询函数
 :param t00ls_hash: 签到要用的 hash
 :param t00ls_cookies: 登录后的 Cookies
 :return: 查询相关的日志信息
 """
 content = ''
 # 使用站长之家查询今天注册的域名
 start_time = time.time()

 china_url = 'https://whois.chinaz.com/suffix'
 search_data = 'ix=.com&suffix=.cn&c_suffix=&time=1&startDay=&endDay='
 req_headers['Content-Type'] = 'application/x-www-form-urlencoded'
 response_domains = requests.post(url=china_url, headers=req_headers, data=search_data, timeout=10)

 # Bs4 解析器 简单规则过滤一下放入到 domains 的列表中
 soup = BeautifulSoup(response_domains.text, 'html.parser')
 domains = []
 for i in soup.select('.listOther a'):
 if '.' in i.string and '*' not in i.string:
  domains.append(i.string)
 domain = random.sample(domains, 1)[0] # 随机抽取一个 幸运儿

 end_time = time.time()
 print(f'站长之家随机找域名耗时: {end_time - start_time:.4f}秒')
 content += f'\n站长之家随机找域名耗时: {end_time - start_time:.4f}秒\n\n'

 start_time = time.time()

 query_url = 'https://www.t00ls.net/domain.html'
 query_data = f'domain={domain}&formhash={t00ls_hash}&querydomainsubmit=%E6%9F%A5%E8%AF%A2'
 query_status = False
 query_count = 1 # 查询重试次数

 # 如果 t00ls 查询没有成功的话 就一直查询
 while not query_status and query_count < 4:
 domain = random.sample(domains, 1)[0] # 随机抽取一个 幸运儿
 query_data = f'domain={domain}&formhash={t00ls_hash}&querydomainsubmit=%E6%9F%A5%E8%AF%A2'

 try:
  response_query = requests.post(url=query_url, headers=req_headers, data=query_data, cookies=t00ls_cookies)
 except Exception:
  pass

 if domain in response_query.text:
  response_tb = requests.get('https://www.t00ls.net/members-tubilog.json', cookies=t00ls_cookies)
  if domain in response_tb.text:
  print('查询域名成功 TuBi + 1 \n')
  content += '查询域名成功 TuBi + 1\n'
  query_status = True
  else:
  print('糟糕 域名查询成功 但是 TuBi 没有增加 可能域名重复了')
  content += '糟糕 域名查询成功 但是 TuBi 没有增加 可能域名重复了\n'
  query_count += 1
  print(f'随机延时 5-10 秒,继续第 {query_count} 次查询')
  content += f'随机延时 5-10 秒,继续第 {query_count} 次查询\n\n'
  time.sleep(random.randint(5, 10))
 else:
  print(f'查询失败?失败的域名是: {domain}')
  content += f'查询失败?失败的域名是: {domain}\n'
  query_count += 1
  print(f'随机延时 5-10 秒,继续第 {query_count} 次查询')
  content += f'随机延时 5-10 秒,继续第 {query_count} 次查询\n\n'
  time.sleep(random.randint(5, 10))
 if query_count == 4:
  print('重试查询次数已达上限 终止查询')
  content += '重试查询次数已达上限 终止查询\n\n'

 end_time = time.time()
 print(f't00ls 域名查询耗时: {end_time - start_time:.4f}秒')
 content += f't00ls 域名查询耗时: {end_time - start_time:.4f}秒\n'
 return content


def dingtalk(content):
 """
 钉钉通知函数
 :param content: 要通知的内容
 :return: none
 """
 webhook_url = webhook
 dd_headers = {
 "Content-Type": "application/json",
 "Charset": "UTF-8"
 }
 dd_message = {
 "msgtype": "text",
 "text": {
  "content": f'T00ls 签到通知\n{content}'
 }
 }

 r = requests.post(url=webhook_url, headers=dd_headers, data=json.dumps(dd_message))


def mail(content):
 """
 邮件通知函数
 :param content: 要通知的内容
 :return: none
 """
 msg = MIMEText(content, 'plain', 'utf-8')
 msg['From'] = formataddr(["T00ls 签到提醒", sender])
 msg['To'] = formataddr(["", receiver])
 msg['Subject'] = "T00ls 每日签到提醒"

 server = smtplib.SMTP_SSL("smtp.qq.com", 465)
 server.login(sender, sender_pass)
 server.sendmail(sender, [receiver, ], msg.as_string())
 server.quit()


def main():
 content = ''
 response_login = t00ls_login(username, password, question_num, question_answer)
 if response_login:
 response_sign = t00ls_sign(response_login[0], response_login[1])
 if response_sign['status'] == 'success':
  print('签到成功 TuBi + 1')
  content += '\n签到成功 TuBi + 1\n'

  verbose_log = t00ls_domain(response_login[0], response_login[1])
  content += verbose_log

  if notice == 0:
  try:
   dingtalk(content)
  except Exception:
   print('请检查钉钉配置是否正确')
  elif notice == 1:
  try:
   mail(content)
  except Exception:
   print('请检查邮件配置是否正确')
  else:
  try:
   dingtalk(content)
  except Exception:
   print('请检查钉钉配置是否正确')
  try:
   mail(content)
  except Exception:
   print('请检查邮件配置是否正确')
 elif response_sign['message'] == 'alreadysign':
  print('已经签到过啦')
  content += '\n已经签到过啦\n'

  verbose_log = t00ls_domain(response_login[0], response_login[1])
  content += verbose_log

  if notice == 0:
  try:
   dingtalk(content)
  except Exception:
   print('请检查钉钉配置是否正确')
  elif notice == 1:
  try:
   mail(content)
  except Exception:
   print('请检查邮件配置是否正确')
  else:
  try:
   dingtalk(content)
  except Exception:
   print('请检查钉钉配置是否正确')
  try:
   mail(content)
  except Exception:
   print('请检查邮件配置是否正确')
 else:
  print('出现玄学问题了 签到失败')
 else:
 print('登入失败 请检查输入资料是否正确')

if __name__ == '__main__':
 main()
整合后的代码结构略显复杂,印证了“有善始者实繁,能克终者盖寡”的古语。
暂不深究代码优雅性,后续有机会再行优化,以下是运行效果展示:
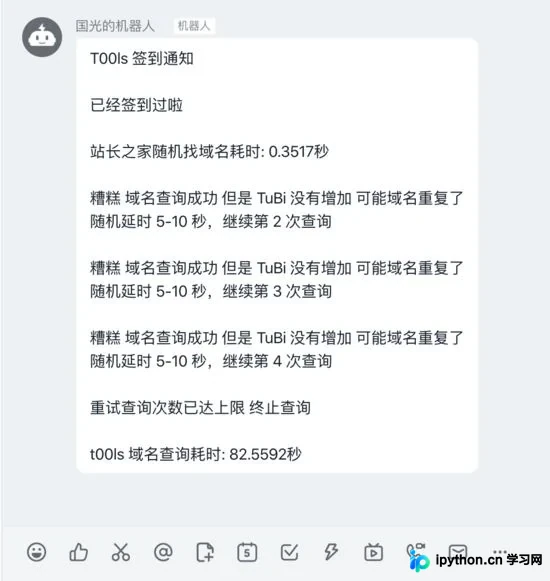
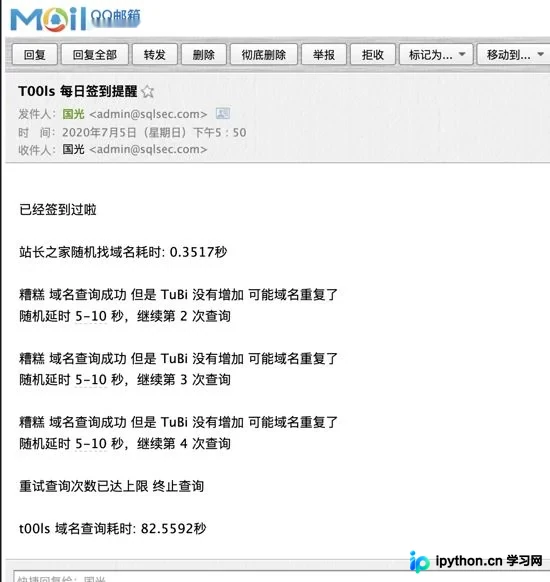
由于当日已完成签到和查询操作,图片显示的结果均为失败状态。
定时任务配置
部分网友使用腾讯云函数或 GitHub Actions 实现自动触发,效果良好。笔者拥有 Web 服务器,故采用 Linux 原生 crontab 命令配置定时任务:
# 查看定时任务
crontab -l

# 编辑定时任务
crontab -e
编辑定时任务文件,每行配置一个任务,本次配置内容如下:
30 9 * * * /usr/bin/python3 /root/code/t00ls/TuBi.py>&1
该配置表示每天 9:30 自动执行以下命令:
/usr/bin/python3 /root/code/t00ls/TuBi.py
若语法无误,系统将返回如下提示:
crontab: installing new crontab
此提示表明定时任务创建成功,此后即可每日自动获取 2 个 TuBi 奖励。
总结
该脚本虽无高深技术难点,但具备较高的实用价值。钉钉 Webhook 调用简便,为后续类似脚本开发提供了参考。无论是开发还是安全领域,探索之路漫长,愿与各位共勉。
至此,关于 Python 实现 T00ls 自动签到脚本(含邮件与钉钉通知)的介绍完毕。更多相关 Python 自动签到脚本内容,欢迎查阅本站往期文章或继续浏览后续内容,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















