


Scrapy框架实现携带Cookie访问淘宝购物车

本文详解如何使用Scrapy框架通过携带Cookie的方式访问淘宝购物车。文章介绍了Scrapy架构,对比了三种登录方式,重点演示了手动提取Cookie并重写start_requests方法的过程。通过具体代码示例,展示了如何绕过登录验证获取购物车页面源码,为后续数据提取奠定基础。
Scrapy框架简介
- Scrapy是一个使用纯Python语言编写的、用于爬取网站数据及提取结构化数据的应用框架,其应用场景十分广泛。
- 该框架具备强大的扩展能力,用户只需定制开发少数几个模块,即可轻松构建出用于抓取网页内容及各类图片的爬虫程序,操作十分便捷。
以下是Scrapy的整体架构图。
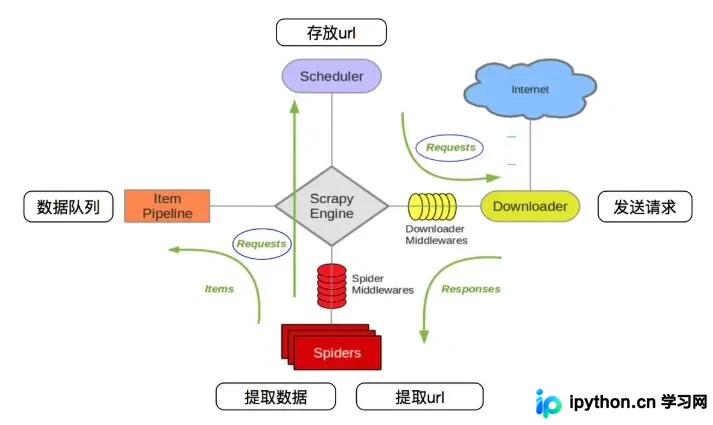
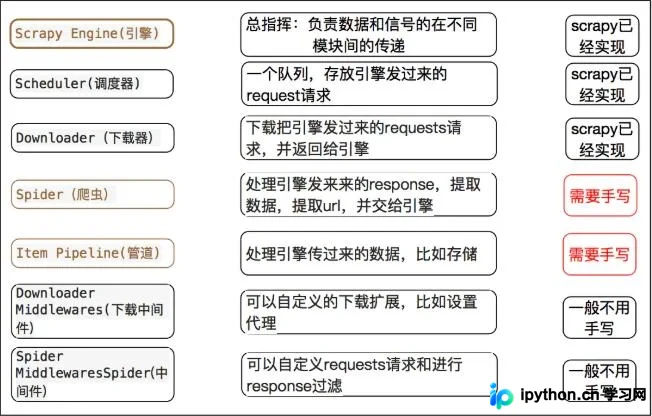
- Engine(引擎):负责协调Spider、ItemPipeline、Downloader和Scheduler之间的通信、信号传递及数据流转。
- Scheduler(调度器):接收来自引擎的Request请求,对其进行整理、排序并加入队列;当引擎需要时,再将请求返回给引擎。
- Downloader(下载器):负责接收引擎发送的所有Request请求,下载完成后将Response返回给引擎,再由引擎转交给Spider处理。
- Spider(爬虫):负责处理所有Response,从中分析并提取数据以获取Item字段所需信息,同时将需要跟进的URL提交给引擎,使其再次进入Scheduler调度。
- Item Pipeline(管道):负责处理Spider获取到的Item,执行后续处理工作,包括详细分析、过滤以及存储等。
- Downloader Middlewares(下载中间件):这是一个允许用户自定义扩展下载功能的组件。
- Spider Middlewares(Spider中间件):这是一个允许用户自定义扩展和操作引擎与Spider之间通信的功能组件,例如处理进入Spider的Response或从Spider发出的Request。
正文开始
众所周知,部分网页内容必须登录才能访问。在Scrapy中实现登录通常有三种方式。
第一种方式是在发起首次请求时直接携带用户名和密码。
第二种方式是必须先访问一次目标地址,服务器会返回一些参数(如验证码、特定的加密字符串等),用户需通过相应手段进行分析与提取,然后在第二次请求中带上这些参数。具体参考可查阅https://www.jb51.net/article/190242.htm。
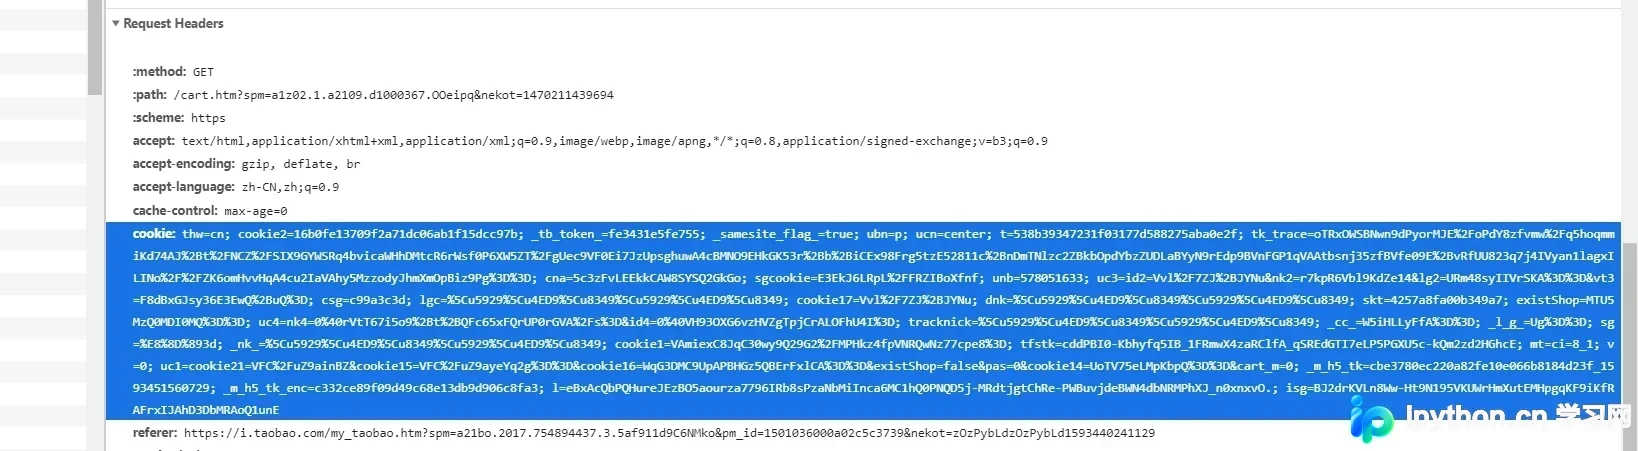
第三种方式无需复杂操作,只需手动登录成功后,提取出Cookie并将其添加到访问头中即可。
本文以第三种方式为例,演示如何在Scrapy中携带Cookie访问淘宝购物车。
首先,手动登录自己的淘宝账号,从中提取Cookie,如下图所示。
接着,在命令行中激活虚拟环境,并创建项目(执行命令:scrapy startproject taobao)。
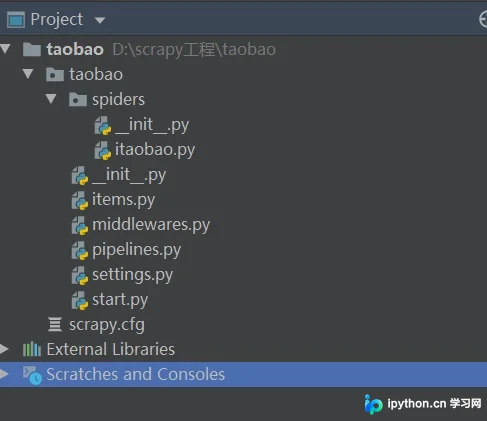
使用PyCharm打开项目目录,在Terminal中输入命令(scrapy genspider itaobao taobao.com),即可得到如下目录结构。
随后,在setting.py中设置相应的配置项。
在itaobao.py中编写业务代码。我们先不加入Cookie直接访问购物车,代码如下:
import scrapy

class ItaobaoSpider(scrapy.Spider):
 name = 'itaobao'
 allowed_domains = ['taobao.com']
 start_urls = [
  'https://cart.taobao.com/cart.htm?spm=a1z02.1.a2109.d1000367.OOeipq&nekot=1470211439694'] # 第一次就直接访问购物车

 def parse(self, response):
  print(response.text)
执行后返回的响应信息如下。
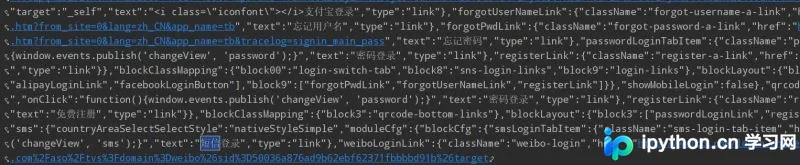
从结果可以看出,这显然是跳转到了登录页面。
回归正题,正确的代码实现需要重写start_requests()方法。该方法用于向爬虫的起始网站返回一个请求,此返回的请求作用等同于start_urls;start_requests()返回的请求会替代start_urls中的请求。
import scrapy

class ItaobaoSpider(scrapy.Spider):
 name = 'itaobao'
 allowed_domains = ['taobao.com']
 # start_urls = ['https://cart.taobao.com/cart.htm?spm=a1z02.1.a2109.d1000367.OOeipq&nekot=1470211439694']
 # 需要重写start_requests方法
 def start_requests(self):
  url = "https://cart.taobao.com/cart.htm?spm=a1z02.1.a2109.d1000367.OOeipq&nekot=1470211439694"
  # 此处的cookie为手动登录后从浏览器粘贴下来的值
  cookie = "thw=cn; cookie2=16b0fe13709f2a71dc06ab1f15dcc97b; _tb_token_=fe3431e5fe755;" \
     " _samesite_flag_=true; ubn=p; ucn=center; t=538b39347231f03177d588275aba0e2f;" \
     " tk_trace=oTRxOWSBNwn9dPyorMJE%2FoPdY8zfvmw%2Fq5hoqmmiKd74AJ%2Bt%2FNCZ%" \
     "2FSIX9GYWSRq4bvicaWHhDMtcR6rWsf0P6XW5ZT%2FgUec9VF0Ei7JzUpsghuwA4cBMNO9EHkGK53r%" \
     "2Bb%2BiCEx98Frg5tzE52811c%2BnDmTNlzc2ZBkbOpdYbzZUDLaBYyN9rEdp9BVnFGP1qVAAtbsnj35zfBVfe09E%" \
     "2BvRfUU823q7j4IVyan1lagxILINo%2F%2FZK6omHvvHqA4cu2IaVAhy5MzzodyJhmXmOpBiz9Pg%3D%3D; " \
     "cna=5c3zFvLEEkkCAW8SYSQ2GkGo; sgcookie=E3EkJ6LRpL%2FFRZIBoXfnf; unb=578051633; " \
     "uc3=id2=Vvl%2F7ZJ%2BJYNu&nk2=r7kpR6Vbl9KdZe14&lg2=URm48syIIVrSKA%3D%3D&vt3=F8dBxGJsy36E3EwQ%2BuQ%3D;" \
     " csg=c99a3c3d; lgc=%5Cu5929%5Cu4ED9%5Cu8349%5Cu5929%5Cu4ED9%5Cu8349; cookie17=Vvl%2F7ZJ%2BJYNu;" \
     " dnk=%5Cu5929%5Cu4ED9%5Cu8349%5Cu5929%5Cu4ED9%5Cu8349; skt=4257a8fa00b349a7; existShop=MTU5MzQ0MDI0MQ%3D%3D;" \
     " uc4=nk4=0%40rVtT67i5o9%2Bt%2BQFc65xFQrUP0rGVA%2Fs%3D&id4=0%40VH93OXG6vzHVZgTpjCrALOFhU4I%3D;" \
     " tracknick=%5Cu5929%5Cu4ED9%5Cu8349%5Cu5929%5Cu4ED9%5Cu8349; _cc_=W5iHLLyFfA%3D%3D; " \
     "_l_g_=Ug%3D%3D; sg=%E8%8D%893d; _nk_=%5Cu5929%5Cu4ED9%5Cu8349%5Cu5929%5Cu4ED9%5Cu8349;" \
     " cookie1=VAmiexC8JqC30wy9Q29G2%2FMPHkz4fpVNRQwNz77cpe8%3D; tfstk=cddPBI0-Kbhyfq5IB_1FRmwX4zaRClfA" \
     "_qSREdGTI7eLP5PGXU5c-kQm2zd2HGhcE; mt=ci=8_1; v=0; uc1=cookie21=VFC%2FuZ9ainBZ&cookie15=VFC%2FuZ9ayeYq2g%3D%3D&cookie" \
     "16=WqG3DMC9UpAPBHGz5QBErFxlCA%3D%3D&existShop=false&pas=0&cookie14=UoTV75eLMpKbpQ%3D%3D&cart_m=0;" \
     " _m_h5_tk=cbe3780ec220a82fe10e066b8184d23f_1593451560729; _m_h5_tk_enc=c332ce89f09d49c68e13db9d906c8fa3; " \
     "l=eBxAcQbPQHureJEzBO5aourza7796IRb8sPzaNbMiInca6MC1hQ0PNQD5j-MRdtjgtChRe-PWBuvjdeBWN4dbNRMPhXJ_n0xnxvO.; " \
     "isg=BJ2drKVLn8Ww-Ht9N195VKUWrHmXutEMHpgqKF9iKfRAFrxIJAhD3DbMRAoQ1unE"
  cookies = {}
  # 提取键值对 请求头中携带cookie必须是一个字典,所以要把原生的cookie字符串转换成cookie字典
  for cookie in cookie.split(';'):
   key, value = cookie.split("=", 1)
   cookies[key] = value
  yield scrapy.Request(url=url, cookies=cookies, callback=self.parse)
 def parse(self, response):
  print(response.text)
此时的响应信息如下(部分片段)。
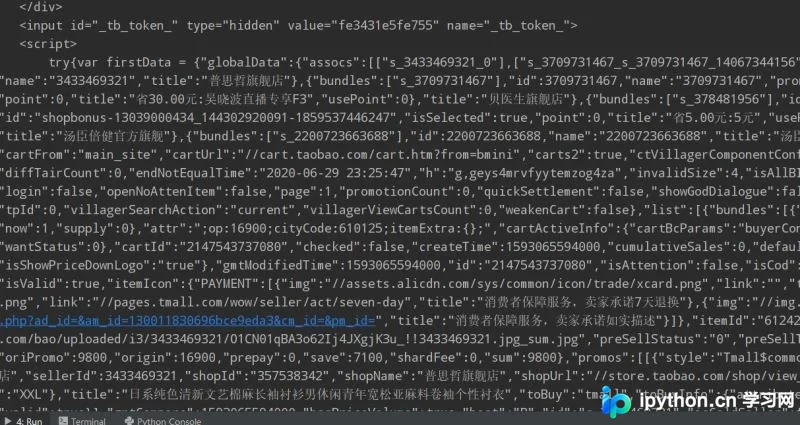
很明显,这是购物车的真实源代码。
至此,主要功能已完成,接下来即可根据业务需求,使用xpath(或个人偏好的方式)提取所需信息。
总结
到此,关于Scrapy框架携带Cookie访问淘宝购物车的文章介绍完毕。如需了解更多Scrapy框架及Cookie相关内容,请搜索本站历史文章或继续浏览后续相关文章。希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















