



很多人知道 LuaJIT 很快,但真正落到线上脚本时,性能差距往往不只是“开没开 JIT”这么简单。判断一段 Lua 代码能不能跑出 LuaJIT 的速度,关键在于它是否能被顺利编译成 trace,以及运行过程中有没有踩到 NYI(Not Yet Implemented)限制。
下面就用一个实际示例把这件事拆开来看:先解释 JIT 在 LuaJIT 里是怎么工作的,再看 `string.find()` 在不同版本中的表现,最后结合实测结果总结出几条更实用的优化判断依据。
JIT 到底解决了什么问题
JIT,Just-In-Time,即“即时编译”,指的是在程序运行过程中完成代码编译,而不是像传统 AOT(Ahead-Of-Time,提前编译)那样在运行前一次性完成。
它通常不是用来完全替代解释器,而是和解释执行协同工作:绝大多数代码先按解释方式运行;当某段代码被反复执行、达到阈值后,JIT 编译器会把这段“热点代码”编译成机器码。后续再次运行到这里时,就可以直接执行机器码,省掉重复解释的开销。
像 Java、Python(这里主要指 PyPy)、LuaJIT 都引入了这种技术。它的核心价值不只是“更快”,而是把编译成本集中花在真正反复运行的代码上。
LuaJIT 的执行流程是怎样的
LuaJIT 是按需编译的。函数不会在程序启动时全部编译,而是在真正执行到、并且有足够热度时才进入 JIT 流程。这样做有两个直接好处:
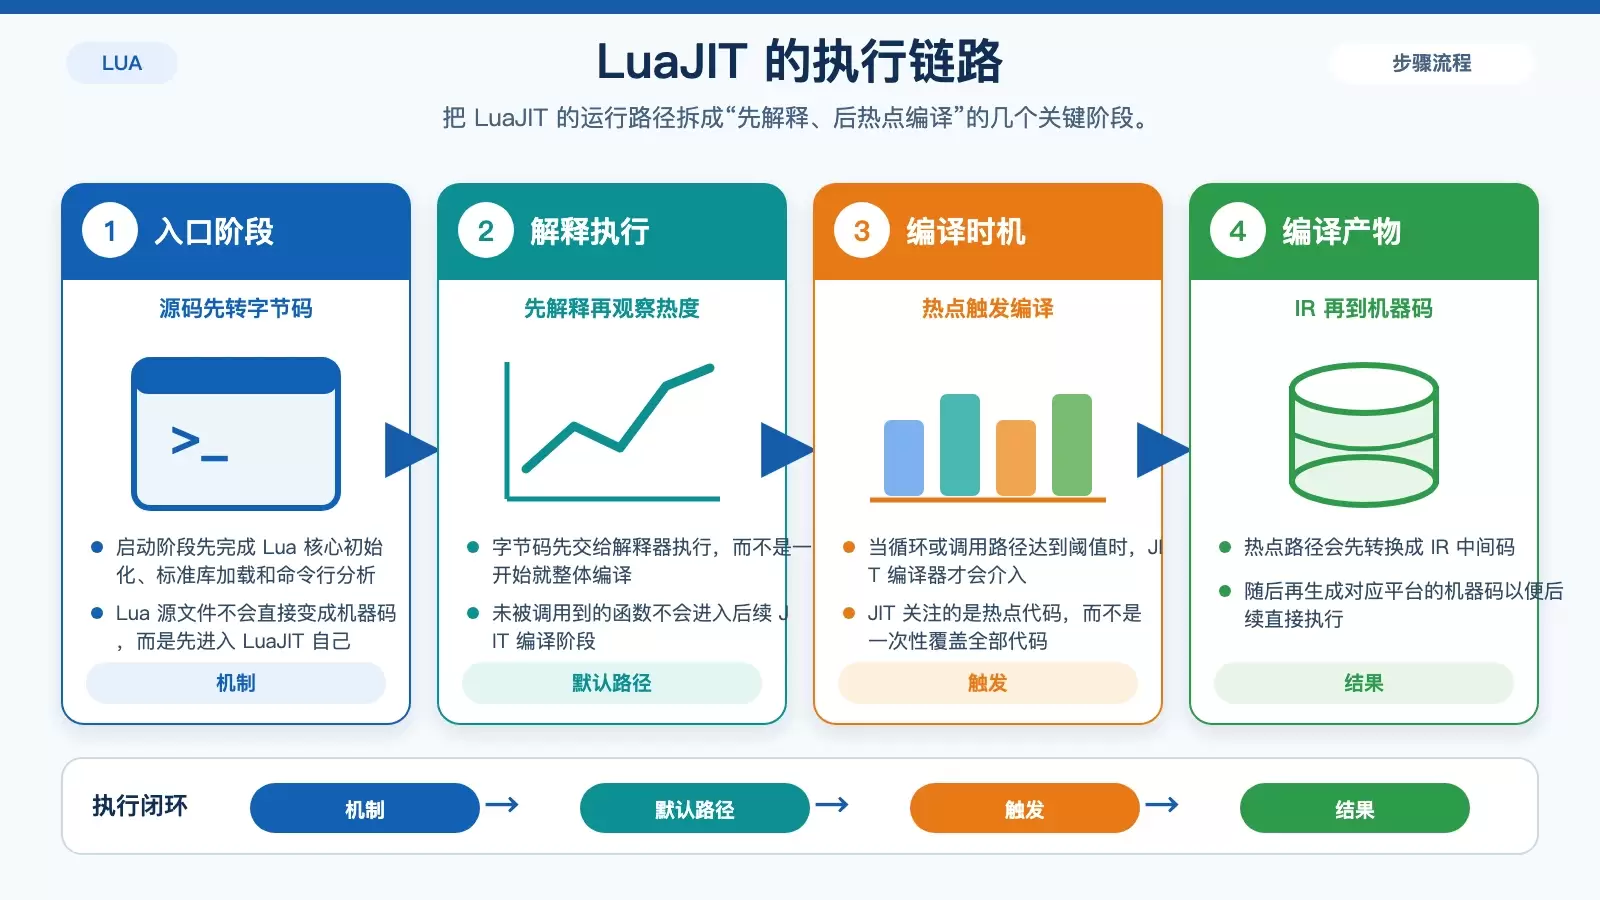
- 启动更快,避免一开始就做大量编译工作;
- 没有被调用到的代码,根本不会进入编译阶段。
和标准 Lua 一样,LuaJIT 启动后会先初始化 Lua 核心、加载标准库并处理命令行参数。随后,Lua 源文件会先被转换成 LuaJIT 自己定义的字节码,再交给解释器执行。只有当某些路径足够“热”时,JIT 编译器才会介入,把这段代码进一步转换成 IR 中间码,最后再生成对应平台的机器码。
示例代码:一个足够热的双层循环
下面这段代码会反复调用 `string.find()`,很适合观察 LuaJIT 是否能顺利完成热点编译:
local s = "hello,world!"

for i=1,10000 do
    for j=1,10000 do
        string.find(s, "ll", 1, true)
    end
end
先看字节码:LuaJIT 第一阶段做了什么
可以先用下面的命令查看这段代码被编译出来的 LuaJIT 字节码:
$ luajit -bl example.lua
-- BYTECODE -- example.lua:0-8
0001    KSTR     0   0      ; "hello,world!"
0002    KSHORT   1   1
0003    KSHORT   2 10000
0004    KSHORT   3   1
0005    FORI     1 => 0019
0006 => KSHORT   5   1
0007    KSHORT   6 10000
0008    KSHORT   7   1
0009    FORI     5 => 0018
0010 => GGET     9   1      ; "string"
0011    TGETS    9   9   2  ; "find"
0012    MOV     10   0
0013    KSTR    11   3      ; "ll"
0014    KSHORT  12   1
0015    KPRI    13   2
0016    CALL     9   1   5
0017    FORL     5 => 0010
0018 => FORL     1 => 0006
0019 => RET0     0   1
这里可以把它理解为:Lua 源码先变成 LuaJIT 字节码,解释器据此执行;一旦某个循环或调用路径足够频繁,LuaJIT 再尝试把热点路径编译成更低层的 IR 和机器码。
为什么会出现 NYI,trace 又代表什么
LuaJIT 并不是能把所有 Lua 代码都编译成机器码。编译成功后,它会生成一个 `trace` 类型的 `GC` 对象;但如果在编译过程中遇到当前版本尚不支持的函数或代码形式,就会中止这次编译,退回解释器继续执行。
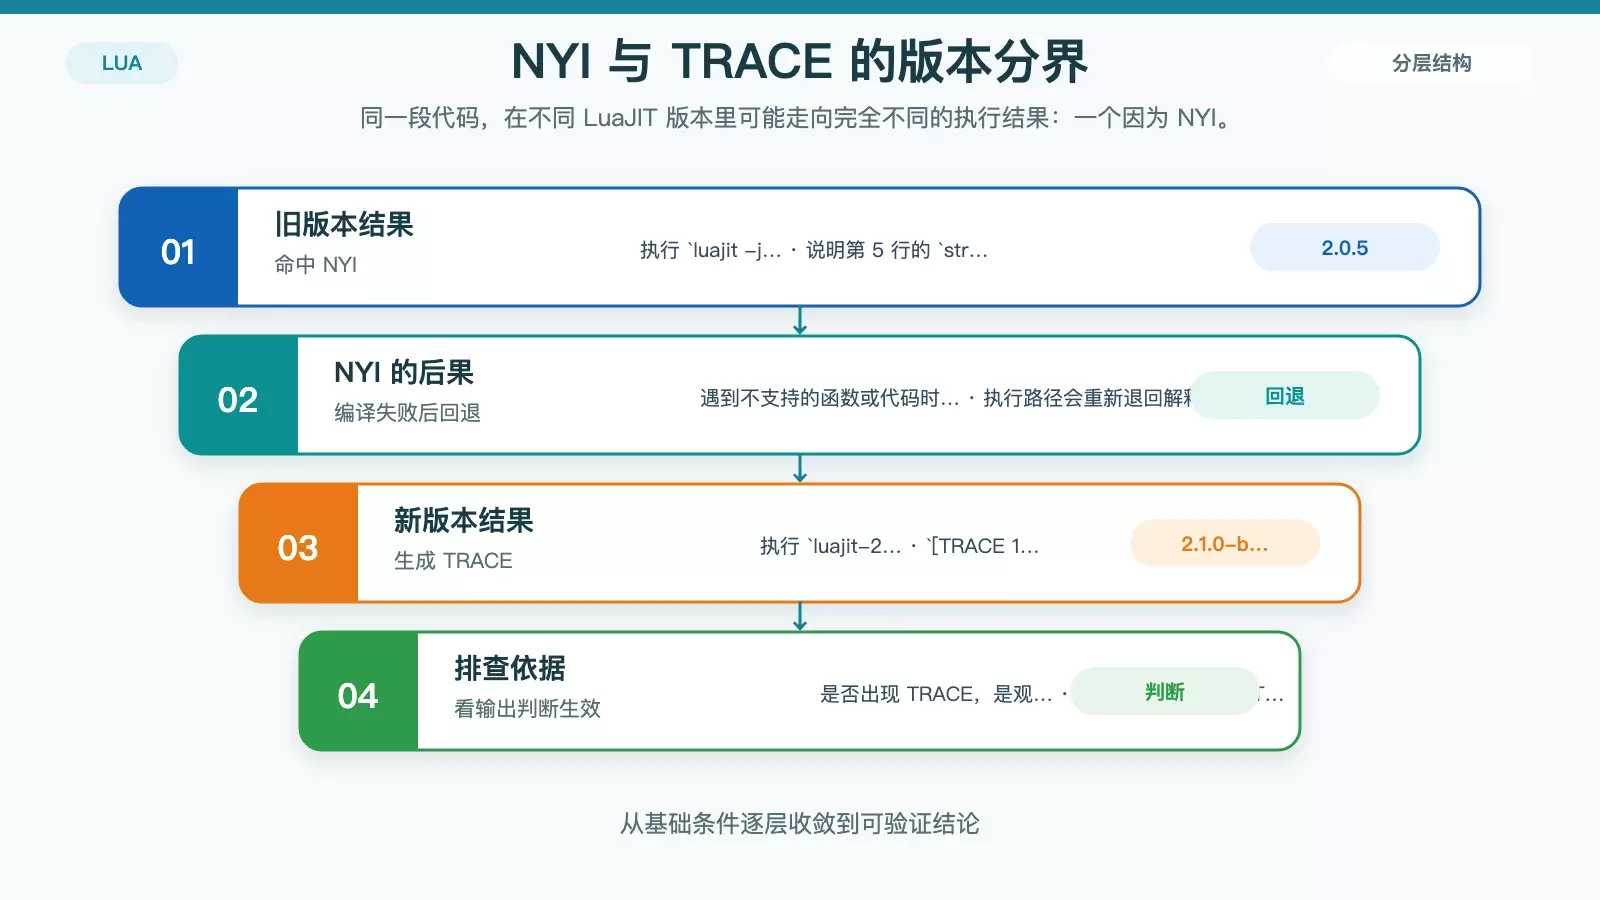
这种“暂未实现”的限制通常就叫 NYI,完整写法是 Not Yet Implemented。
`string.find()` 在不同版本里的差异
上面的示例里,`string.find()` 就是一个很典型的版本差异案例。文中的结论是:只有 `LuaJIT 2.1` 以上版本才支持把这个调用纳入 JIT 编译。
可以使用 `-jv` 选项观察 JIT 编译器的详细进度。
$ luajit -v
LuaJIT 2.0.5 -- Copyright (C) 2005-2017 Mike Pall. http://luajit.org/

$ luajit -jv example.lua
[TRACE --- example.lua:4 -- NYI: FastFunc string.find at example.lua:5]
当版本是 `LuaJIT 2.0.5` 时,这里的 `NYI: FastFunc string.find at example.lua:5` 就是在明确告诉你:`example.lua` 第 `5` 行的 `string.find(s, "ll", 1, true)` 无法被当前 JIT 编译器处理,所以这条热点路径没有成功生成 trace。
换到 `luajit-2.1.0-beta3` 后,再执行同样的命令:
$ luajit-2.1.0-beta3 -jv example.lua
[TRACE   1 example.lua:4 loop]
[TRACE   2 (1/3) example.lua:3 -> 1]
这里 `TRACE` 后面跟着编号,说明 LuaJIT 已经成功为这段热点代码生成了 trace,JIT 编译真正生效了。
想让 LuaJIT 保持高速,重点看哪些地方
如果目标是稳定发挥 LuaJIT 的性能,重点不是盲目追求“代码看起来更底层”,而是尽量让热点路径能持续留在 JIT 可编译区间里。
1. 尽量避开 NYI 函数
一旦热点路径中遇到 NYI,LuaJIT 就可能中止当前编译并回退到解释执行。对于高频调用代码,这种回退会直接影响吞吐量。
2. 调用 C 函数时优先考虑 `ffi`
如果必须和 C 层交互,尽量使用 LuaJIT 自带的 `ffi` 库来调用 C 函数。这通常比走传统绑定方式更有利于保持性能。
3. 尽量使用更新的 LuaJIT 版本
`LuaJIT 2.1` 相比 `2.0.5` 增加了许多原本属于 NYI 的支持项,`string.find()` 就是一个直接例子。版本越新,可被 JIT 编译的函数范围通常越大,热点路径也越容易真正进入 trace。
4. 必须用 NYI 时,优先找替代方案
如果业务里确实需要某些 NYI 函数,可以先查找社区里是否已有替代实现,或者看看 `OpenResty` 等项目中有没有成熟写法。对高频路径来说,替代实现往往比继续保留 NYI 更值得。
实测:能否进入 JIT,速度能差多少
为了更直观地看出差异,可以直接拿同一份 `example.lua`,分别用 `LuaJIT 2.0.5` 和 `LuaJIT 2.1.0-beta3` 运行。
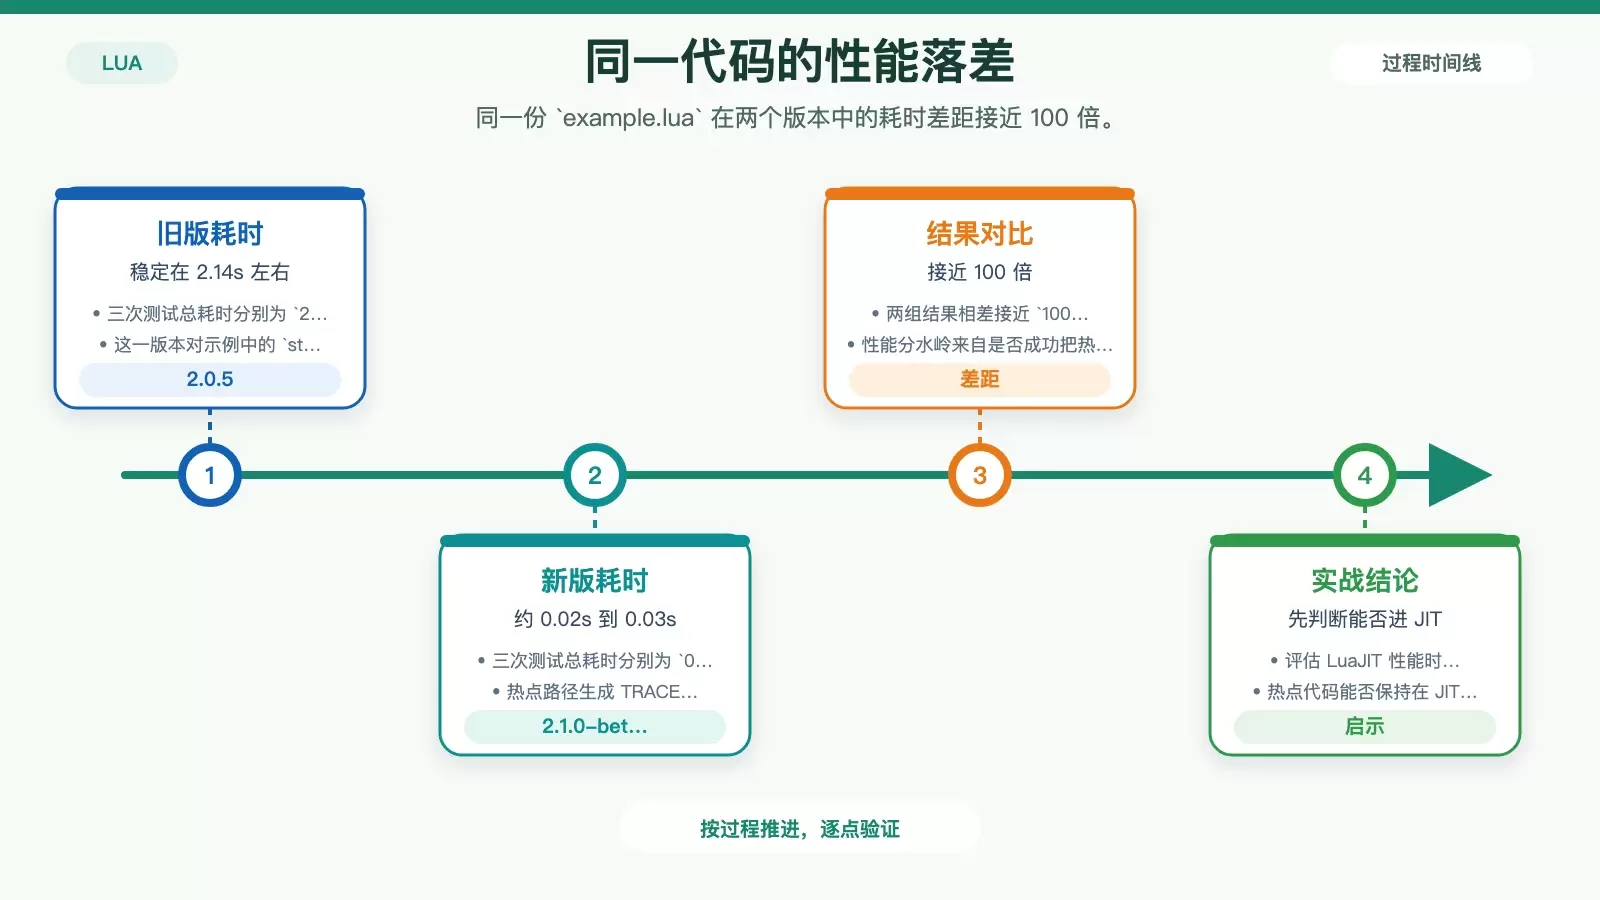
由于 `LuaJIT 2.0.5` 对 `string.find()` 的 JIT 编译不支持,这段代码在该版本中基本无法触发有效的 JIT 优化;而 `2.1.0-beta3` 则可以。
测试代码
local s = "hello,world!"

for i=1,10000 do
    for j=1,10000 do
        string.find(s, "ll", 1, true)
    end
end
LuaJIT 2.0.5 的执行速度
# 第一次测试
$ time luajit-2.0.5 example.lua
luajit-2.0.5 example.lua  2.14s user 0.00s system 99% cpu 2.140 total

# 第二次测试
$ time luajit-2.0.5 example.lua
luajit-2.0.5 example.lua  2.17s user 0.00s system 99% cpu 2.169 total

# 第三次测试
$ time luajit-2.0.5 example.lua
luajit-2.0.5 example.lua  2.17s user 0.00s system 99% cpu 2.176 total
LuaJIT 2.1.0-beta3 的执行速度
# 第一次测试
$ time luajit-2.1.0-beta3 example.lua
luajit-2.1.0-beta3 example.lua  0.03s user 0.00s system 99% cpu 0.026 total

# 第二次测试
$ time luajit-2.1.0-beta3 example.lua
luajit-2.1.0-beta3 example.lua  0.02s user 0.00s system 99% cpu 0.024 total

# 第三次测试
$ time luajit-2.1.0-beta3 example.lua
luajit-2.1.0-beta3 example.lua  0.03s user 0.00s system 99% cpu 0.026 total
从这组结果可以直接看出,两者速度差了接近 `100 倍`。这里真正拉开差距的,不只是“版本号更新了”,而是 `2.1.0-beta3` 已经能把这段热点路径成功编译成 trace,而 `2.0.5` 还会卡在 NYI 上。
结论:LuaJIT 快不快,关键看热点代码能不能被编译
LuaJIT 的高性能并不是自动发生的。源码会先转成字节码,由解释器执行;只有热点路径被成功追踪并编译成机器码,性能优势才会真正释放出来。
因此,判断 LuaJIT 是否能带来收益,至少要看三件事:当前版本是否支持相关函数、热点路径里有没有 NYI、以及关键调用是否能稳定生成 `TRACE`。对线上项目来说,这比单纯比较“Lua 和 LuaJIT 谁更快”更有实际意义。















