



作者:vivo 互联网服务器团队 / Wang Zhi
在常规的生产消费模型里,跨进程解耦通常会先想到 RocketMQ 或 Kafka,但一旦叠加“按游戏维度聚合”“单次最多批量上报 128 个行为”“只处理前 3 分钟内数据”这些约束,标准 MQ 并不能直接把问题解决完。这篇文章把原始方案重新拆开,说明为什么最终选择用 Redis List + Set + Lua 脚本实现一个“定长、可批量消费、允许丢弃旧数据”的伪消息中间件,以及这套方案到底适合哪些业务场景。
业务场景先定边界:这不是通用消息队列问题
技术选型首先要服从业务目标。在这里,系统需要按游戏维度收集和上报行为数据,而且不是无限保留,而是执行“尽最大努力交付”,允许少量数据丢弃。
具体约束主要有三条:
- 按游戏维度进行批量上报;
- 同一款游戏支持 128 个行为批量上报;
- 上报数据必须控制在上报时刻前 3 分钟内。
这意味着,系统关心的不只是“把消息送到消费者”,还包括:
- 消息必须先按游戏分组;
- 消费时要能按组批量读取;
- 旧数据过期后可以被覆盖或丢弃;
- 消费速度要尽量持续快于生产速度。
为什么没有直接上 MQ,而是转向 Redis
方案一:RocketMQ / Kafka 只解决了中转,没有解决分组与时效
如果采用 RocketMQ 或 Kafka 来存储上报消息,消息本身可以可靠进入队列,但消费侧仍然要在业务进程里自行处理以下问题:
- 按游戏维度拆分消息;
- 在满足批量性的前提下组织上报;
- 在满足时效性的前提下触发消费。
也就是说,MQ 在这里更像是“消息中转站”,并没有直接解决业务场景中的核心限制。
方案二:Redis 定长队列更贴近目标
最终采用的做法,是基于 Redis 的基础数据结构拼出一套轻量消息模型:
- 用 List 为每个游戏保存行为消息,形成按游戏拆分的定长队列;
- 用另一个 List 保存“当前存在待消费数据的游戏列表”;
- 用 Set 做去重,避免同一游戏被重复放入游戏列表。
在这个设计里,按游戏分组由 key 天然完成,批量消费由 LRANGE 提供,时效性则通过业务侧多线程消费和过期控制共同保证。对于高频游戏,还可以单独分配线程池,让热门队列优先被处理。
整体结构:三个 Redis 对象分工协作
这套方案可以理解为一个“按游戏拆分的伪 MQ”。它的核心不是单一队列,而是三个对象的配合:
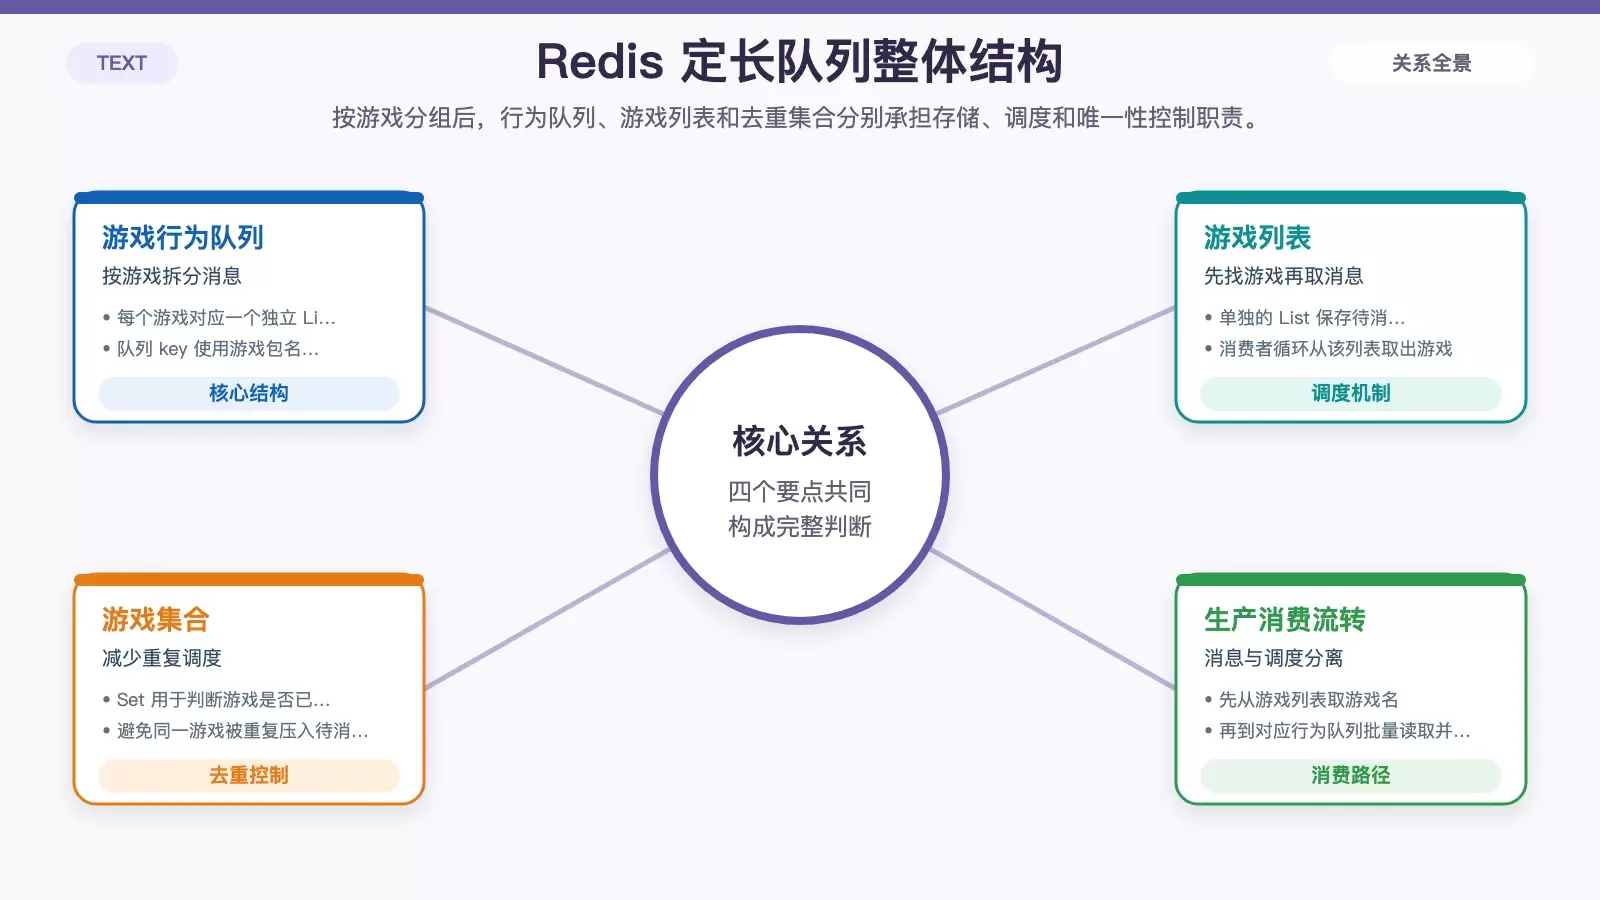
- 游戏行为队列:以游戏包名作为 key,对应一个定长 List,保存该游戏的行为消息;
- 游戏列表:保存当前有哪些游戏存在待消费数据;
- 游戏集合:用于判断游戏是否已进入待消费列表,避免重复压入。
生产过程怎么走
步骤一:游戏维度的某行为数据 PUSH 到该游戏自己的队列中。
步骤二:判断该游戏是否已存在于游戏 Set 中;如果存在,直接返回;如果不存在,进入步骤三。
步骤三:把该游戏 PUSH 到游戏列表中,等待消费者轮询。
消费过程怎么走
步骤一:从游戏列表中循环取出一个游戏。
步骤二:根据该游戏对应的行为数据队列,批量获取消息并处理。
这个思路的重点在于:消息和调度分离。每个游戏的实际行为数据放在自己的 List 中,而“哪些游戏现在值得消费”则由独立的游戏列表来驱动。
实现原理:用 Lua 把多条 Redis 命令包成原子操作
这套方案能稳定运行,关键不只是 Redis List,而是 Lua 脚本的原子性。因为无论是“判断长度后再裁剪并写入”,还是“先批量读取再裁剪剩余数据”,都不能拆成多个无保护命令交给客户端逐条执行。
Lua 脚本提供了什么能力
EVAL script numkeys key [key ...] arg [arg ...]
    时间复杂度:取决于脚本本身的执行的时间复杂度。

> eval "return {KEYS[1],KEYS[2],ARGV[1],ARGV[2]}" 2 key1 key2 first second
1) "key1"
2) "key2"
3) "first"
4) "second"

Redis uses the same Lua interpreter to run all the commands.
Also Redis guarantees that a script is executed in an atomic way:
no other script or Redis command will be executed while a script is being executed.
This semantic is similar to the one of MULTI / EXEC.
From the point of view of all the other clients the effects of a script are either still not visible or already completed.
Redis 对 Lua 脚本的保证很直接:脚本执行期间,不会插入其他 Redis 命令,效果类似 MULTI / EXEC。因此,多条命令可以作为一个原子动作执行。
在本文场景里,Lua 的作用主要有三点:
- 把多条 List 命令合并为一次原子执行,避免并发下队列状态错乱;
- 支撑定长队列写入与批量消费;
- 在 Redis 集群模式下,尽量保持单 key 操作,减少多 key 带来的问题。
List 如何实现定长队列
生产阶段依赖的核心命令是 LLEN、LPOP 和 RPUSH。
LLEN key
    计算List的长度
    时间复杂度:O(1)。

LPOP key [count]
    从List的左侧移除元素
    时间复杂度:O(N),N为移除元素的个数。

RPUSH key element [element ...]
    从List的右侧保存元素
    时间复杂度:O(N),N为保存元素的个数。
组合方式很简单:
- 先用
LLEN判断当前队列长度; - 如果未达到上限,直接
RPUSH; - 如果已经达到上限,先
LPOP丢掉最旧元素,再RPUSH写入新元素。
这样就得到一个固定长度、先进先出、允许覆盖旧数据的队列模型。
List 如何实现批量消费
消费阶段依赖的核心命令是 LRANGE 和 LTRIM。
LRANGE key start end
    时间复杂度:O(S+N), S为偏移量start, N为指定区间内元素的数量。

    下标(index)参数 start 和 stop 都以 0 为底,也就是说,以 0 表示列表的第一个元素,以 1 表示列表的第二个元素,以此类推。
    你也可以使用负数下标,以 -1 表示列表的最后一个元素, -2 表示列表的倒数第二个元素,以此类推。

LTRIM key start stop
    时间复杂度:O(N) where N is the number of elements to be removed by the operation.

    修剪(trim)一个已存在的 list,这样 list 就会只包含指定范围的指定元素。
组合逻辑同样直接:
- 先用
LRANGE批量取出一段数据; - 再用
LTRIM保留剩余数据,相当于“消费后出队”。
只要这两步放在同一个 Lua 脚本里,就能避免“刚读完数据还没裁剪,就被其他线程重复消费”的问题。
Set 在这里主要负责去重
SADD key member [member ...]
    往Set集合添加数据。
    时间复杂度:O(1)。

SISMEMBER key member
    判断Set集合是否存在元素。
    时间复杂度:O(1)。
Set 的职责比较单一:判断某个游戏是否已经进入待消费列表,避免重复调度。这一步不复杂,但对整体轮询效率影响很大。
生产消息:用 Lua 保证“定长写入 + 过期时间”一次完成
定义LUA脚本
    CACHE_NPPA_EVENT_LUA =
        "local retVal = 0 " +
        "local key = KEYS[1] " +
        "local num = tonumber(ARGV[1]) " +
        "local val = ARGV[2] " +
        "local expire = tonumber(ARGV[3]) " +
        "if (redis.call('llen', key) < num) then redis.call('rpush', key, val) " +
        "else redis.call('lpop', key) redis.call('rpush', key, val) retVal = 1 end " +
        "redis.call('expire', key, expire) return retVal";


执行LUA脚本
    String data = JSON.toJSONString(nppaBehavior);
    Long retVal = (Long)jedisClusterTemplate.eval(CACHE_NPPA_EVENT_LUA, 1, NPPA_PREFIX + nppaBehavior.getGamePackage(), String.valueOf(MAX_GAME_EVENT_PER_GAME), data, String.valueOf(NPPA_TTL_MINUTE * 60));

执行效果
    实现固长队列的数据存储并设置过期时间
这段脚本做了三件事:
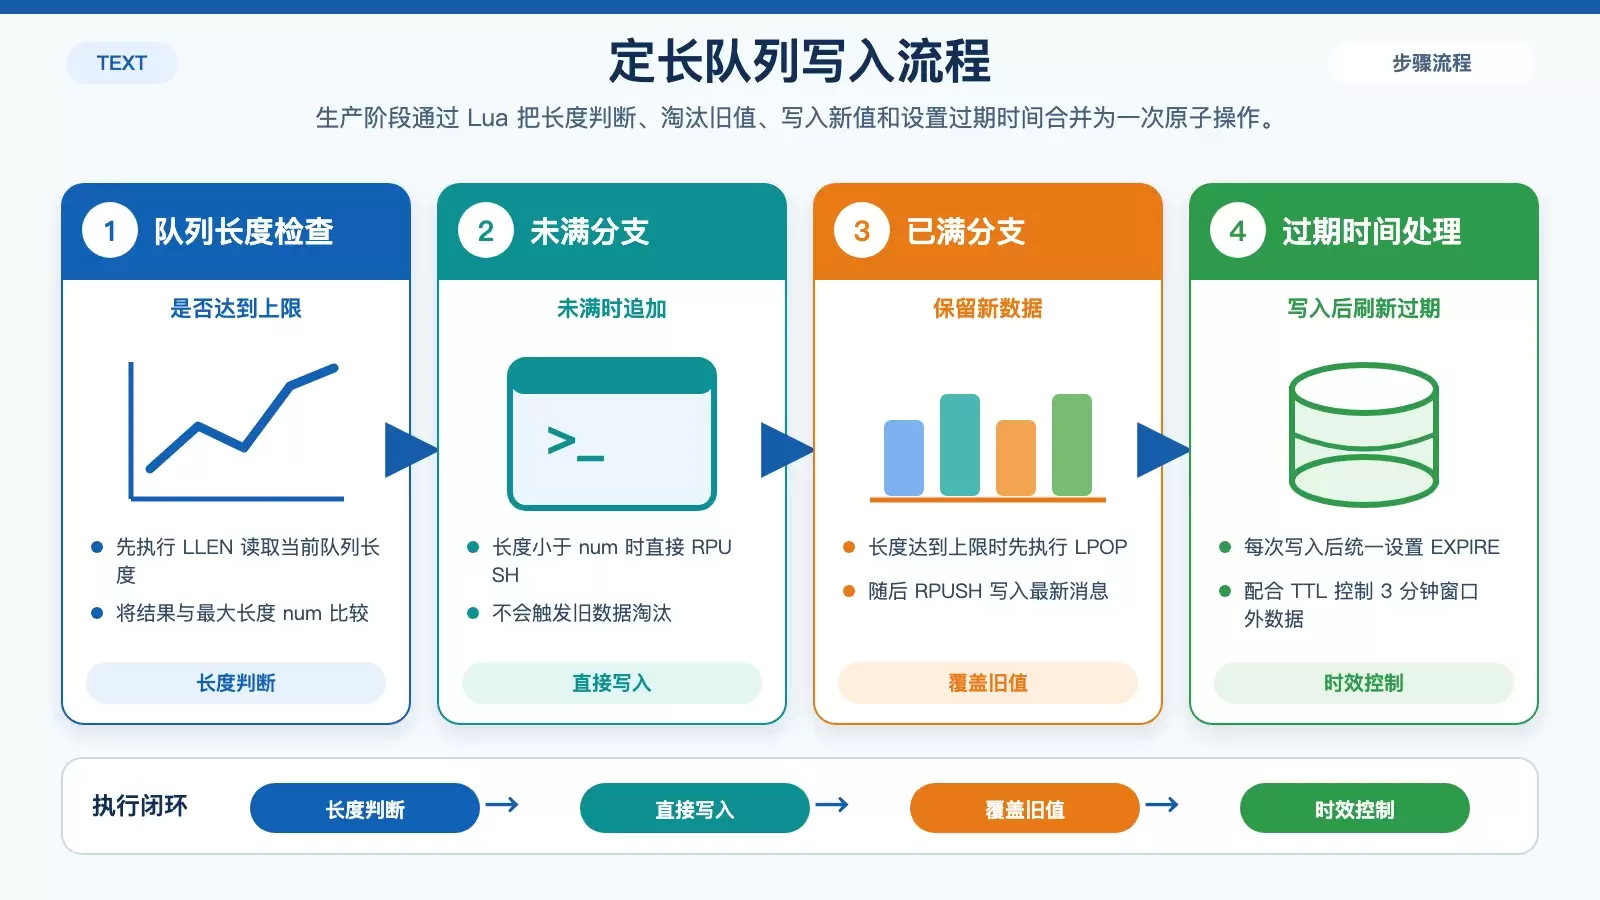
- 判断当前游戏队列是否达到上限;
- 达到上限时淘汰最旧数据,再写入新数据;
- 每次写入后都刷新过期时间。
它对应的是一种很明确的业务取舍:宁可丢弃更旧的数据,也要保证队列长度可控,并优先保留更接近当前时刻的数据。
消费消息:批量读取后立即裁剪,避免重复处理
定义LUA脚本
    QUERY_NPPA_EVENT_LUA =
        "local data = {} " +
        "local key = KEYS[1] " +
        "local num = tonumber(ARGV[1]) " +
        "data = redis.call('lrange', key, 0, num) redis.call('ltrim', key, num+1, -1) return data";

执行LUA脚本
    Integer batchSize = NppaConfigUtils.getInteger("nppa.report.batch.size", 1);
    Object result = jedisClusterTemplate.eval(QUERY_NPPA_EVENT_LUA, 1, NPPA_PREFIX + gamePackage, String.valueOf(batchSize));

执行效果
    取固定数量的对象,然后保留队列的剩余的消息对象。
这里的关键点是“先取后裁”,但两步必须在脚本内一起完成。这样可以确保批量消费的边界清晰,也能减少客户端协调成本。
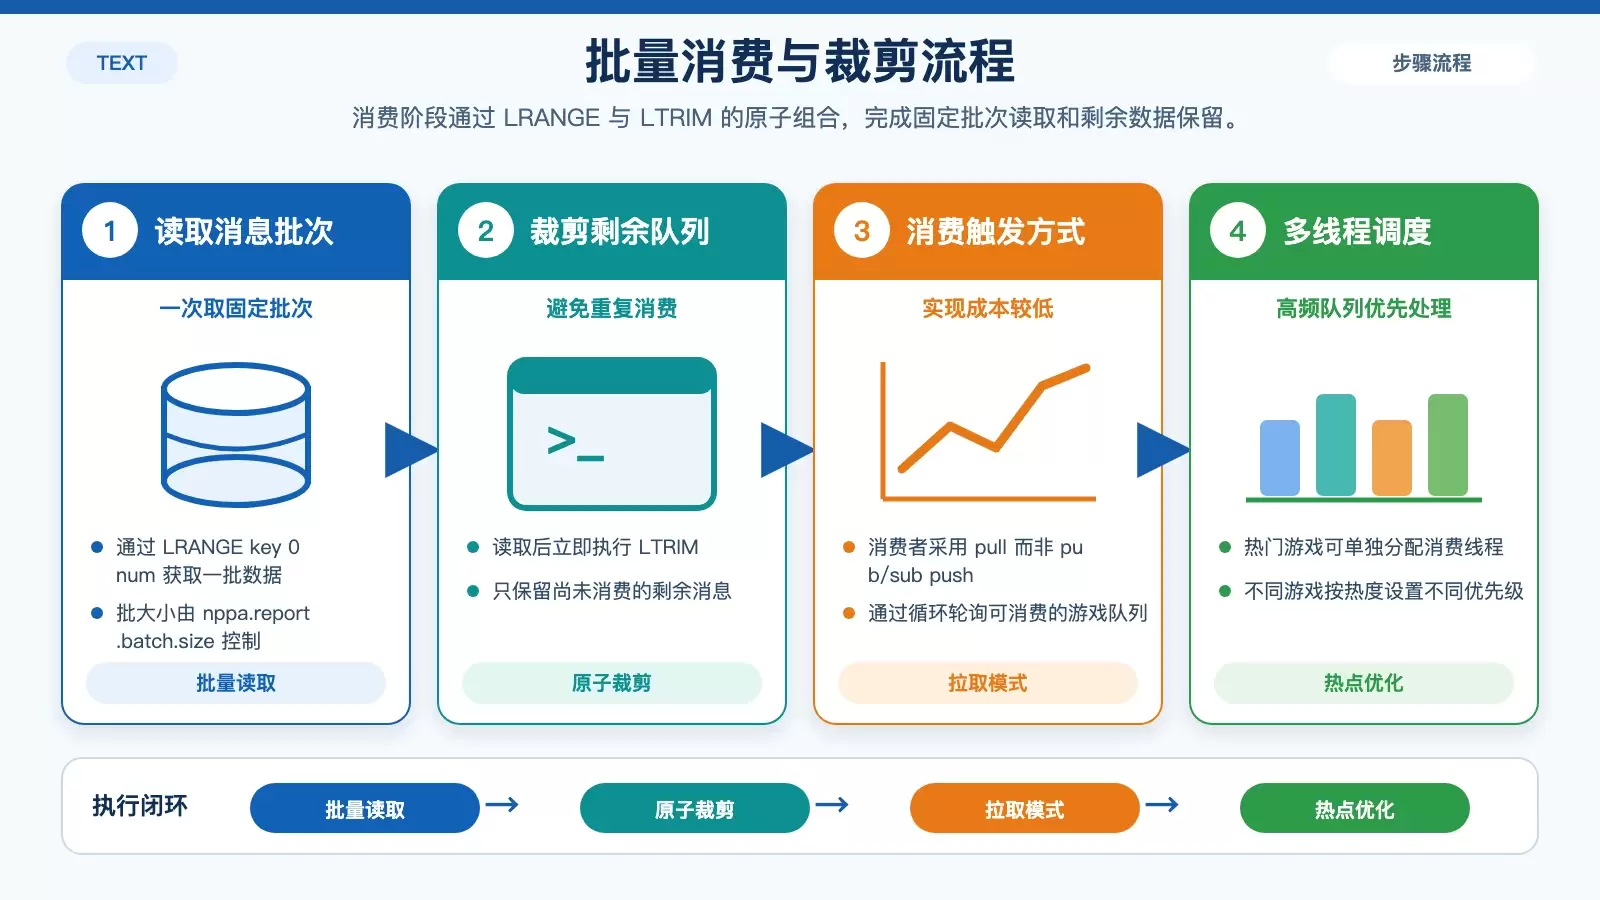
在线程模型上,文中采用的是 pull 模式:消费者多线程循环轮询可消费队列。相较于依赖 Redis pub/sub 通知的 push 模式,这种方式实现成本更低,在这个场景下也更容易控制节奏。
落地时要注意的几个点
1. Redis 集群下,Lua 脚本尽量只传单 key
在 Redis 集群模式中,执行 Lua 脚本建议传入单 key。多 key 操作容易触发重定向错误,这也是这类方案设计时要主动回避的限制。
2. 不同 Redis 版本对 Lua 的 null 返回处理可能不同
如果脚本需要处理空结果,实际行为要以对应版本的官方文档为准,不能直接假设所有版本完全一致。
3. 热门游戏要单独处理消费优先级
不同游戏的流量热度并不一致。如果所有游戏共用完全相同的轮询节奏,热点游戏可能堆积得更快。文中的处理方式是:通过配置为热门游戏单独开启消费线程,相当于给不同游戏设置不同优先级。
线上效果:约 1w QPS,批量上报后出口压力更低
这套方案已经在线上运行,文中的核心结果有两个:
- 生产和消费的 QPS 约为 1w qps;
- 经过批量上报后,真正对外的上报 QPS 会明显低于内部消息生产和消费 QPS。
另外,数据是按游戏包名作为 key 存储的,因此在这个场景下,性能上不存在明显热点问题。
这套方案适合什么场景,不适合什么场景
从本质上看,这不是在 Redis 上复刻一个通用 MQ,而是在特定约束下实现一个“够用”的轻量消息模型。它比较适合下面这类问题:
- 单条生产、批量消费;
- 需要按业务维度分组,例如按游戏、租户、设备或渠道拆分;
- 允许丢弃旧数据,重点保留最新窗口内的数据;
- 更关注吞吐、时效和实现成本,而不是完整消息语义。
除了消息场景,这种结构也可以降级成一个先进先出的定长日志队列。
但如果业务要求强一致投递、严格顺序保证、复杂重试、消费确认、死信处理等完整消息能力,那么它就不该替代成熟 MQ。
总结
这次实践的价值,不在于“Redis 能不能当 MQ 用”,而在于先把业务约束拆清楚,再用最贴近目标的数据结构组合出可落地方案。通过 Lua 脚本把 LLEN + LPOP + RPUSH 组合成定长写入,把 LRANGE + LTRIM 组合成批量消费,再配合 Set 去重和多线程 pull 模式,这套方案最终实现了按游戏分组、固定长度保留、批量上报和时效控制,并且已经在线上平稳运行。















