



在高并发库存扣减场景里,单靠 Redis 原生事务并不能完全替代 MySQL 那种“可判断、可中止、可回滚”的处理方式:命令虽然会顺序执行,但业务失败不会自动阻断后续步骤,也没有传统意义上的回滚能力。本文结合一个库存扣减案例,说明为什么要把关键校验逻辑写进 Lua 脚本,以及这种方案在初始化库存、执行扣减、防重复和集群部署时分别要注意什么,帮助你判断它是否适合自己的业务链路。
Redis 事务为什么还需要 Lua 补位
Redis 事务的基本特点是:把多条命令打包后按顺序执行,执行过程中不会被其他客户端请求打断,因此具备原子执行特征。
但这里有一个很关键的限制:如果事务中的某条命令因为业务原因失败,并不会阻止后续命令继续执行,已经执行过的命令也不能像 MySQL 事务那样直接回滚。
这也是很多库存、额度、幂等控制场景会引入 Lua 脚本的原因。Lua 脚本可以在 Redis 侧完成简单逻辑判断、提前返回、中止后续处理,把“判断 + 修改”收敛为一次原子操作。
先看一个 Redis Lua 脚本的基础写法
Lua 是一个轻量脚本语言,Redis 从 2.6 版本开始内嵌支持 Lua 环境,常用执行命令是 EVAL。在 Redis 里写 Lua 脚本,重点不是语法复杂度,而是把多个 Redis 命令封装成一个可以原子执行的业务动作。
下面这个示例脚本用于检测 key 是否存在;如果存在,就把过期时间延长 60000 毫秒。
--[[
    version:1.0
    检测key是否存在,如果存在并设置过期时间
    入参列表:
        参数个数量:1
        KEYS[1]:goodsKey 商品Key

    返回列表code:
        +0:不存在
        +1:存在
--]]
local usableKey = KEYS[1]

--[ 判断usableKey在Redis中是否存在 存在将过期时间延长1分钟 并返回是否存在结果--]
local usableExists = redis.call('EXISTS', usableKey)
if (1 == usableExists) then
    redis.call('PEXPIRE', usableKey, 60000)
end
return { usableExists }
这段脚本里要看懂的几个点
redis.call()是 Redis 提供的内置方法,用来在脚本里执行 Redis 命令。if () then end是 Lua 的基础分支语法。KEYS用于接收 Redis key 参数;普通变量参数通过ARGV接收。--表示单行注释,--[[ ... --]]表示多行注释。
库存扣减场景里,为什么 Lua 比普通事务更合适
需求本身很直接
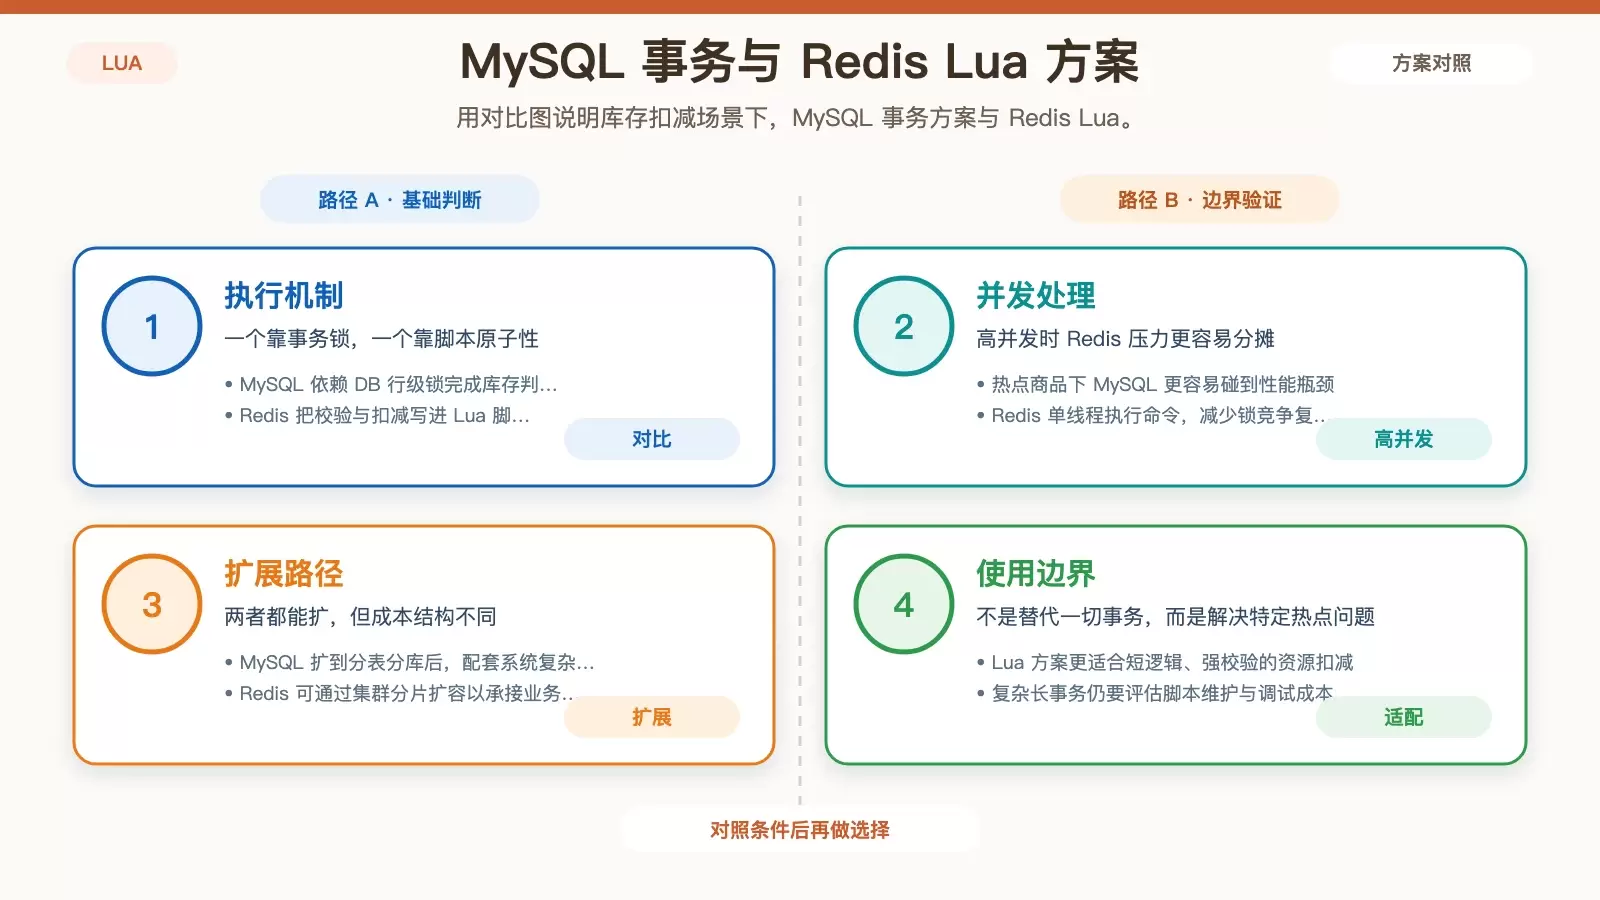
经典案例是“库存扣减并校验库存是否充足”:当商品当前库存量 >= 扣减数量时执行扣减;当商品当前库存量 < 扣减数量时返回库存不足。
如果用 MySQL 事务怎么做
- 利用 DB 行级锁锁定库存记录,再判断库存是否充足,充足则扣减,否则返回库存不足。
- 扣减后再检查结果是否小于
0,如果小于0说明超扣,事务回滚;否则提交事务。
它的优点很明显:MySQL 天然支持事务,实现门槛低。
问题也很明显:一旦遇到热点商品、高并发请求,MySQL 容易成为瓶颈;当单库支撑不住时,后续分表、分库及配套运维体系都会带来额外复杂度。
换成 Redis Lua 脚本的思路
Redis Lua 方案的核心是:把“校验库存是否足够、执行扣减、处理失败结果、防止重复操作”等最小原子逻辑写进一段脚本里,让 Redis 以单线程方式一次执行完。
- 先从 DB 初始化商品库存到 Redis,并借助
WATCH做并发初始化控制。 - 脚本内先判断库存是否充足,充足再扣减,否则直接返回库存不足。
- 如果扣减后结果小于
0,则反向补回库存并返回失败结果。
原文给出的优点包括:
- Redis 单线程执行命令,无须引入复杂锁竞争处理。
- Redis 原生支持 Lua,学习成本低,实现复杂度和 MySQL 方案相当。
- 同一时间单位内 Redis 的并发承载能力更高,执行耗时更小。
- 业务增长后可以通过 Redis 集群分片扩容。
需要额外补充的一点是,这种方案更适合“逻辑短、判断集中、结果明确”的原子操作,而不是把复杂业务编排全部塞进脚本里。
库存初始化:用 WATCH 控制并发写入
在正式扣减前,通常需要先把库存从 DB 初始化到 Redis。这里原文采用的是 WATCH + MULTI + EXEC 的方式,利用乐观锁特性减少锁竞争。
//利用Watch 命令乐观乐特性,减少锁竞争所损耗的性能
 public boolean init(InitStockCallback initStockCallback, InitOperationData initOperationData) {
 //SessionCallback 会话级Rdis事务回调接口 针对于operations所有操作将在同一个Redis tcp连接上完成
List<Object> result = stringRedisTemplate.execute(new SessionCallback<List<Object>>() {
            public List<Object> execute(RedisOperations operations) {
                Assert.notNull(operations, "operations must not be null");
//Watch 命令用于监视一个(或多个) key ,如果在事务执行之前这个(或这些) key 被其他命令所改动,那么事务将被打断
//当出前并发初始化同一个商品库存量时,只有一个能成功
                operations.watch(initOperationData.getWatchKeys());
                int initQuantity;
                try {
//查询DB商品库存量
                    initQuantity = initStockCallback.getInitQuantity(initOperationData);
                } catch (Exception e) {
                    //异常后释放watch
                    operations.unwatch();
                    throw e;
                }
//开启Reids事务
                operations.multi();
//setNx设置商品库存量
                operations.opsForValue().setIfAbsent(initOperationData.getGoodsKey(), String.valueOf(initQuantity));
//设置商品库存量 key 过期时间
                operations.expire(initOperationData.getGoodsKey(), Duration.ofMinutes(60000L));
///执行事事务
                return operations.exec();
            }
        });
//判断事务执行结果
        if (!CollectionUtils.isEmpty(result) && result.get(0) instanceof Boolean) {
            return (Boolean) result.get(0);
        }
        return false;
    }
这一段实现的关键点
watch()监视库存相关 key,防止并发初始化同一商品时重复写入。- 库存初始值来自 DB,异常时会先
unwatch()释放监视状态。 - 事务内通过
setIfAbsent写入初始库存,只允许首次成功。 - 同时为库存 key 设置过期时间,避免无效数据长期驻留。
这里需要注意,示例里使用了 Duration.ofMinutes(60000L),这表示的是 60000 分钟,并非 60000 毫秒或 60 分钟。站在实现角度,这属于非常值得复核的配置点。
核心扣减脚本:把校验、扣减、防重放进一次原子执行
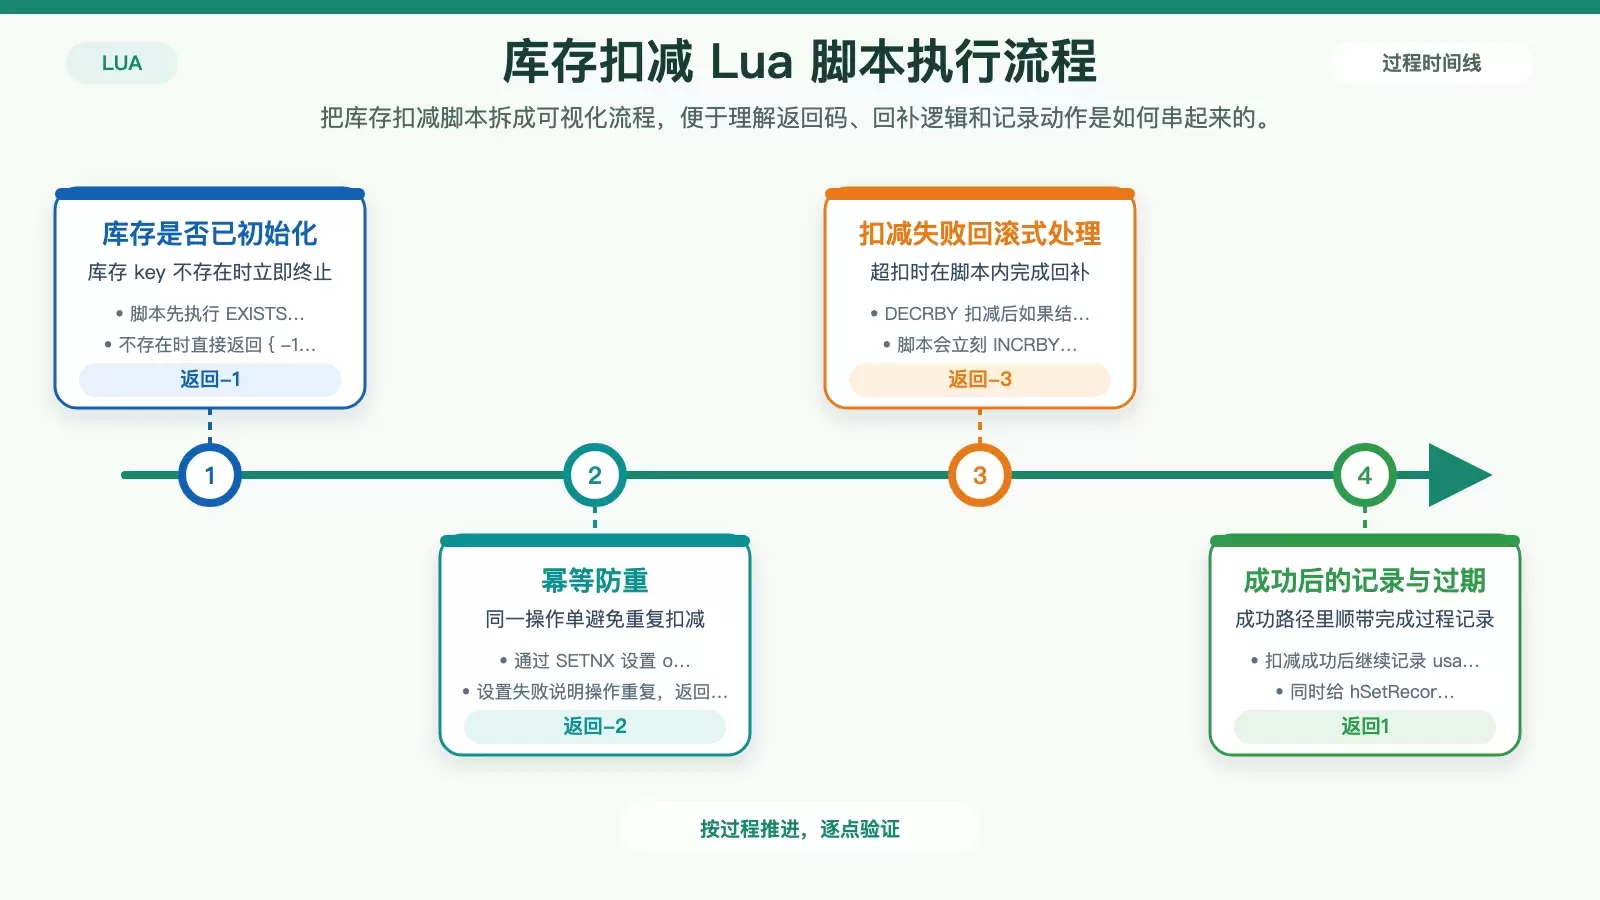
真正体现 Lua 价值的,是库存扣减脚本本身。原文脚本把 key 是否存在、幂等防重、库存扣减、失败回补、扣减记录和过期时间设置都放到了同一次执行里。
--[[
    version:1.0
    减可用库存
    入参列表:
        参数个数量:
        KEYS[1]:usableKey 商品可用量Key
        KEYS[3]:usableSubtractKey 减量记录key
        KEYS[4]:operateKey 操作防重Key
        KEYS[5]:hSetRecord 记录操作单号信息
        ARGV[1]:quantity操作数量
        ARGV[2]:version 操作版本号
        ARGV[5]:serialNumber 单据流水编码
        ARGV[6]:record 是否记录过程量
    返回列表:
        +1:操作成功
         0: 操作失败
        -1: KEY不存在
        -2:重复操作
        -3: 库存不足
        -4:过期操作
        -5:缺量库存不足
        -6:可用负库存
--]]
local usableKey = KEYS[1];
local usableSubtractKey = KEYS[3]
local operateKey = KEYS[4]
local hSetRecord = KEYS[5]

local quantity = tonumber(ARGV[1])
local version = ARGV[2]
local serialNumber = ARGV[5]

--[ 判断商品库存key是否存在 不存在返回-1 --]
local usableExists = redis.call('EXISTS', usableKey);
if (0 == usableExists) then
    return { -1, version, 0, 0 };
end

--[ 设置防重key 设置失败说明操作重复返回-2 --]
local isNotRepeat = redis.call('SETNX', operateKey, version);
if (0 == isNotRepeat) then
    redis.call('SET', operateKey, version);
    return { -2, version, quantity, 0 };
end

--[ 商品库存量扣减后小0 说明库存不足 回滚扣减数量 并清除防重key立即过期 返回-3 --]
local usableResult = redis.call('DECRBY', usableKey, quantity);
if ( usableResult < 0) then
    redis.call('INCRBY', usableKey, quantity);
    redis.call('PEXPIRE', operateKey, 0);
    return { -3, version, 0, usableResult };
end

--[ 记录扣减量并设置防重key 30天后过期 返回 1--]
-- [ 需要记录过程量与过程单据信息 --]
local usableSubtractResult = redis.call('INCRBY', usableSubtractKey, quantity);
redis.call('HSET', hSetRecord, serialNumber, quantity)
redis.call('PEXPIRE', hSetRecord, 3600000)
redis.call('PEXPIRE', operateKey, 2592000000)
redis.call('PEXPIRE', usableKey, 3600000)
return { 1, version, quantity, 0, usableResult ,usableSubtractResult}
这段脚本实际完成了什么
- 先用
EXISTS判断库存 key 是否存在,不存在直接返回-1。 - 再用
SETNX设置防重 key;如果失败,说明是重复操作,返回-2。 - 通过
DECRBY扣减库存,如果扣减后小于0,立刻用INCRBY补回,并让防重 key 立即过期,返回-3。 - 扣减成功后,再记录累计扣减量、单据流水信息,并设置相关 key 的过期时间。
为什么这种写法适合高并发扣减
关键不在于 Lua 语法本身,而在于这些动作在 Redis 内部被串成了一次不可被打断的执行流程。相比把“查库存、判断、扣减、写防重”拆成多次客户端请求,这种方式更容易守住强校验要求。
当然,脚本返回码也意味着客户端必须对结果做明确分支处理,比如 -1 是库存未初始化,-2 是重复请求,-3 是库存不足,这些都应该进入各自的业务分支,而不是简单按布尔值判断成功失败。
脚本如何加载到 Redis,以及如何执行
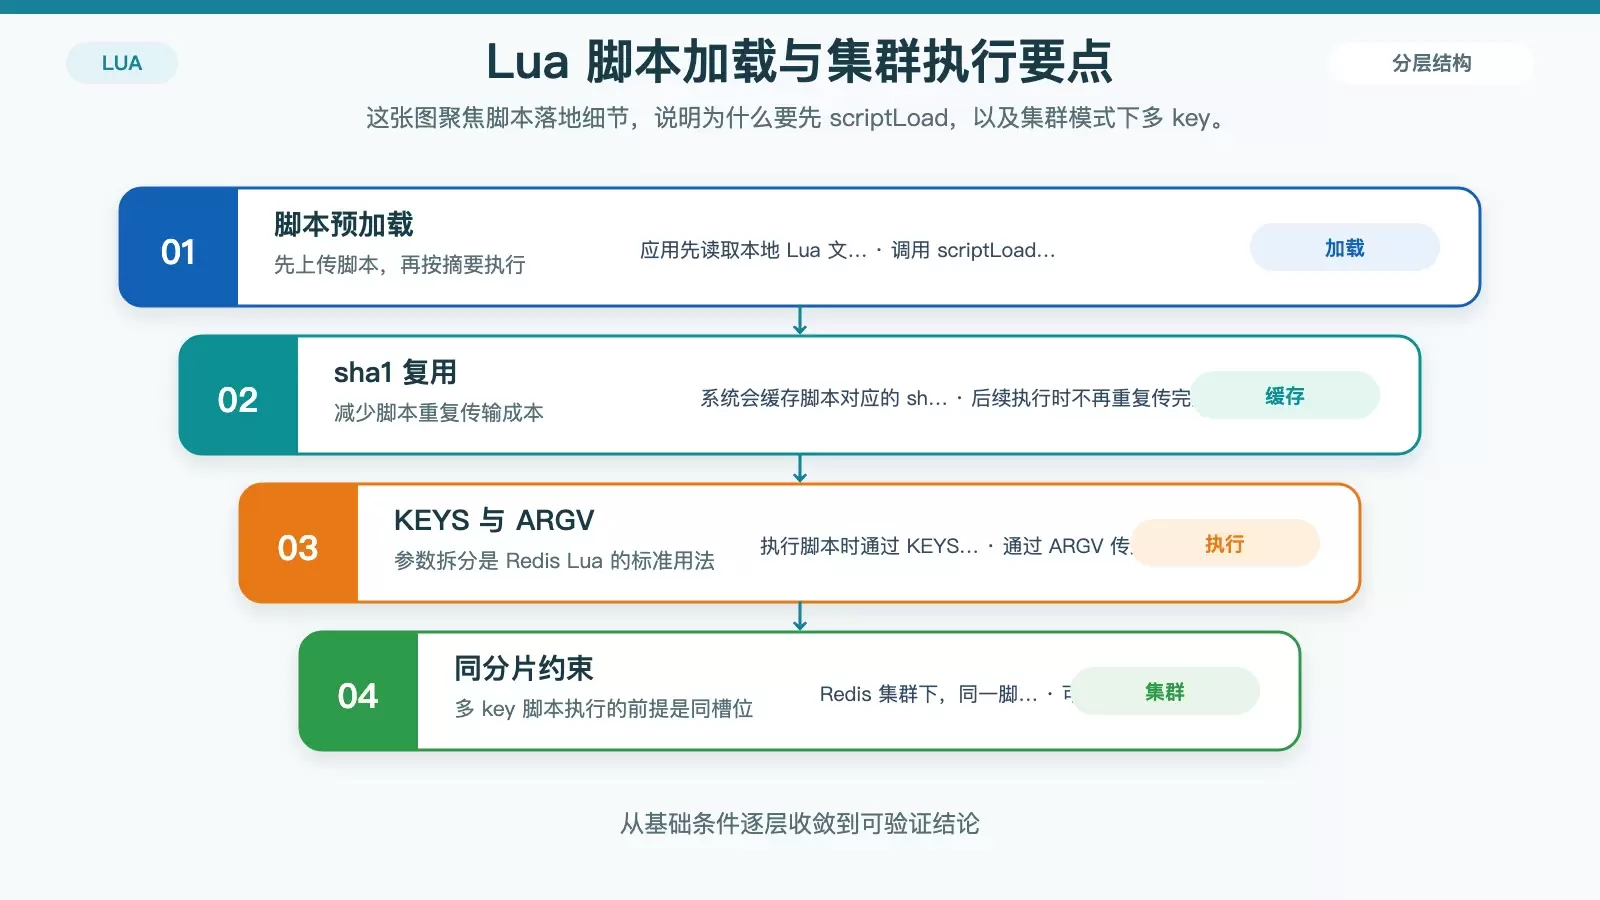
为了避免每次都传完整脚本文本,原文采用了先加载脚本、获取 sha1,后续再按摘要执行的方式。
1. 把 Lua 脚本加载到 Redis 服务器
//读取Lua脚本文件
    private String readLua(File file) {
        StringBuilder sbf = new StringBuilder();
        try (BufferedReader reader = new BufferedReader(new FileReader(file))) {
            String temp;
            while (Objects.nonNull(temp = reader.readLine())) {
                sbf.append(temp);
                sbf.append('n');
            }
            return sbf.toString();
        } catch (FileNotFoundException e) {
            LOGGER.error("[{}]文件不存在", file.getPath());
        } catch (IOException e) {
            LOGGER.error("[{}]文件读取异常", file.getPath());
        }
        return null;
    }
//初始化Lua脚本到Redis服务器 成功后会返回脚本对应的sha1码,系统缓存脚本sha1码,
//通过sha1码可以在Redis服务器执行对应的脚本
public String scriptLoad(File file) {
String script = readLua(file)
   return stringRedisTemplate.execute((RedisCallback<String>) connection -> connection.scriptLoad(script.getBytes()));
}
这里的核心流程是:读取 Lua 文件内容,调用 scriptLoad 上传到 Redis,拿到对应的 sha1 后缓存起来,后续直接按摘要执行。
2. 执行脚本时传入 KEYS 和 ARGV
 public OperationResult evalSha(String redisScriptSha1,OperationData operationData) {
        List<String> keys = operationData.getKeys();
        String[] args = operationData.getArgs();
//执行Lua脚本 keys 为Lua脚本中使用到的KEYS args为Lua脚本中使用到的ARGV参数
//如果是在Redis集群模式下,同一个脚本中的多个key,要满足多个key在同一个分片
//服务器开启hash tag功能,多个key 使用{}将相同部分包裹
//例:usableKey:{EMG123} operateKey:operate:{EMG123}
Object result = stringRedisTemplate.execute(redisScriptSha1, keys, args);
//解析执行结果
return parseResult(operationData, result);
    }
集群模式下有一个很容易踩坑的点
如果 Redis 运行在集群模式,同一个 Lua 脚本里涉及多个 key,这些 key 必须落在同一个分片上。原文给出的做法是使用 hash tag,把多个 key 的相同部分放进 {} 中。
例如:
usableKey:{EMG123}
operateKey:operate:{EMG123}
这样 Redis 才会把相关 key 路由到同一个槽位,脚本才能正常执行。
这类方案适合什么场景,不适合什么场景
原文总结提到,Redis 在小数据操作下并发可达到 10W,对于业务中“强校验 + 高并发”的资源操作场景,Redis 配合 Lua 脚本是一个可行方案。
但使用边界也很明确:
- Lua 脚本逻辑应尽量简单,适用于耗时短、原子性强的操作。
- 脚本执行过长会占用 Redis 单线程,影响服务器整体性能。
- 如果逻辑过于复杂,调试、排错和维护成本都会明显上升。
比较理想的状态,是把 Lua 脚本封装成一个“像 Redis 原生命令一样”的业务动作:输入明确、返回码稳定、执行路径短,这样既能发挥 Redis 的高并发优势,也不容易把脚本本身变成新的复杂点。
作者:京东物流 王纯
来源:京东云开发者社区 自猿其说Tech















