


Python运行效率低下的核心原因与字典操作优化策略

Python侧重编码效率而非运行效率,其动态类型、解释执行、GIL限制及GC机制导致性能瓶颈。本文深入解析Python运行慢的底层原因,并通过对比字典填充时的异常处理与键检查策略,提供具体的性能优化代码示例。
Python运行效率低下的核心原因
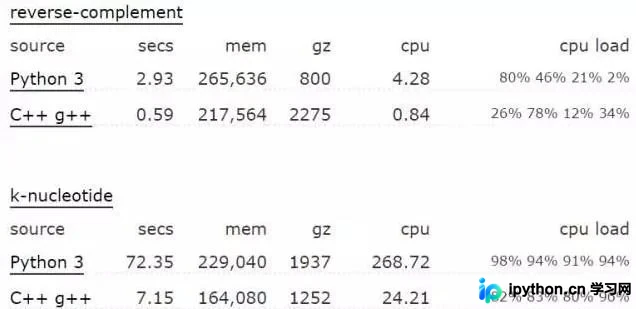
Python的设计哲学侧重于编码效率,而非运行效率。通常情况下,Python的运行速度比C++慢几倍到几十倍。这种性能差异主要源于以下几个底层机制:
- 动态类型与编译优化缺失:Python是动态语言,类型在运行时确定。这导致编译器无法在编译期进行类型推断和优化,增加了运行时的开销。
- 对象模型复杂:在Python中,一切皆对象。每个对象都需要维护引用计数,这增加了内存管理的复杂性。
- 解释执行与无JIT:Python采用解释执行方式,且不支持即时编译(JIT)编译器,无法像其他语言那样在运行时优化代码。
- 属性查找开销:Python对象的属性查找过程相对复杂,涉及多重查找机制,进一步拖慢了执行速度。
GIL与多线程限制
全局解释器锁(GIL)是导致Python多线程无法真正并发执行CPU密集型任务的主要原因。Python解释器在每执行100个opcode(操作码)时,会尝试进行线程切换。虽然可以通过sys.setcheckinterval()设置opcode的数量来调整线程切换的频率,但这并不能从根本上解决GIL带来的并发限制问题。
垃圾回收(GC)的性能影响
Python采用标记和分代的垃圾回收策略来管理内存。然而,垃圾回收过程会中断程序的正常执行,造成所谓的“顿卡”(stuttering)现象。在某些对性能要求极高的场景下,例如Instagram曾通过禁用Python的GC机制,成功提升了约10%的性能。这表明,在特定场景下,手动管理内存或优化GC策略可能带来显著的性能提升。
字典操作的性能优化策略
在处理字典(dict)时,根据数据的填充情况选择合适的编码方法至关重要。以下是两种常见的字典填充策略及其性能对比:
策略一:键检查法
这种方法通过显式检查键是否存在来决定是初始化还是更新值。代码逻辑清晰,但在高频率操作中,if char not in myDict的检查会带来额外的开销。
n = 16
myDict = {}
for i in range(0, n):
 char = 'abcd'[i%4]
 if char not in myDict:
  myDict[char] = 0
  myDict[char] += 1
  print(myDict)
策略二:异常处理法(EAFP)
Python推崇“请求原谅比请求许可更容易”(EAFP)的风格。通过try-except块捕获KeyError,在字典已填充的情况下,避免了显式的键检查,从而提升了执行速度。这种方法在字典填充率较高时表现更优。
n = 16
myDict = {}
for i in range(0, n):
 char = 'abcd'[i%4]
 try:
  myDict[char] += 1
 except KeyError:
  myDict[char] = 1
  print(myDict)
总结
理解Python的运行机制,如GIL、GC以及动态类型特性,有助于开发者写出更高效的代码。特别是在处理字典等高频数据结构时,选择合适的操作策略(如利用异常处理代替显式检查)可以显著提升程序性能。以上就是Python运行效率不高的问题及字典优化策略的详细内容,更多关于Python性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















