


优化Python AI代码性能:向量化运算与并行处理技巧
针对Python AI工程中常见的数据处理与模型推理吞吐瓶颈,本文深入剖析向量化运算与并行处理技术,提供从底层原理、代码重构到多核调度的系统化优化方案。
在人工智能与机器学习开发中,Python 凭借丰富的生态库成为了事实上的标准语言,但在处理大规模特征工程、高维嵌入检索和批量数据预处理时,Python 自身的解释执行机制与全局解释器锁(GIL)常常使计算吞吐量受限。解决这一性能瓶颈的关键路径并不是盲目用 C++ 重写整个业务,而是准确区分计算形态,将数据层面的逐元素循环重构为底层 C/SIMD 驱动的向量化运算,并在任务调度层面合理配置多进程、多线程与异步管道。
一、为什么原生循环缓慢:理解向量化的底层加速机制
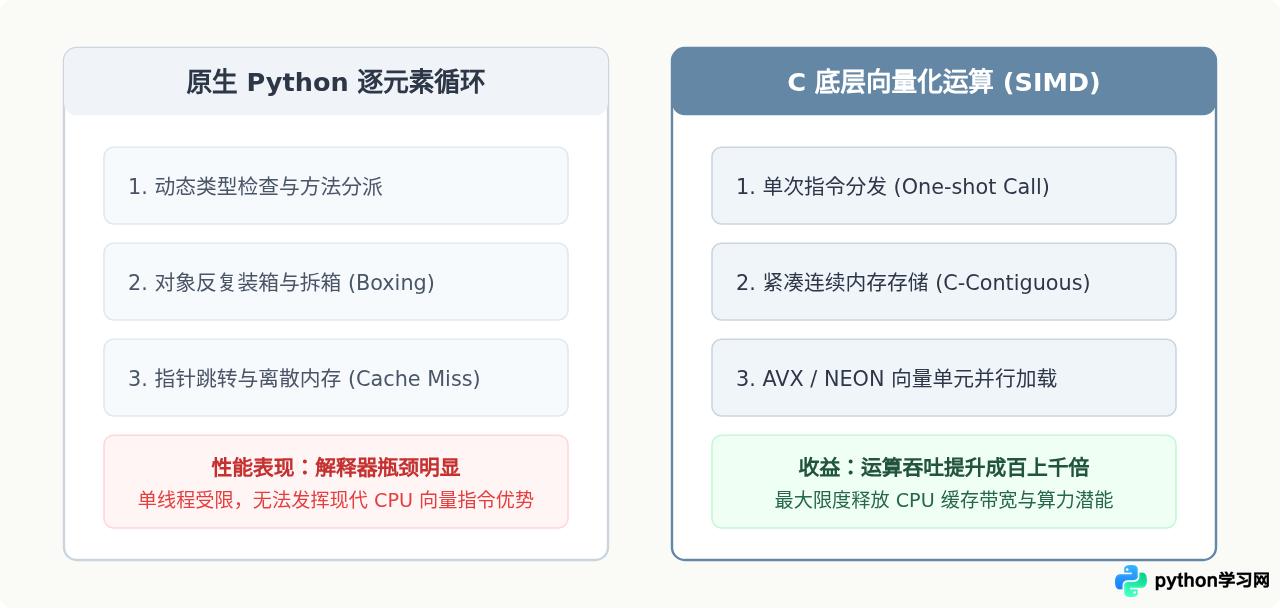
很多初学者在计算矩阵或向量特征时习惯直接使用 for 循环逐行遍历。在 Python 中,每个浮点数并不是简单的机器码数值,而是一个包装了引用计数、类型指针和数值实体的完整 PyObject 结构体。每次在循环体内执行加减乘除,解释器都要动态检查操作数类型、解包对象、调用对应方法并打包出新的临时对象,同时伴随大量的内存离散寻址与缓存未命中。
向量化(Vectorization)将这些繁琐的解释开销移交给底层的 C、Fortran 或 CUDA 内核。借助连续内存排布(Contiguous Array Buffer),CPU 可以利用单指令多数据(SIMD)扩展指令集(如 AVX-512、ARM NEON),在一个时钟周期内对多个数据通道同时施加相同的运算操作,从而获得数十倍甚至上百倍的计算吞吐提升。
二、向量化重构实操:消除循环与掌握广播机制
重构低效代码的核心策略在于:寻找代码中重复出现的四则运算、距离计算与条件赋值,改写为矩阵算子。以下通过一个常见的“批量计算文本嵌入(Embedding)余弦相似度”示例进行对比。
1. 典型低效写法与向量化改写对比
import numpy as np

# 假设 query_vec 是 1x512 的查询向量,corpus_matrix 是 10000x512 的知识库特征矩阵
query_vec = np.random.randn(512).astype(np.float32)
corpus_matrix = np.random.randn(10000, 512).astype(np.float32)

# 【低效写法】:使用 Python 原生 for 循环逐个计算点积与模长
def calc_similarity_loop(q, corpus):
    q_norm = np.sqrt(np.sum(q ** 2))
    scores = []
    for i in range(len(corpus)):
        doc = corpus[i]
        dot_product = 0.0
        doc_norm_sq = 0.0
        for j in range(len(q)):
            dot_product += q[j] * doc[j]
            doc_norm_sq += doc[j] * doc[j]
        doc_norm = np.sqrt(doc_norm_sq)
        scores.append(dot_product / (q_norm * doc_norm + 1e-8))
    return np.array(scores)

# 【高效写法】:完全基于广播与矩阵乘法的纯向量化重构
def calc_similarity_vectorized(q, corpus):
    q_norm = np.linalg.norm(q)
    corpus_norms = np.linalg.norm(corpus, axis=1)
    # 利用矩阵乘法 (N, D) @ (D,) 一次性计算所有点积,再通过广播除以模长
    dot_products = corpus @ q
    scores = dot_products / (corpus_norms * q_norm + 1e-8)
    return scores
实测表现提示:在 10,000 条 512 维向量的相似度匹配场景下,向量化版本相比双层嵌套循环版本通常能够取得 200 至 400 倍 的耗时削减,同时生成的代码更为紧凑易读。
2. 向量化优化的标准化实施流程
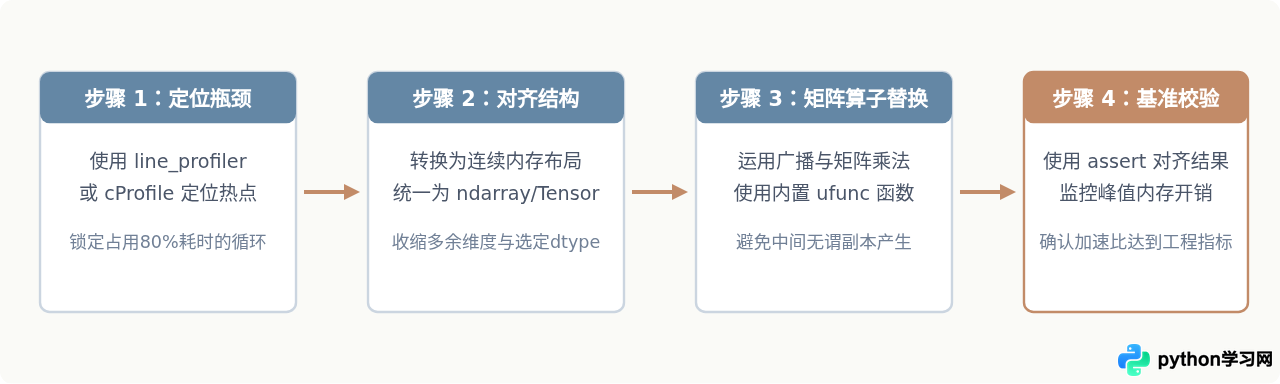
对已有 AI 模块进行向量化重构时,建议遵循固定的四个步骤,避免盲目重写引发内存溢出或计算精度漂移:
三、突破GIL瓶颈:多进程、多线程与异步并发技巧
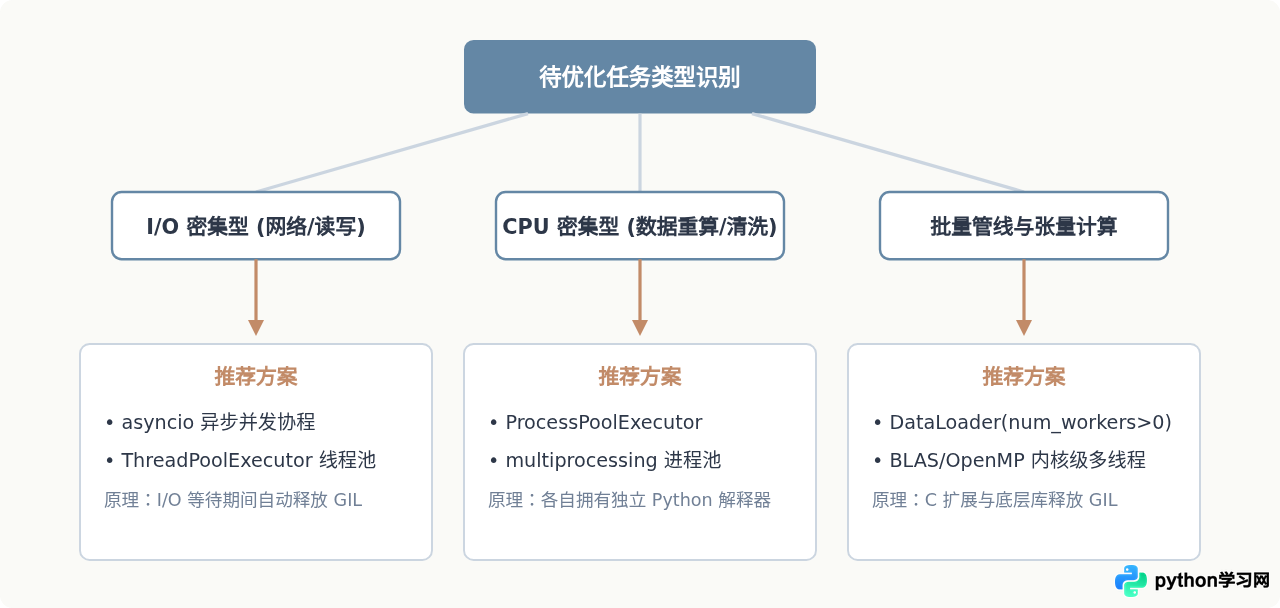
当单核向量化算力已经充分释放,或者任务本身涉及大规模文件解压、图片解码、分词处理等非纯矩阵计算时,必须引入并行机制。在 Python 中,全局解释器锁(GIL)确保同一时刻只有一个原生线程在执行 Python 字节码,因此必须依据任务特性选择正确的并行架构。
1. CPU 密集型任务:使用 ProcessPoolExecutor 进行多进程分片
对于无法完全转化为简单矩阵乘法的复杂算子(例如复杂的文本分词、自定义正则过滤与图像几何变换),可以使用 concurrent.futures.ProcessPoolExecutor 绕过 GIL 限制:
from concurrent.futures import ProcessPoolExecutor
import os

def clean_and_tokenize(batch_text_chunk):
    # 复杂单核数据清洗与分词逻辑
    cleaned = []
    for item in batch_text_chunk:
        tokens = [token.strip().lower() for token in item.split(" ") if token]
        cleaned.append(tokens)
    return cleaned

def parallel_text_processing(all_corpus, max_workers=None):
    if max_workers is None:
        max_workers = os.cpu_count() or 4

    # 按照 worker 数量将整个语料均匀分块(Chunking),减少跨进程通信开销
    chunk_size = max(1, len(all_corpus) // max_workers)
    chunks = [all_corpus[i:i + chunk_size] for i in range(0, len(all_corpus), chunk_size)]

    results = []
    with ProcessPoolExecutor(max_workers=max_workers) as executor:
        for processed_chunk in executor.map(clean_and_tokenize, chunks):
            results.extend(processed_chunk)
    return results
2. PyTorch 训练流水线并行:正确配置 DataLoader 与 pin_memory
在深度学习模型训练中,GPU 的实际利用率经常因为数据输入流卡顿而暴跌。PyTorch 的 DataLoader 已经内置了优秀的多进程预处理管道,但参数配置不当很容易适得其反:
- num_workers:建议设置为
GPU数量 * 4到物理 CPU 核心数之间,并非越大越好。线程与进程过多会引发 CPU 频繁上下文切换与内存争抢。 - pin_memory=True:当使用 CUDA 设备训练时,开启锁页内存可以让张量直接通过 DMA(直接内存访问)通道异步拷贝到 GPU 显存,无需经过分页内存中转。
- persistent_workers=True:当每个 Epoch 耗时较短时,开启此选项能够保持工作子进程常驻,避免在每个 Epoch 结束时反复销毁与重建进程池。
四、混合优化实践与三大避坑要点
在追求极端性能的过程中,经常出现“优化后反而更慢”的情况。以下是 AI 工程落地中最为典型的三处陷阱与应对策略:
| 常见负优化模式 | 根本原因 | 正确应对策略 |
|---|---|---|
| 在多进程内调用 OpenBLAS / MKL 矩阵运算 | NumPy 底层默认开启多线程,外层多进程与内层多线程互相嵌套,导致几百个线程争抢 CPU 时间片,出现严重的伪争用(Thrashing)。 | 在脚本开头设置环境变量 export OMP_NUM_THREADS=1,限制底层库为单线程,将全部并行度交给外层进程池管理。 |
| 子进程之间频繁传递巨型 NumPy 数组 | multiprocessing 默认通过 pickle 序列化对象,跨进程通信(IPC)拷贝几 GB 数据会彻底抵消并行带来的加速收益。 |
使用 multiprocessing.shared_memory 或基于文件的内存映射 np.memmap,让多个进程直接只读共享同一块物理内存。 |
循环体内动态 append 再转 np.array |
Python 列表动态扩容频繁触发内存 realloc,最后转换又全量深拷贝一次数据。 | 进入计算前预先用 np.empty 或 np.zeros 分配好固定大小的连续内存,通过索引直接写入切片。 |
五、总结
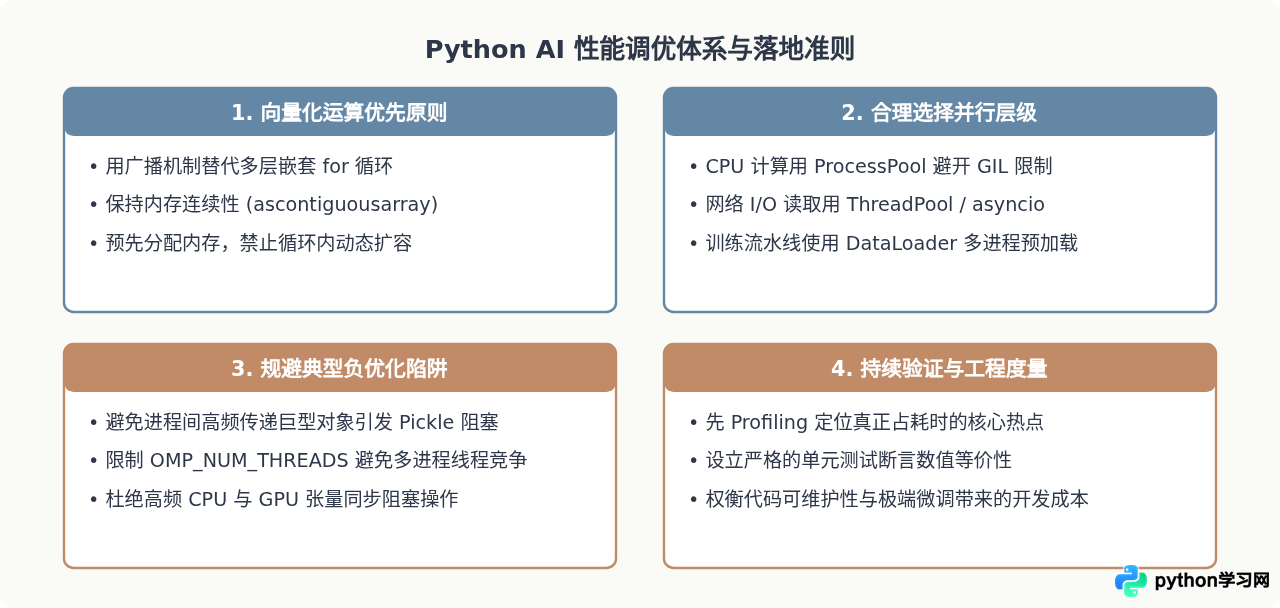
优化 Python AI 代码性能的关键并不是抛弃 Python,而是让 Python 专注扮演调度者与粘合剂角色。通过将关键计算重构为基于连续内存与底层 SIMD 指令的向量化算子,可以解决单核瓶颈;随后根据任务的 I/O 或 CPU 密集属性,选择匹配的进程池或异步管线,从而在保持 Python 极高研发效率的同时,达到接近原生高性能计算语言的运行吞吐。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















