


Scrapy实现批量运行爬虫文件的两种方案

Scrapy批量运行爬虫文件主要有两种实现方式:一是直接修改CrawProcess源码中的run()方法,二是通过创建自定义命令目录并继承修改源码。本文将详细解析这两种方案的操作步骤与代码实现。
方法一:修改CrawProcess源码
Scrapy的爬虫运行核心在于CrawProcess类中的run()方法。默认情况下,该方法通过crawler_process.crawl运行单个爬虫,spname参数代表爬虫名。若要实现批量运行,需修改此方法以获取并遍历所有已注册的爬虫。
1. 修改run()方法
首先,定位到crawl.py文件中的run()方法。默认代码逻辑如下:
def run(self, args, opts):
    if len(args) < 1:
      raise UsageError()
    elif len(args) > 1:
      raise UsageError("running 'scrapy crawl' with more than one spider is no longer supported")
    spname = args[0]

    self.crawler_process.crawl(spname, **opts.spargs)
    self.crawler_process.start()
为实现批量运行,需修改run()方法,通过crawler_process.spider_loader.list()获取所有爬虫名称,并遍历执行:
#修改后的run() 方法
def run(self, args, opts):
    #获取爬虫列表
    spd_loader_list = self.crawler_process.spider_loader.list()
    #遍历各爬虫
    for spname in spd_loader_list or args:
      self.crawler_process.crawl(spname, **opts.spargs)
      print("此时启动的爬虫:"+spname)
    self.crawler_process.start()
2. 添加简短描述
在修改后的代码中,建议添加short_desc()方法以明确命令功能:
def short_desc(self):
    return "Run all spider"
3. 执行命令
修改完成后,可通过以下命令启动所有爬虫:
scrapy mycrawl --nolog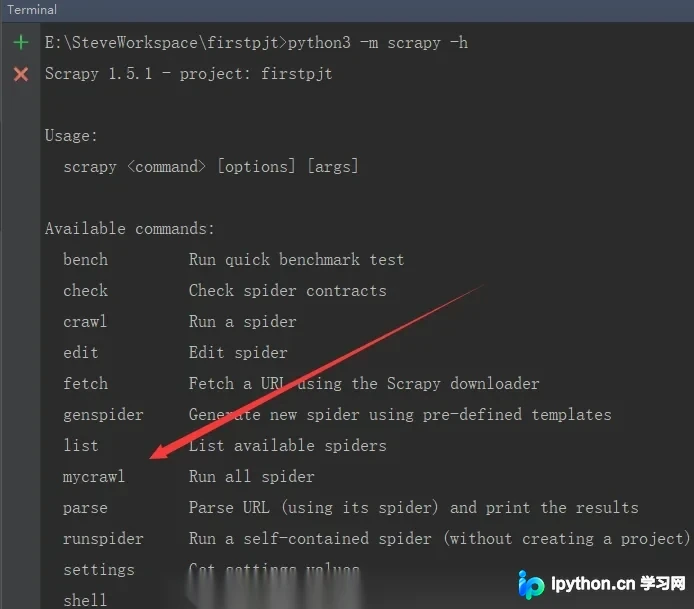
方法二:自定义命令(推荐)
为避免直接修改Scrapy源码带来的维护问题,推荐通过创建自定义命令目录来实现批量运行。该方法结构清晰,易于扩展。
1. 创建命令目录
在爬虫项目同级目录下,创建名为mycmd的文件夹。在该文件夹下创建mycrawl.py文件,并将上述修改后的run()方法代码复制至该文件中。
2. 添加初始化文件
在mycmd文件夹下添加__init__.py文件,使其成为一个Python包。
3. 配置setting.py
在项目根目录的setting.py文件中,添加COMMANDS_MODULE配置项。配置格式为“项目核心目录.自定义命令源码目录”,例如:
COMMANDS_MODULE = 'firstpjt.mycmd'4. 验证与执行
配置完成后,执行以下命令检查自定义命令是否生效:
scrapy -h若输出中包含mycrawl命令,则说明配置成功。此时,使用命令scrapy mycrawl --nolog即可同时启动多个爬虫文件。
总结
通过修改CrawProcess源码或创建自定义命令,均可实现Scrapy爬虫的批量运行。自定义命令方式结构更清晰,推荐在实际项目中使用。以上就是Scrapy爬虫文件批量运行的详细内容,更多关于Scrapy爬虫配置的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















