


pandas处理csv文件的方法步骤

发布时间:2026-10-11 |
2人浏览过
本文详细介绍如何使用pandas库高效处理CSV文件。涵盖指定编码(如GBK)读取数据、日期字段类型转换、多列字符串拼接、基于符号的数值计算、数据分组聚合以及去重保存等核心操作步骤,帮助开发者快速完成数据清洗任务。
pandas处理csv文件的方法步骤
在使用Python进行数据分析时,处理CSV文件是常见的需求。pandas库提供了强大的功能来读取、清洗和保存数据。以下是处理CSV文件的关键步骤和代码示例。
1. 读取CSV文件并处理编码
当CSV文件使用特定编码(如GBK)时,读取时必须指定encoding参数,否则可能导致乱码或读取失败。对于UTF-8编码的文件,通常可以不指定编码。
import pandas as pd
import numpy as np

# 读取数据,指定编码为gbk
filename = "test.csv"
data = pd.read_csv(filename, encoding='gbk')
2. 数据类型转换
原始数据中的日期字段可能以整数形式存储,需要转换为字符串以便后续处理。可以使用apply方法将指定列转换为字符串类型。
# 将日期这一列转为字符串
data['日期'] = data['日期'].apply(str)
3. 字符串拼接与数值计算
pandas支持对字符串列进行拼接操作,也可以结合numpy进行数值计算。例如,将营业部名称、日期和股票代码拼接成一个新的标识列,并根据买卖序号的符号计算买入金额。
# 拼接:营业部名称+日期+股票代码
data['name_date_code'] = data['营业部名称'] + data['日期'] + data['股票代码']

# 取"买卖序号"的符号和买入金额相乘
# np.sign 获取序号对应的符号
data['buy'] = np.sign(data['买卖序号']) * data['买入金额']
4. 数据清洗与聚合
在计算完成后,可以删除不需要的原始列,并根据新的标识列进行分组聚合。使用groupby和sum方法将相同标识行的金额相加,并将结果映射回原数据。最后,删除中间列并去除重复行。
# 删除不需要的列
data = data.drop(['营业部名称', '日期', '买卖序号', '股票名', '买入金额', '股票代码', 'data_stock'], axis=1)

# 将 name_date_code 相同的行,金额相加
buy_sum = data.groupby('name_date_code')['buy'].sum()
# 将相加的金额加入数据data,缺失数据用0填充
data['buy_sum'] = data.loc[:, 'name_date_code'].map(buy_sum).fillna(0)
# 将买入金额删掉,只剩下两列数据
data = data.drop(['buy'], axis=1)
# 删除重复行
data = data.drop_duplicates()
5. 保存CSV文件
处理完成后,使用to_csv方法保存数据。同样需要注意指定编码格式,以确保文件在其他环境中能正确读取。
# 写入数据,同样需要注意指定编码格式
data.to_csv("YYBD_result.csv", encoding='gbk', index=False)
6. 查看数据
可以使用iloc方法查看特定行的数据,以验证处理结果。
# data.iloc 取一整行
print(data.iloc[0])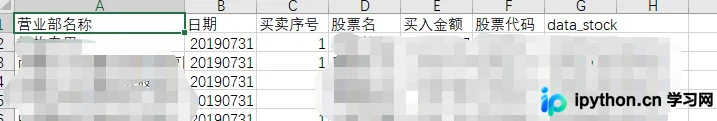
以上就是pandas处理csv文件的方法步骤的详细内容,更多关于pandas数据处理技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















