


Python fileinput模块全解析:从基础读取到高级钩子应用

本文深入解析Python内置模块fileinput,涵盖从标准输入、单文件到多文件的读取方式。详细讲解inplace参数实现原地修改、backup参数生成备份,以及openhook自定义钩子处理压缩文件和网络资源的高级用法。配合实际代码案例,展示如何利用fileinput高效处理日志分析与文本替换任务。
fileinput是Python标准库中的内置模块,尽管许多开发者对其并不熟悉,但它在特定场景下极具价值。本文将全面解析fileinput的各项功能与用法,并通过多个实用案例演示,帮助读者彻底掌握该模块的使用技巧。
1. 从标准输入中读取
当调用fileinput且未传入任何文件参数时,该模块默认将标准输入(stdin)作为数据源进行读取。
# demo.py
import fileinput

for line in fileinput.input():
    print(line)
运行效果显示,无论用户输入何种内容,程序都会自动读取并原样打印输出,行为类似于复读机。
$ python demo.py
hello
hello

python
python
2. 单独打开一个文件
若要单独处理一个文件,只需在fileinput.input()函数的files参数中指定该文件名即可。
import fileinput

with fileinput.input(files=('a.txt',)) as file:
    for line in file:
        print(f'{fileinput.filename()} 第{fileinput.lineno()}行: {line}', end='')
假设文件a.txt包含以下内容:
hello
world
执行上述代码后,输出结果如下:
$ python demo.py
a.txt 第1行: hello
a.txt 第2行: world
需要注意的是,fileinput.input()默认以mode='r'模式读取文件。若需处理二进制文件,可指定mode='rb'。fileinput仅支持这两种读取模式。
3. 批量打开多个文件
从前述示例可见,fileinput.input()函数的files参数可接收包含多个文件名的列表或元组。传入单个文件名时读取一个文件,传入多个文件名时则依次读取所有指定文件。
import fileinput

with fileinput.input(files=('a.txt', 'b.txt')) as file:
    for line in file:
        print(f'{fileinput.filename()} 第{fileinput.lineno()}行: {line}', end='')
假设a.txt和b.txt的内容分别为:
$ cat a.txt
hello
world
$ cat b.txt
hello
python
运行后输出结果如下。由于a.txt和b.txt的内容被合并为一个文件对象file,因此fileinput.lineno()在读取多个文件时返回的是累计行号,而非原文件的真实行号。
$ python demo.py
a.txt 第1行: hello
a.txt 第2行: world
b.txt 第3行: hello
b.txt 第4行: python
若需在读取多个文件时获取每个文件的真实行号,应使用fileinput.filelineno()方法。
import fileinput

with fileinput.input(files=('a.txt', 'b.txt')) as file:
    for line in file:
        print(f'{fileinput.filename()} 第{fileinput.filelineno()}行: {line}', end='')
运行后,输出结果如下:
$ python demo.py
a.txt 第1行: hello
a.txt 第2行: world
b.txt 第1行: hello
b.txt 第2行: python
此用法与glob模块结合使用效果极佳。
import fileinput
import glob

for line in fileinput.input(glob.glob("*.txt")):
    if fileinput.isfirstline():
        print('-'*20, f'Reading {fileinput.filename()}...', '-'*20)
    print(str(fileinput.lineno()) + ': ' + line.upper(), end="")
运行效果如下:
$ python demo.py
-------------------- Reading b.txt... --------------------
1: HELLO
2: PYTHON
-------------------- Reading a.txt... --------------------
3: HELLO
4: WORLD
4. 读取的同时备份文件
fileinput.input()提供了一个backup参数,用于指定备份文件的后缀名,例如设置为.bak。
import fileinput


with fileinput.input(files=("a.txt",), backup=".bak") as file:
    for line in file:
        print(f'{fileinput.filename()} 第{fileinput.lineno()}行: {line}', end='')
运行结果如下,系统会生成一个名为a.txt.bak的备份文件。
$ ls -l a.txt*
-rw-r--r--  1 MING  staff  12  2 27 10:43 a.txt

$ python demo.py
a.txt 第1行: hello
a.txt 第2行: world

$ ls -l a.txt*
-rw-r--r--  1 MING  staff  12  2 27 10:43 a.txt
-rw-r--r--  1 MING  staff  42  2 27 10:39 a.txt.bak
5. 标准输出重定向替换
fileinput.input()还有一个inplace参数,用于控制是否将标准输出的结果写回原文件,默认值为False(不取代)。
参考以下测试代码:
import fileinput

with fileinput.input(files=("a.txt",), inplace=True) as file:
    print("[INFO] task is started...")
    for line in file:
        print(f'{fileinput.filename()} 第{fileinput.lineno()}行: {line}', end='')
    print("[INFO] task is closed...")
运行后发现,for循环体内的print内容会被写回到原文件中,而循环体外的print语句输出则保持不变。
$ cat a.txt
hello
world

$ python demo.py
[INFO] task is started...
[INFO] task is closed...

$ cat a.txt
a.txt 第1行: hello
a.txt 第2行: world
利用这一机制,可以非常便捷地实现文本替换操作。
import sys
import fileinput

for line in fileinput.input(files=('a.txt', ), inplace=True):
    #将Windows/DOS格式下的文本文件转为Linux的文件
    if line[-2:] == "\r\n":
        line = line + "\n"
    sys.stdout.write(line)
附:如需进行DOS和UNIX格式互换以供程序测试,可使用vim输入以下指令:
DOS转UNIX::setfileformat=unix
UNIX转DOS::setfileformat=dos
6. 不得不介绍的方法
如果仅将fileinput视为替代open()读取文件的工具,前述内容已能满足基本需求。
- fileinput.filenam()
返回当前被读取的文件名。在第一行被读取之前,返回None。
- fileinput.fileno()
返回以整数表示的当前文件“文件描述符”。当未打开文件时(处于第一行和文件之间),返回-1。
- fileinput.lineno()
返回已被读取的累计行号。在第一行被读取之前,返回0。在最后一个文件的最后一行被读取之后,返回该行的行号。
- fileinput.filelineno()
返回当前文件中的行号。在第一行被读取之前,返回0。在最后一个文件的最后一行被读取之后,返回此文件中该行的行号。
若需基于fileinput实现更复杂的逻辑,可能需要用到以下方法:
- fileinput.isfirstline()
如果刚读取的行是其所在文件的第一行则返回True,否则返回False。
- fileinput.isstdin()
如果最后读取的行来自sys.stdin则返回True,否则返回False。
- fileinput.nextfile()
关闭当前文件,使下次迭代从下一个文件(如果存在)读取第一行;未从该文件读取的行不计入累计行数。直到下一个文件的第一行被读取后,文件名才会改变。在第一行被读取之前,此函数不生效;不能用于跳过第一个文件。在最后一个文件的最后一行被读取之后,此函数不再生效。
- fileinput.close()
关闭序列。
7. 进阶一点的玩法
在fileinput.input()中,openhook参数支持用户传入自定义的对象读取方法。
若未传入任何钩子,fileinput默认使用open()函数。
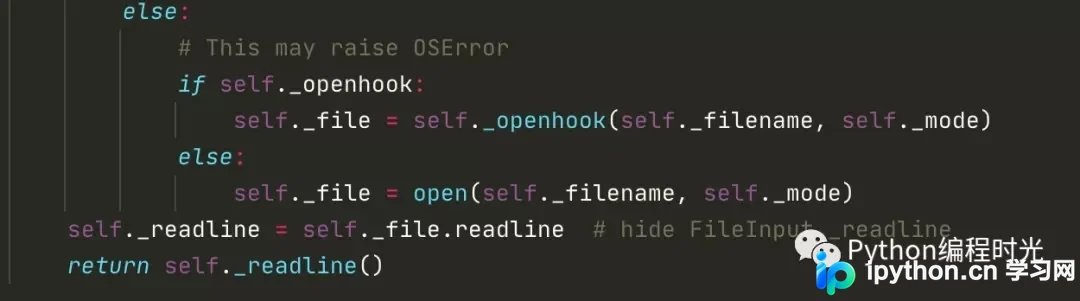
fileinput内置了两种钩子供用户选择:
- fileinput.hook_compressed(*filename*, *mode*)
使用gzip和bz2模块透明地打开gzip和bzip2压缩的文件(通过扩展名'.gz'和'.bz2'来识别)。如果文件扩展名不是'.gz'或'.bz2',文件会以正常方式打开(即使用open()并且不带任何解压操作)。使用示例: fi = fileinput.FileInput(openhook=fileinput.hook_compressed)
- fileinput.hook_encoded(*encoding*, *errors=None*)
返回一个通过open()打开每个文件的钩子,使用给定的encoding和errors来读取文件。使用示例: fi = fileinput.FileInput(openhook=fileinput.hook_encoded("utf-8", "surrogateescape"))
若用户场景特殊,上述三种钩子均无法满足需求,也可自定义钩子函数。
此处举一个例子抛砖引玉。
假设希望使用fileinput读取网络文件,可按如下方式定义钩子。
- 首先使用requests库将文件下载到本地。
- 然后使用open()函数读取该本地文件。
def online_open(url, mode):
    import requests
    r = requests.get(url)
    filename = url.split("/")[-1]
    with open(filename,'w') as f1:
        f1.write(r.content.decode("utf-8"))
    f2 = open(filename,'r')
    return f2
直接将该函数传递给openhook参数即可。
import fileinput

file_url = 'https://www.csdn.net/robots.txt'
with fileinput.input(files=(file_url,), openhook=online_open) as file:
    for line in file:
        print(line, end="")
运行后,按预期将CSDN的robots.txt文件内容打印出来。
User-agent: *
Disallow: /scripts
Disallow: /public
Disallow: /css/
Disallow: /images/
Disallow: /content/
Disallow: /ui/
Disallow: /js/
Disallow: /scripts/
Disallow: /article_preview.html*
Disallow: /tag/
Disallow: /*?*
Disallow: /link/

Sitemap: https://www.csdn.net/sitemap-aggpage-index.xml
Sitemap: https://www.csdn.net/article/sitemap.txt
8. 列举一些实用案例
案例一:读取一个文件所有行
import fileinput
for line in fileinput.input('data.txt'):
  print(line, end="")
案例二:读取多个文件所有行
import fileinput
import glob

for line in fileinput.input(glob.glob("*.txt")):
    if fileinput.isfirstline():
        print('-'*20, f'Reading {fileinput.filename()}...', '-'*20)
    print(str(fileinput.lineno()) + ': ' + line.upper(), end="")
案例三:利用fileinput将CRLF文件转为LF
import sys
import fileinput

for line in fileinput.input(files=('a.txt', ), inplace=True):
    #将Windows/DOS格式下的文本文件转为Linux的文件
    if line[-2:] == "\r\n":
        line = line + "\n"
    sys.stdout.write(line)
案例四:配合re做日志分析:取所有含日期的行
#--样本文件--:error.log
aaa
1970-01-01 13:45:30  Error: **** Due to System Disk spacke not enough...
bbb
1970-01-02 10:20:30  Error: **** Due to System Out of Memory...
ccc

#---测试脚本---
import re
import fileinput
import sys

pattern = '\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2}'

for line in fileinput.input('error.log',backup='.bak',inplace=1):
    if re.search(pattern,line):
        sys.stdout.write("=> ")
        sys.stdout.write(line)

#---测试结果---
=> 1970-01-01 13:45:30  Error: **** Due to System Disk spacke not enough...
=> 1970-01-02 10:20:30  Error: **** Due to System Out of Memory...
案例五:利用fileinput实现类似于grep的功能
import sys
import re
import fileinput

pattern= re.compile(sys.argv[1])
for line in fileinput.input(sys.argv[2]):
    if pattern.match(line):
        print(fileinput.filename(), fileinput.filelineno(), line)

$ ./demo.py import.*re *.py
#查找所有py文件中,含import re字样的
addressBook.py  2   import re
addressBook1.py 10  import re
addressBook2.py 18  import re
test.py         238 import re
9. 写在最后
fileinput是对open()函数的再次封装。在仅需读取数据的场景中,fileinput显然比open()更专业、更人性化;但在涉及写操作的复杂场景中,fileinput则无能为力。从模块命名即可看出,它专注于输入(读)而非输出(写)。
以上就是python 使用fileinput读取文件的详细内容,更多关于python 用fileinput读取文件的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















