


TensorFlow 2 实战:使用 Fashion-MNIST 与 TensorBoard 进行模型训练与可视化

本文详细介绍如何在 TensorFlow 2 中使用 Fashion-MNIST 数据集进行图像分类模型训练。通过 TensorBoard 记录训练过程,利用 tf.summary 和 metrics 模块监控损失与准确率,并展示完整的代码实现与训练输出结果,帮助开发者掌握模型调试与可视化的核心技巧。
概述
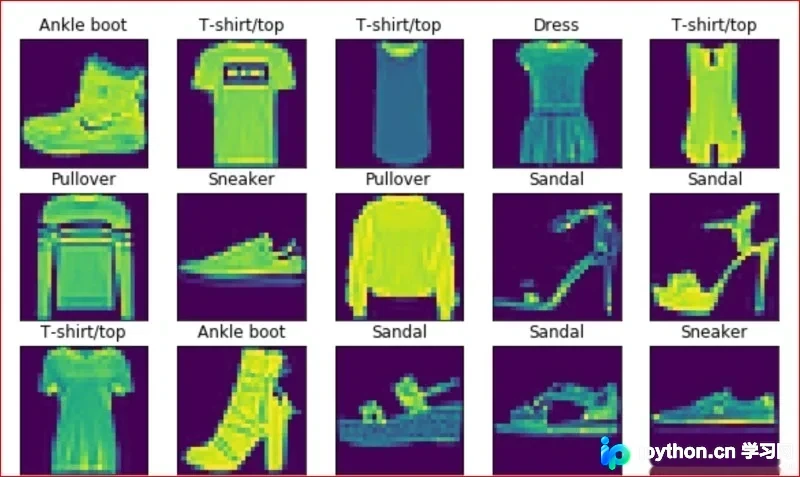
Fashion-MNIST 是一个与经典 MNIST 数据集类似的图像分类数据集,包含 10 个类别的 7 万张商品图片,其中 6 万张用于训练,1 万张用于测试。
TensorBoard 可视化工具
TensorBoard 是 TensorFlow 提供的强大可视化工具,用于监控和调试模型训练过程。
创建 Summary 记录器
我们可以调用 tf.summary.create_file_writer(file_path) 来创建一个新的 summary 文件写入器实例。
具体示例如下:
# 将当前时间作为子文件名
current_time = datetime.datetime.now().strftime("%Y%m%d-%H%M%S")

# 监听的文件的路径
log_dir = 'logs/' + current_time

# 创建writer
summary_writer = tf.summary.create_file_writer(log_dir)
存入训练数据
通过调用 tf.summary.scalar 函数,我们可以向 summary 对象中写入具体的标量数据。
函数格式如下:
tf.summary.scalar(
    name, data, step=None, description=None
)
示例代码:
with summary_writer.as_default():
    tf.summary.scalar("train-loss", float(Cross_Entropy), step=step)
指标计算
metrics.Mean() 用法
使用 metrics.Mean() 可以帮助我们计算并跟踪平均值指标。
格式说明:
tf.keras.metrics.Mean(
    name='mean', dtype=None
)
示例代码:
# 准确率表
loss_meter = tf.keras.metrics.Mean()
metrics.Accuracy() 用法
格式说明:
tf.keras.metrics.Accuracy(
    name='accuracy', dtype=None
)
示例代码:
# 损失表
acc_meter = tf.keras.metrics.Accuracy()
变量更新与重置
我们可以通过调用 update_state 方法来实现变量的状态更新,并通过调用 rest_state 方法来实现变量的重置。
例如:
# 跟新损失
loss_meter.update_state(Cross_Entropy)

# 重置
loss_meter.reset_state()
完整案例演示
pre_process 预处理函数
def pre_process(x, y):
    """
    数据预处理
    :param x: 特征值
    :param y: 目标值
    :return: 返回处理好的x, y
    """
    # 转换x
    x = tf.cast(x, tf.float32) / 255
    x = tf.reshape(x, [-1, 784])

    # 转换y
    y = tf.cast(y, dtype=tf.int32)
    y = tf.one_hot(y, depth=10)

    return x, y
get_data 数据加载函数
def get_data():
    """
    获取数据
    :return: 返回分批完的训练集和测试集
    """

    # 获取数据
    (X_train, y_train), (X_test, y_test) = tf.keras.datasets.fashion_mnist.load_data()

    # 分割训练集
    train_db = tf.data.Dataset.from_tensor_slices((X_train, y_train)).shuffle(60000, seed=0)
    train_db = train_db.batch(batch_size).map(pre_process)

    # 分割测试集
    test_db = tf.data.Dataset.from_tensor_slices((X_test, y_test)).shuffle(10000, seed=0)
    test_db = test_db.batch(batch_size).map(pre_process)

    # 返回
    return train_db, test_db
train 训练函数
def train(epoch, train_db):
    """
    训练数据
    :param train_db: 分批的数据集
    :return: 无返回值
    """
    for step, (x, y) in enumerate(train_db):
        with tf.GradientTape() as tape:

            # 获取模型输出结果
            logits = model(x)

            # 计算交叉熵
            Cross_Entropy = tf.losses.categorical_crossentropy(y, logits, from_logits=True)
            Cross_Entropy = tf.reduce_sum(Cross_Entropy)

            # 跟新损失
            loss_meter.update_state(Cross_Entropy)

        # 计算梯度
        grads = tape.gradient(Cross_Entropy, model.trainable_variables)

        # 跟新参数
        optimizer.apply_gradients(zip(grads, model.trainable_variables))

        # 每100批调试输出一下误差
        if step % 100 == 0:
            print("step:", step, "Cross_Entropy:", loss_meter.result().numpy())

            # 重置
            loss_meter.reset_state()

            # 可视化
            with summary_writer.as_default():
                tf.summary.scalar("train-loss", float(Cross_Entropy), step= epoch * 235 + step)
test 测试函数
def test(epoch, test_db):
    """
    测试模型
    :param epoch: 轮数
    :param test_db: 分批的测试集
    :return: 无返回值
    """

    # 重置
    acc_meter.reset_state()

    for x, y in test_db:
        # 获取模型输出结果
        logits = model(x)

        # 预测结果
        pred = tf.argmax(logits, axis=1)

        # 从one_hot编码变回来
        y = tf.argmax(y, axis=1)

        # 计算准确率
        acc_meter.update_state(y, pred)

    # 调试输出
    print("epoch:", epoch + 1, "Accuracy:", acc_meter.result().numpy() * 100, "%", )

    # 可视化
    with summary_writer.as_default():
        tf.summary.scalar("val-acc", acc_meter.result().numpy(), step=epoch * 235)
main 主程序入口
def main():
    """
    主函数
    :return: 无返回值
    """

    # 获取数据
    train_db, test_db = get_data()

    # 轮期
    for epoch in range(iteration_num):
        train(epoch, train_db)
        test(epoch, test_db)
完整代码实现
import datetime
import tensorflow as tf

# 定义超参数
batch_size = 256  # 一次训练的样本数目
learning_rate = 0.001  # 学习率
iteration_num = 20  # 迭代次数

# 优化器
optimizer = tf.keras.optimizers.Adam(learning_rate=learning_rate)

# 准确率表
loss_meter = tf.keras.metrics.Mean()

# 损失表
acc_meter = tf.keras.metrics.Accuracy()

# 可视化
current_time = datetime.datetime.now().strftime("%Y%m%d-%H%M%S")
log_dir = 'logs/' + current_time
summary_writer = tf.summary.create_file_writer(log_dir)  # 创建writer

# 模型
model = tf.keras.Sequential([
    tf.keras.layers.Dense(256, activation=tf.nn.relu),
    tf.keras.layers.Dense(128, activation=tf.nn.relu),
    tf.keras.layers.Dense(64, activation=tf.nn.relu),
    tf.keras.layers.Dense(32, activation=tf.nn.relu),
    tf.keras.layers.Dense(10)
])

# 调试输出summary
model.build(input_shape=[None, 28 * 28])
print(model.summary())


def pre_process(x, y):
    """
    数据预处理
    :param x: 特征值
    :param y: 目标值
    :return: 返回处理好的x, y
    """
    # 转换x
    x = tf.cast(x, tf.float32) / 255
    x = tf.reshape(x, [-1, 784])

    # 转换y
    y = tf.cast(y, dtype=tf.int32)
    y = tf.one_hot(y, depth=10)

    return x, y


def get_data():
    """
    获取数据
    :return: 返回分批完的训练集和测试集
    """

    # 获取数据
    (X_train, y_train), (X_test, y_test) = tf.keras.datasets.fashion_mnist.load_data()

    # 分割训练集
    train_db = tf.data.Dataset.from_tensor_slices((X_train, y_train)).shuffle(60000, seed=0)
    train_db = train_db.batch(batch_size).map(pre_process)

    # 分割测试集
    test_db = tf.data.Dataset.from_tensor_slices((X_test, y_test)).shuffle(10000, seed=0)
    test_db = test_db.batch(batch_size).map(pre_process)

    # 返回
    return train_db, test_db


def train(epoch, train_db):
    """
    训练数据
    :param train_db: 分批的数据集
    :return: 无返回值
    """
    for step, (x, y) in enumerate(train_db):
        with tf.GradientTape() as tape:

            # 获取模型输出结果
            logits = model(x)

            # 计算交叉熵
            Cross_Entropy = tf.losses.categorical_crossentropy(y, logits, from_logits=True)
            Cross_Entropy = tf.reduce_sum(Cross_Entropy)

            # 跟新损失
            loss_meter.update_state(Cross_Entropy)

        # 计算梯度
        grads = tape.gradient(Cross_Entropy, model.trainable_variables)

        # 跟新参数
        optimizer.apply_gradients(zip(grads, model.trainable_variables))

        # 每100批调试输出一下误差
        if step % 100 == 0:
            print("step:", step, "Cross_Entropy:", loss_meter.result().numpy())

            # 重置
            loss_meter.reset_state()

            # 可视化
            with summary_writer.as_default():
                tf.summary.scalar("train-loss", float(Cross_Entropy), step=epoch * 235 + step)


def test(epoch, test_db):
    """
    测试模型
    :param epoch: 轮数
    :param test_db: 分批的测试集
    :return: 无返回值
    """

    # 重置
    acc_meter.reset_state()

    for x, y in test_db:
        # 获取模型输出结果
        logits = model(x)

        # 预测结果
        pred = tf.argmax(logits, axis=1)

        # 从one_hot编码变回来
        y = tf.argmax(y, axis=1)

        # 计算准确率
        acc_meter.update_state(y, pred)

    # 调试输出
    print("epoch:", epoch + 1, "Accuracy:", acc_meter.result().numpy() * 100, "%", )

    # 可视化
    with summary_writer.as_default():
        tf.summary.scalar("val-acc", acc_meter.result().numpy(), step=epoch * 235)


def main():
    """
    主函数
    :return: 无返回值
    """

    # 获取数据
    train_db, test_db = get_data()

    # 轮期
    for epoch in range(iteration_num):
        train(epoch, train_db)
        test(epoch, test_db)


if __name__ == "__main__":
    main()
程序运行输出结果如下:
Model: "sequential" _________________________________________________________________ Layer (type) Output Shape Param # ================================================================= dense (Dense) (None, 256) 200960 _________________________________________________________________ dense_1 (Dense) (None, 128) 32896 _________________________________________________________________ dense_2 (Dense) (None, 64) 8256 _________________________________________________________________ dense_3 (Dense) (None, 32) 2080 _________________________________________________________________ dense_4 (Dense) (None, 10) 330 ================================================================= Total params: 244,522 Trainable params: 244,522 Non-trainable params: 0 _________________________________________________________________ None 2021-06-14 18:01:27.399812: I tensorflow/compiler/mlir/mlir_graph_optimization_pass.cc:176] None of the MLIR Optimization Passes are enabled (registered 2) step: 0 Cross_Entropy: 591.5974 step: 100 Cross_Entropy: 196.49309 step: 200 Cross_Entropy: 125.2562 epoch: 1 Accuracy: 84.72999930381775 % step: 0 Cross_Entropy: 107.64579 step: 100 Cross_Entropy: 105.854385 step: 200 Cross_Entropy: 99.545975 epoch: 2 Accuracy: 85.83999872207642 % step: 0 Cross_Entropy: 95.42945 step: 100 Cross_Entropy: 91.366234 step: 200 Cross_Entropy: 90.84072 epoch: 3 Accuracy: 86.69999837875366 % step: 0 Cross_Entropy: 82.03317 step: 100 Cross_Entropy: 83.20552 step: 200 Cross_Entropy: 81.57012 epoch: 4 Accuracy: 86.11000180244446 % step: 0 Cross_Entropy: 82.94046 step: 100 Cross_Entropy: 77.56677 step: 200 Cross_Entropy: 76.996346 epoch: 5 Accuracy: 87.27999925613403 % step: 0 Cross_Entropy: 75.59219 step: 100 Cross_Entropy: 71.70899 step: 200 Cross_Entropy: 74.15144 epoch: 6 Accuracy: 87.29000091552734 % step: 0 Cross_Entropy: 76.65844 step: 100 Cross_Entropy: 70.09151 step: 200 Cross_Entropy: 70.84446 epoch: 7 Accuracy: 88.27999830245972 % step: 0 Cross_Entropy: 67.50707 step: 100 Cross_Entropy: 64.85907 step: 200 Cross_Entropy: 68.63099 epoch: 8 Accuracy: 88.41999769210815 % step: 0 Cross_Entropy: 65.50318 step: 100 Cross_Entropy: 62.2706 step: 200 Cross_Entropy: 63.80803 epoch: 9 Accuracy: 86.21000051498413 % step: 0 Cross_Entropy: 66.95486 step: 100 Cross_Entropy: 61.84385 step: 200 Cross_Entropy: 62.18851 epoch: 10 Accuracy: 88.45999836921692 % step: 0 Cross_Entropy: 59.779297 step: 100 Cross_Entropy: 58.602314 step: 200 Cross_Entropy: 59.837025 epoch: 11 Accuracy: 88.66000175476074 % step: 0 Cross_Entropy: 58.10068 step: 100 Cross_Entropy: 55.097878 step: 200 Cross_Entropy: 59.906315 epoch: 12 Accuracy: 88.70999813079834 % step: 0 Cross_Entropy: 57.584858 step: 100 Cross_Entropy: 54.95376 step: 200 Cross_Entropy: 55.797752 epoch: 13 Accuracy: 88.44000101089478 % step: 0 Cross_Entropy: 53.54782 step: 100 Cross_Entropy: 53.62939 step: 200 Cross_Entropy: 54.632828 epoch: 14 Accuracy: 87.02999949455261 % step: 0 Cross_Entropy: 54.387398 step: 100 Cross_Entropy: 52.323734 step: 200 Cross_Entropy: 53.968185 epoch: 15 Accuracy: 88.98000121116638 % step: 0 Cross_Entropy: 50.468914 step: 100 Cross_Entropy: 50.79311 step: 200 Cross_Entropy: 51.296227 epoch: 16 Accuracy: 88.67999911308289 % step: 0 Cross_Entropy: 48.753258 step: 100 Cross_Entropy: 46.809692 step: 200 Cross_Entropy: 48.08208 epoch: 17 Accuracy: 89.10999894142151 % step: 0 Cross_Entropy: 46.830627 step: 100 Cross_Entropy: 47.208813 step: 200 Cross_Entropy: 48.671318 epoch: 18 Accuracy: 88.77999782562256 % step: 0 Cross_Entropy: 46.15514 step: 100 Cross_Entropy: 45.026627 step: 200 Cross_Entropy: 45.371685 epoch: 19 Accuracy: 88.7399971485138 % step: 0 Cross_Entropy: 47.696465 step: 100 Cross_Entropy: 41.52749 step: 200 Cross_Entropy: 46.71362 epoch: 20 Accuracy: 89.56000208854675 %
可视化总结
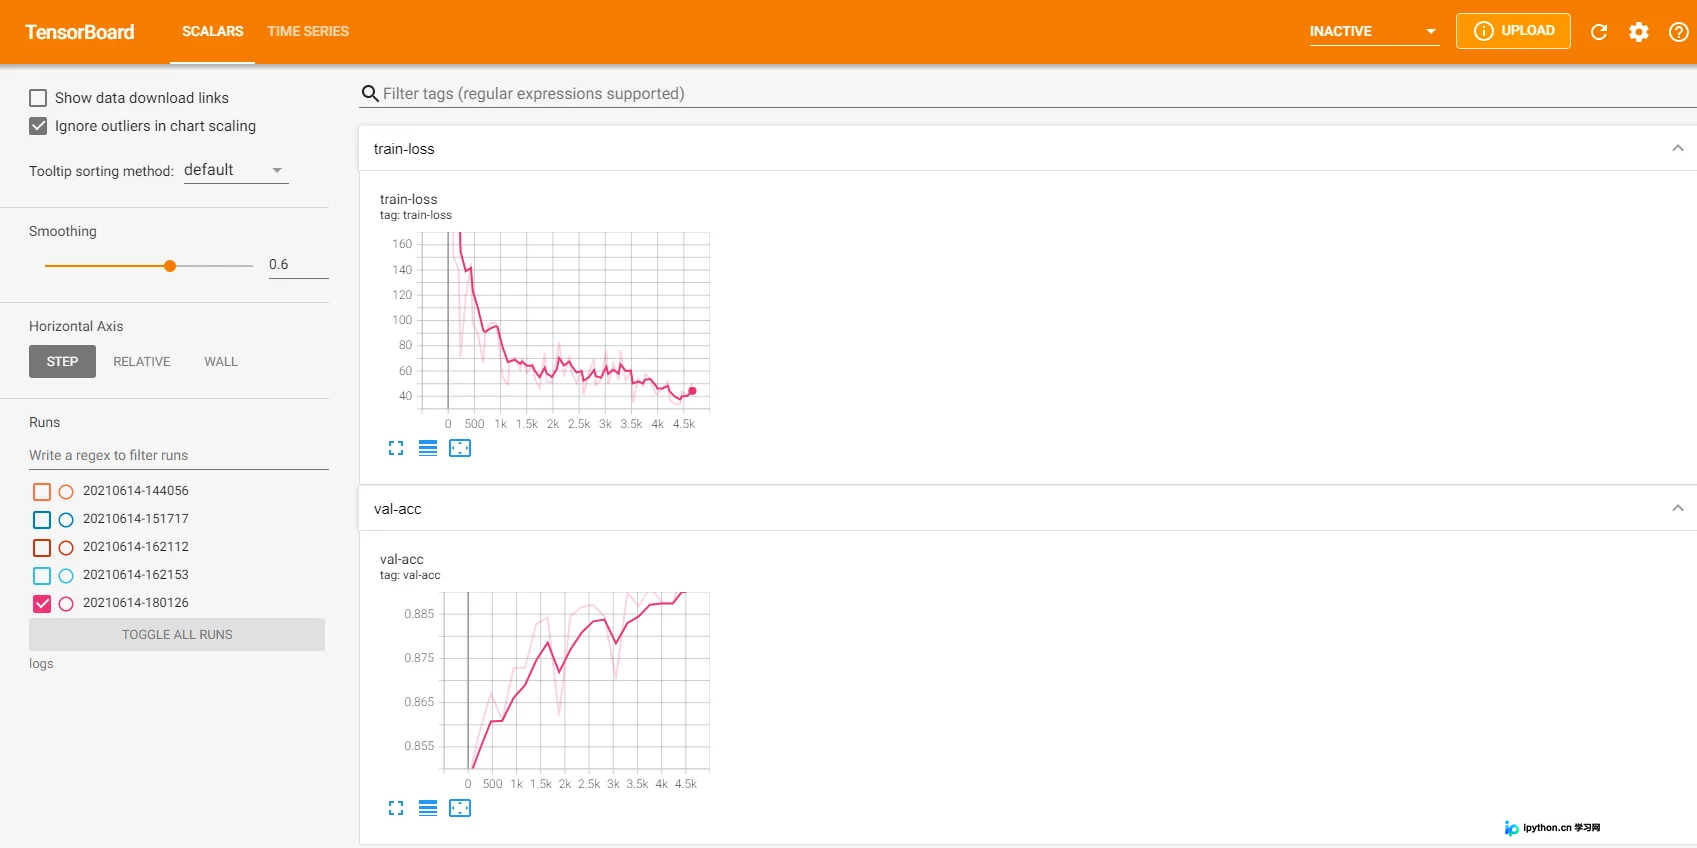
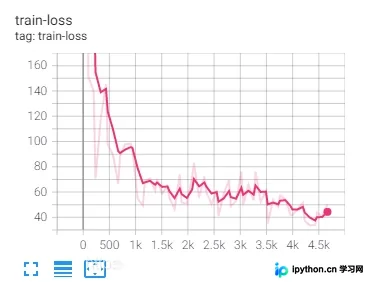
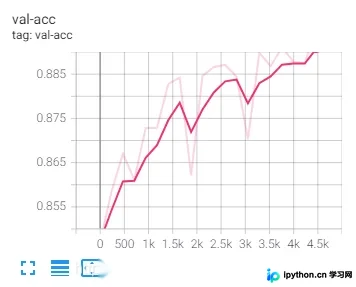
至此,关于一小时学会 TensorFlow 2 结合 Fashion-MNIST 数据集进行模型训练与可视化的介绍已完成。如需了解更多 TensorFlow 2 与 Fashion-MNIST 相关内容,请搜索本站往期文章或继续浏览后续教程。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















