


深度解析Numba与Cython:Python性能优化的双引擎策略

本文深入对比Numba与Cython两大Python加速工具。解析Numba通过JIT将Python转为LLVM IR实现自动并行与GPU支持的优势,以及Cython通过生成C代码提供底层控制的特性。分析两者在易用性、调试难度及适用场景上的差异,帮助开发者根据项目规模选择最佳性能优化方案。
Numba
Numba是一个即时(JIT)编译器,它能够将Python代码转换为针对CPU和GPU优化的本地机器指令。其编译时机灵活,支持在模块导入时、程序运行时或预先进行编译。
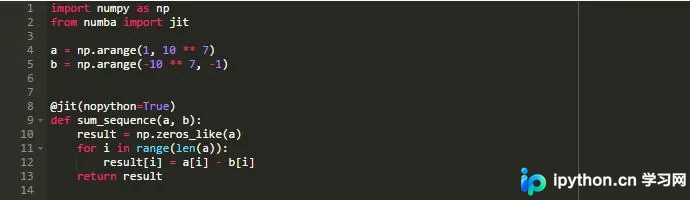
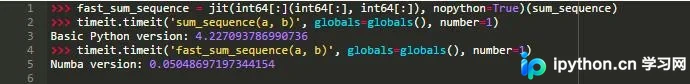
借助jit装饰器,开发者可以非常便捷地使用Numba功能:
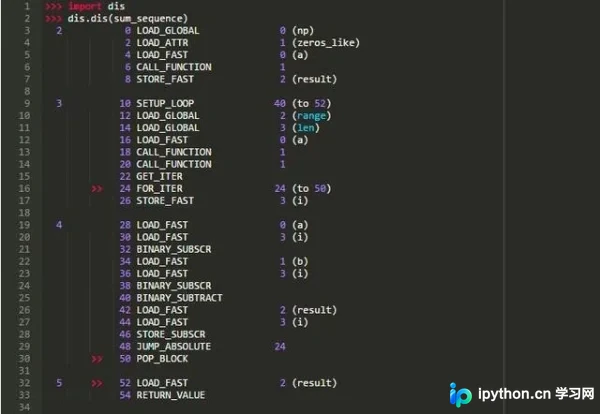
正如你所知,在Python中,所有代码块在解释执行前都会被编译成字节码:
代码优化
为了优化Python代码,Numba会从提供的函数中提取字节码,并运行一系列分析器。由于Python字节码由一系列细小且简单的指令组成,无需依赖Python源代码即可从字节码中重构函数的逻辑。尽管转换过程涉及多个阶段,但Numba的核心机制是将Python字节码转换为LLVM中间表示(IR)。
请注意,LLVM IR是一种低级编程语言,其语法类似于汇编语言,与Python本身无直接关联。
Numba 模式
Numba提供两种运行模式:nopython模式和object模式。nopython模式不依赖Python运行时环境,能够生成无Python依赖的原生代码;该模式下的原生代码具有静态类型特性,运行速度极快。相比之下,object模式依赖Python对象和Python C API,通常无法带来显著的性能提升。在这两种模式下,Python代码均通过LLVM进行编译。
什么是LLVM?
LLVM是一种编译器框架,它接收代码的特殊中间表示(IR),并将其编译为本机代码。编译过程包含多个额外的传递阶段,编译器会在这些阶段对IR进行优化。LLVM工具链对IR的优化效果极佳,不仅服务于Numba的代码编译,也反向优化Numba自身的运行。整个系统架构大致如下:
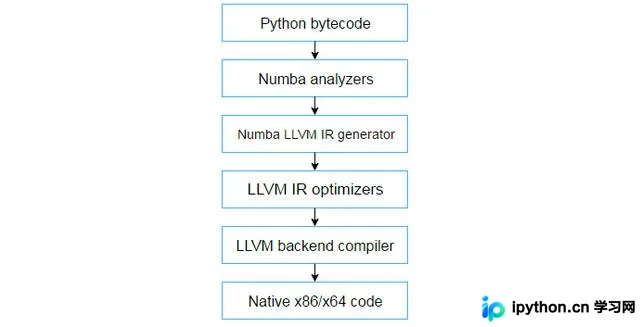
Python numba 体系结构
Numba的优势:
- 易用性
- 自动并行化
- 支持numpy操作和对象
- GPU支持
Numba的劣势:
多层抽象机制使得调试和优化过程变得相当困难。
在nopython模式下,代码无法与Python解释器及其标准模块进行交互。
对类的支持有限。
Cython
与Numba分析字节码并生成IR不同,Cython使用Python语法的超集,随后将其转换为C代码。使用Cython时,本质上是用高级Python语法编写C代码。
在使用Cython时,开发者通常无需担心Python包装器和低级API调用,因为所有交互都会自动扩展为合适的C代码。
与Numba不同,所有Cython代码必须编写在专门的文件中,并与常规Python代码分离。Cython会将这些文件解析并转换为C代码,然后使用提供的C编译器(例如gcc)进行编译。
标准的Python代码已经是有效的Cython代码。
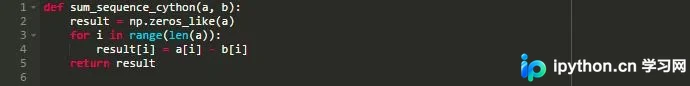
但是,添加类型声明的版本运行速度更快。
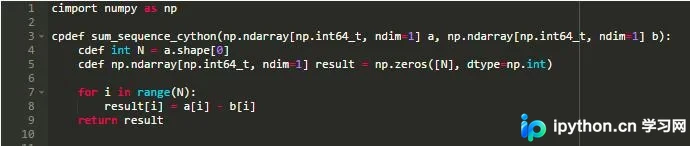
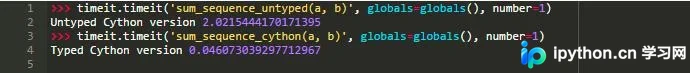
编写高性能的Cython代码需要深入理解C和Python的内部机制。如果你熟悉C语言,你的Cython代码可以运行得与原生C代码一样快。
Cython的优势:
- 通过Python API的使用实现精细控制
- 与C/C++库及C/C++代码的简单接口
- 支持并行执行
- 支持Python类,在C层面提供面向对象特性
Cython的劣势:
- 学习曲线较陡峭
- 需要具备C和Python内部机制的专业知识
- 模块组织结构不够方便
Numba 对 Cython
就个人经验而言,对于小型项目和ETL(提取、转换、加载)实验,我更倾向于使用Numba,因为它可以无缝插入现有项目中。如果启动大型项目或需要为C库编写包装器,我会选择Cython,因为它提供了更多的控制权和更易于调试的环境。
此外,Cython是许多主流库的标准配置,包括pandas、scikit-learn、scipy、Spacy、gensim和lxml。
以上就是利用Numba与Cython结合提升python运行效率详解的详细内容,更多关于提升python运行效率的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















